
Hebbiansk læring møder Hopfield-netværk: Arkitekturen, der hele tiden var klogere end transformere
I det seneste årti har transformere og deres opmærksomhedsmekanismer domineret AI-landskabet. Fra GPT til BERT til Vision Transformers har mantraet "attention is all you need" ændret, hvordan vi tænker om maskinlæring. Translator-systemer, altså encoder-decoder-pipelines, der omsætter data mellem forskellige repræsentationer, blev rygraden i alt fra sprogbehandling til billedgenerering. De var revolutionerende. De var kraftfulde.
Og nu støder de ind i en mur.
Ironien er, at løsningen har eksisteret siden 1982. Det år udgav John Hopfield en artikel i Proceedings of the National Academy of Sciences, som introducerede et rekurrent neuralt netværk med en egenskab, transformere aldrig for alvor har opnået: garanteret konvergens mod stabile tilstande gennem energiminimering. Hopfield-netværket lærte ikke bare mønstre, det lagrede dem som fysiske attraktorer i et energilandskab, som kunne genfindes selv ud fra støjende eller ufuldstændige input.
AI-miljøet er først nu begyndt at tage til sig, hvad fysikere og neuroforskere har vidst i årtier: den energibaserede, associative tilgang til neural beregning er ikke en historisk kuriositet, men et grundlæggende paradigme, som transformer-æraen blot har bygget videre på uden helt at forstå det.
Transformernes loft
Transformere fungerer ved at beregne relationer mellem alle elementer i en sekvens på samme tid gennem selvopmærksomhed (self-attention). Det er genialt til sprog. Det er genialt til strukturerede data med tydelige sekventielle mønstre. Men den virkelige verden, med robotter, indlejrede kredsløb, sensorstyret beslutningstagning og edge computing, ordner sig ikke i pæne sekvenser, der venter på at blive set på.
Transformer-arkitekturen forudsætter overflod: rigelig regnekraft, rigelig hukommelse, rigelig strøm. Selvopmærksomhed skalerer kvadratisk med sekvenslængden. Feed-forward-lag vokser lineært, men enormt. Når man implementerer et transformer-baseret system på en mobil robot, der navigerer rundt i et lager, eller bygger det ind i et elektronisk kredsløb, der styrer en produktionsarm, falder de antagelser fra hinanden.
Translator-paradigmet har sin egen begrænsning: det behandler intelligens som først og fremmest et konverteringsproblem mellem faste repræsentationer. Kod input. Afkod output. Men ægte intelligens oversætter ikke bare, den husker, den associerer, og den konvergerer mod stabile tolkninger, selv når input er forringet eller flertydigt.
Vi har lappet på disse problemer med kvantisering, destillation, beskæring og hundrede andre optimeringstricks. Surveys om edge-AI fra 2025 bekræfter, at det stadig er "begrænset af strenge grænser for hukommelse, beregning og energi" at køre deep learning på indlejret hardware. Men optimering af en grundlæggende uhensigtsmæssig arkitektur udskyder kun opgøret. Det, vi har brug for, er en arkitektur, der behandler hukommelse, stabilitet og energieffektivitet som grundprincipper og ikke som eftertanker.
Hopfield-netværket træder ind
Et Hopfield-netværk er et rekurrent neuralt netværk, der består af ét enkelt lag neuroner, hvor hver neuron er forbundet til alle andre neuroner undtagen sig selv. Netværket danner en komplet urettet graf: ethvert par af neuroner deler en symmetrisk forbindelsesvægt, hvilket betyder, at styrken fra neuron i til neuron j er identisk med styrken fra jtil i. Der er ingen selvforbindelser (wᵢᵢ = 0). Intet lagdelt hierarki. Ingen sekventiel behandlingspipeline. I stedet fungerer hele netværket som ét samlet, sammenhængende dynamisk system, der over tid udvikler sig mod stabile ligevægtstilstande.
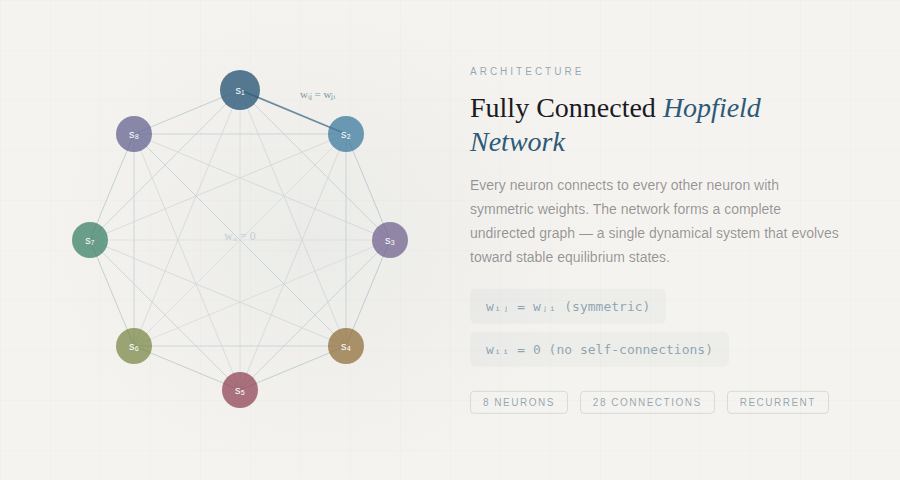
Et Hopfield-netværk med fuldt forbundne neuroner. Hver node er forbundet med alle andre noder med symmetriske vægte (wᵢⱼ = wⱼᵢ), så de danner en komplet uorienteret graf. Der findes ingen selvforbindelser.
Det elegante ved denne arkitektur ligger i dens energifunktion. Hopfield beviste, at hans netværk har en tilhørende Lyapunov-energifunktion:
E = −½ Σᵢ Σⱼ wᵢⱼ sᵢ sⱼ − Σᵢ θᵢ sᵢ
Denne energi er garanteret at falde (eller forblive konstant) ved hver opdatering af en neuron. Netværket konvergerer altid: det svinger aldrig i det uendelige, divergerer aldrig og sidder aldrig fast i uendelige beregningsløkker. Det falder til ro. Bruck beviste i 1990, at denne adfærd hænger sammen med snit i den tilhørende graf: netværket udfører i bund og grund en grådig algoritme for max-cut-problemet ved hvert opdateringstrin.
Og det sted, hvor netværket falder til ro, er det sted, hvor intelligensen bor. Lagrede mønstre svarer til energifunktionens lokale minima, altså dalene i energilandskabet. Når du præsenterer netværket for en forvansket, støjfyldt eller ufuldstændig udgave af et lagret mønster, ruller dynamikken netværkets tilstand ned ad bakke, indtil den falder ned i den nærmeste dal: det lagrede mønster, der passer bedst til inputtet.
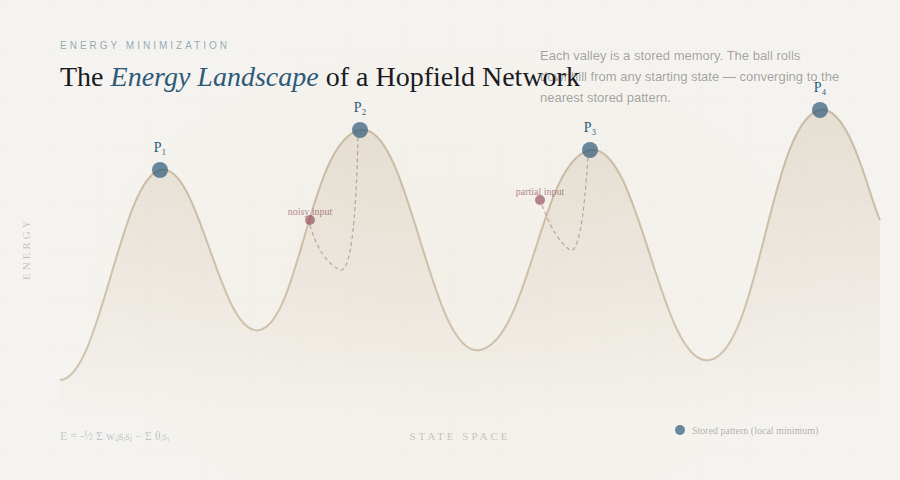
Energilandskabet i et Hopfield-netværk. Hver dal (lokalt minimum) svarer til et lagret hukommelsesmønster. Uanset starttilstand ruller netværkets dynamik "ned ad bakke", indtil den falder til ro i den nærmeste attraktor og dermed genskaber det komplette mønster ud fra delvist eller støjfyldt input.
Dette er indholdsadresserbar associativ hukommelse evnen til at genkalde hele minder ud fra delvise spor, noget biologiske hjerner gør uden anstrengelse, men som transformere kun kan tilnærme sig gennem dyr beregning.
Forbindelsen til fysikken går dybt. Hopfield-netværket er matematisk ækvivalent med en Ising-model, den samme model, der bruges til at beskrive magnetisme i statistisk mekanik. Sherrington-Kirkpatrick-modellen for spinglas, udgivet i 1975, er i bund og grund et Hopfield-netværk med tilfældige vægte. Hopfields indsigt var at udnytte denne egenskab bevidst og konstruere energilandskabet, så hvert minimum svarer til et nyttigt lagret mønster.
Hebbsk læring: Neuroner, der fyrer sammen, forbindes sammen
Den læreregel, der får Hopfield-netværk til at virke, har rødder, der går endnu længere tilbage, til Donald Hebbs bog fra 1949, The Organization of Behavior, som fremsatte det, der i dag regnes for det grundlæggende princip i teorien om neural læring.
Hebbs indsigt var bedragerisk enkel: når en præsynaptisk celle gentagne gange og vedvarende deltager i at få en postsynaptisk celle til at fyre, styrkes den synaptiske forbindelse mellem dem. "Neuroner, der fyrer sammen, forbindes sammen", selv om Hebb selv var mere præcis og understregede, at celle A skal deltage i at forårsage at celle B fyrer, ikke blot fyre på samme tid. Denne tidsmæssige kausalitet varslede det, vi i dag kender som spike-timing-dependent plasticity (STDP), som årtier senere blev bekræftet eksperimentelt, bl.a. gennem Eric Kandels banebrydende forskning i havsneglen Aplysia californica.
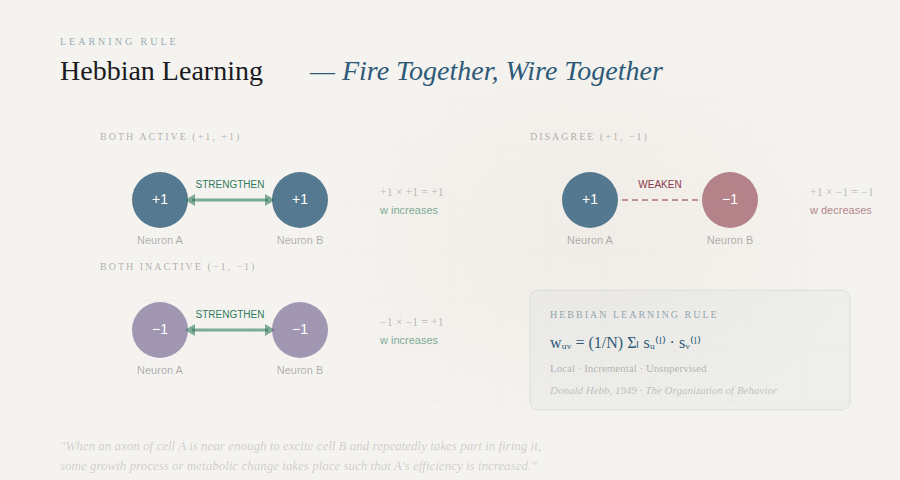
Hebbisk læring: Når to forbundne neuroner gentagne gange er aktive samtidig, bliver synapsen mellem dem stærkere. Princippet "neuroner, der fyrer sammen, forbindes sammen" er det biologiske fundament for, hvordan Hopfield-netværk lagrer mønstre.
I Hopfield-netværket implementeres hebbisk læring således:
wᵤᵥ = (1/N) Σₗ sᵤ(l) · sᵥ(l) for alle lagrede mønstre l, hvor u ≠ v
Når to neuroner har samme tilstand i et givet mønster (begge +1 eller begge −1), er deres produkt positivt, og den excitatoriske forbindelse styrkes. Når de er uenige, er produktet negativt, og der opstår en inhibitorisk forbindelse. Den samlede virkning former et energilandskab med en dal ved hvert lagret mønster.
Den hebbiske regel er lokal (hver vægtopdatering bruger kun information, som de to forbundne neuroner har adgang til) og inkrementel (nye mønstre kan lagres uden at behandle de gamle igen). Bemærkelsesværdigt nok kan man vise matematisk, at hebbisk læring udfører uovervåget principalkomponentanalyse (PCA) af inputdata netværket udtrækker helt naturligt de statistisk mest betydningsfulde træk fra sine omgivelser.
I 1997 introducerede Amos Storkey en forbedret læreregel, der tager højde for det lokale felt ved hver neuron og opnår større lagerkapacitet end standard hebbisk læring. Det viser, at selv inden for den samme arkitektur har valget af læringsalgoritme dyb betydning et princip, der genklinger i den bredere lære fra forskningen i neurale netværk.
Gennembruddet: "Hopfield Networks is All You Need"
I 2020 udgav et hold ledet af Hubert Ramsauer på Johannes Kepler Universität Linz en artikel med en provokerende titel, der ekkoer transformerens oprindelseshistorie: "Hopfield Networks is All You Need." Deres bidrag var det matematiske bevis for noget, mange længe havde mistænkt: Selvopmærksomhedsmekanismen (self-attention) i transformere er præcis opdateringsreglen i et moderne kontinuerligt Hopfield-netværk.
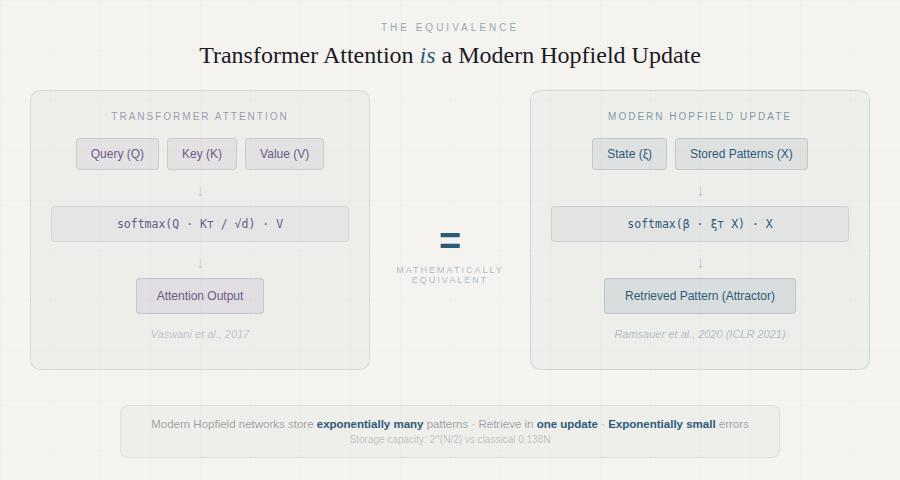
Forbindelsen mellem moderne Hopfield-netværk og transformerens attention. Den softmax-baserede attention-mekanisme i transformere er matematisk ækvivalent med ét opdateringstrin i et kontinuerligt Hopfield-netværk med en eksponentiel energifunktion. Billede fra Ramsauer et al., "Hopfield Networks is All You Need."
Det var ikke blot en analogi. Holdet viste, at når man generaliserer den klassiske Hopfield-energifunktion til kontinuerlige tilstande og bruger et eksponentielt interaktionsled, bliver den resulterende opdateringsregel:
Z = softmax(β · R Wq Wk⊤ Y⊤) Y Wk Wv
hvilket netop er transformerens attention-formel. Det moderne Hopfield-netværk kan lagre eksponentielt mange mønstre (i forhold til dimensionen af det associative rum), henter dem frem i ét enkelt opdateringstrin og har eksponentielt små genfindingsfejl.
Artiklen identificerede tre typer energiminima i denne moderne ramme: (1) et globalt fikspunkt, der danner gennemsnit over alle lagrede mønstre, (2) metastabile tilstande, der danner gennemsnit over delmængder af mønstre, og (3) fikspunkter, der lagrer enkelte mønstre. Transformerhoveder i de lavere lag har en tendens til at arbejde i det globale gennemsnitsregime, mens hoveder i de højere lag bruger metastabile tilstande til at indsamle og bearbejde information et fund, der giver dyb indsigt i hvorfor transformere fungerer, som de gør.
Den praktiske konsekvens kom med det samme: Holdet udgav Hopfield-lagsom drop-in PyTorch-moduler, der kan erstatte pooling-lag, GRU/LSTM-lag og almindelige attention-lag. I benchmarks opnåede disse Hopfield-lag state-of-the-art-resultater inden for klassificering af immunrepertoirer (med adskillige hundredtusinde instanser pr. prøve), multiple instance learning-problemer og UCI-klassifikationsbenchmarks, hvor traditionelle deep learning-metoder typisk har svært ved at følge med.
I december 2025 gik en NeurIPS-artikel af Masumura og Taki endnu længere og viste, at når man går ud over den "adiabatiske approksimation", afsløres skjulte tilstande i sammenhængen mellem Hopfield-netværk og transformere. De kan løse problemerne med rank collapse og token-ensartethed, som plager dybe transformere, og forbedre nøjagtigheden uden at tilføje nogen træningsparametre.
Den voksende enighed: Hvem siger ellers det samme?
Påstanden om, at Hopfield-netværk er det næste paradigme efter transformere, er ikke spekulation. Store forskningsinstitutioner arbejder aktivt på det, og beviserne hober sig hurtigt op. Her er de vigtigste stemmer og artikler, der peger mod den samme konklusion.
IBM Research og Dmitry Krotov
I januar 2025 udgav IBM Research et omfattende interview med Dmitry Krotov, Hopfields mangeårige samarbejdspartner og en af arkitekterne bag Dense Associative Memory. Krotov argumenterede direkte: Da Hopfield-netværk afspejler hjernens tilbagevendende feedback-løkker, i modsætning til feedforward-arkitekturen i 90 % af nutidens AI-modeller, udgør de "et lovende alternativ til nutidens feedforward-netværk". Han påpegede, at transformere kun behandler information i én retning, og at den beregningsmæssige kompleksitet vokser hurtigt, i takt med at kontekstvinduerne bliver længere. Hjernen bruger derimod tilbagevendende feedback-løkker til at opsummere og gemme tidligere information i hukommelsen. Hopfield-netværk fungerer på samme måde.
Krotov beskrev også Energy Transformer (NeurIPS 2023), et samarbejde mellem IBM Research og Georgia Tech, som ikke blot lægger Hopfield-indsigter oven på eksisterende transformere, men erstatter hele rækken af feedforward-transformerblokke med én stor Associative Memory-model. Attention-mekanismen i Energy Transformer adskiller sig tydeligt fra den konventionelle: Den er udledt af grundprincipperne for energiminimering og er ikke hæftet på en feedforward-pipeline bagefter.
🔗 IBM Research: "Searching for brain-inspired AI algorithms" (jan. 2025)
🔗 Energy Transformer arXiv:2302.07253 (NeurIPS 2023)
Johannes Kepler University – Hochreiters gruppe
Sepp Hochreiter, medopfinder af LSTM, ledede holdet bag "Hopfield Networks is All You Need". Deres Hopfield layers-repository indeholder produktionsklare PyTorch-moduler, som kan bruges som drop-in-erstatning for attention-lag i transformere, pooling-lag og tilbagevendende lag. Det tilhørende blogindlæg gennemgår den matematiske udledning, der viser, at softmax-attention-formlen er et specialtilfælde af den moderne Hopfield-opdateringsregel, og at Hopfield-lag tilbyder ekstra funktioner, som almindelig attention ikke kan levere, herunder statiske indlærte prototyper og fleksible konfigurationer af associativ hukommelse.
🔗 Hopfield Networks is All You Need – ICLR 2021
NeurIPS 2025: Hopfield Attention Improves GPT and Vision Transformers
De nyeste beviser kommer fra Masumura og Takis NeurIPS-artikel fra december 2025. De viste, at Modern Hopfield Attention (MHA) som tilføjer skjulte tilstande udledt af den fulde (ikke-adiabatiske) Hopfield-dynamik, forbedrer systematisk både GPT-2- og LLaMA-sprogmodeller samt Vision Transformers. Forbedringerne kom helt uden ekstra træningsparametre. Endnu vigtigere var det, at MHA viste sig at løse problemet med rank collapse (hvor opmærksomhedsmatricerne i dybe transformere degenererer, så alle tokens ender med at ligne hinanden i repræsentationen), en grundlæggende svaghed, som har plaget forsøg på at skalere transformere. Forfatterne konkluderer: "Vi håber, at denne forskning åbner nye muligheder for systematisk design af Transformer-arkitekturer med Hopfield-netværk."
🔗 On the Role of Hidden States of Modern Hopfield Network in Transformer arXiv:2511.20698 (NeurIPS 2025)
Nature Communications: Biologisk plausibel online-læring
I maj 2024 udgav Nature Communications et arbejde om Sparse Quantized Hopfield Network, en model, der lærer med lokale læringsregler i online-kontinuerlige scenarier, præcis som biologiske hjerner gør. Det adresserer en grundlæggende begrænsning ved transformere, som kræver ikke-lokal backpropagation og offline-træning på kuraterede datasæt. Artiklen placerer Hopfield-baserede arkitekturer som den naturlige bro mellem kunstige neurale netværk og neuromorfisk computerhardware.
🔗 A Sparse Quantized Hopfield Network for Online-Continual Memory Nature Communications (2024)
Outlier-Efficient Hopfield Layers for Large Foundation Models
En artikel fra 2024 tog fat på et praktisk problem i store transformermodeller: tendensen til at lægge opmærksomhed på uinformative tokens (skilletegn, tegnsætning), det såkaldte "no-op outlier"-problem. Løsningen var en outlier-efficient Hopfield-energifunktion, der klassificerer disse tokens og leder dem hen til et punkt med nul energi, så de ikke udvander den nyttige opmærksomhed. Den resulterende model rummer Softmax₁-opmærksomhed som et særtilfælde og blev valideret på BERT, OPT og Vision Transformers. Her løser Hopfield-teori konkrete ingeniørproblemer i transformere.
🔗 Outlier-Efficient Hopfield Layers for Large Transformer-Based Models (2024)
Transformere som energiminimerere (januar 2026)
Det seneste teoretiske arbejde, udgivet i januar 2026, beskriver hele transformerens fremadrettede gennemløb som iboende energiminimering og tager dermed Hopfield-perspektivet fuldt ud til sig som forklaringsramme for, hvorfor transformere overhovedet virker. Artiklen forbinder sparse moderne Hopfield-modeller med hele familien af opmærksomhedsvarianter (softmax, sparsemax, α-entmax) og viser, at de alle er særtilfælde af energibaseret genfinding.
🔗 Transformers as Intrinsic Optimizers: Forward Inference through the Energy Principle (jan. 2026)
Oversigtsartikler og ressourcer fra fællesskabet
Det bredere forskningsmiljø samler sig om denne konvergens:
- "Energy-Based Learning and the Evolution of Hopfield Networks" (TechRxiv, april 2025) En omfattende oversigt, der følger hele forløbet fra Hopfield (1982) over Boltzmann-maskiner til nytolkningen af transformernes opmærksomhed som moderne Hopfield-dynamik. → Læs artiklen
- "An Energy-Based Perspective on Attention Mechanisms in Transformers" En dybdegående teknisk blog, der argumenterer for, at en forståelse af transformere gennem Hopfield-energiens linse "kan føre til kvalitativt anderledes forbedringer ud over, hvad man kan opnå alene ved at skalere og reducere beregningsmæssig kompleksitet." → Læs bloggen
- Awesome Modern Hopfield Networks Et kurateret GitHub-repository, der følger mere end 50 artikler om moderne Hopfield-netværk på tværs af felter: aktivallokering, ændringsdetektion, rekonstruktion af kreative tanker, detektion af out-of-distribution-data, klassificering af immunrepertoirer og meget mere. → Udforsk samlingen
- "Is Hopfield Networks All You Need?" (Analytics India Magazine, dec. 2024) Praksisnær gennemgang af, hvordan Hochreiters team viste, at Hopfield-netværk er "udskiftelige med transformer-modeller i verdensklasse". → Læs artiklen
- "New Research in Hopfield Networks: A Short Intro" (Medium, juli 2024) Letforståeligt overblik, der påpeger, at lagerkapaciteten er vokset fra 0,138N til 2^(N/2) takket være eksponentielle aktiveringsfunktioner. → Læs på Medium
Retningen er tydelig. Det er ikke ét laboratoriums forslag eller én artikels spekulation. IBM Research, Johannes Kepler University, MIT, NeurIPS, Nature Communications og det bredere maskinlæringsmiljø nærmer sig den samme konklusion fra forskellige retninger: Det energibaserede, associative hukommelsesparadigme, som Hopfield grundlagde, er ikke bare det fundament, transformere uden at vide det er bygget på. Det er det rammeværk, der vil føre AI videre end det, transformere alene kan nå.
Hvorfor det er vigtigt nu: Argumenterne for at skifte
Garanteret konvergens til sikkerhedskritiske systemer
Transformere leverer output, men der er ingen matematisk garanti for stabilitet. Hopfield-netværk konvergerer mod stabile tilstande, og det er bevist energifunktionen falder monotont. For robotteknologi, autonome køretøjer, medicinsk udstyr og ethvert system, hvor pålidelighed ikke er til forhandling, er det et krav, som transformere ikke kan opfylde.
Associativ hukommelse som kernefunktion
Hvis man træner et Hopfield-netværk, så tilstanden (1, −1, 1, −1, 1) er et energiminimum, og derefter præsenterer det forvrængede input (1, −1, −1, −1, 1), konvergerer netværket mod det korrekte lagrede mønster. Det gætter eller interpolerer ikke, det triller ned ad bakke i energilandskabet til den nærmeste attraktor. For robotteknologi med tildækkede sensorer, indlejrede systemer med støjfyldte data og enhver anvendelse, der kræver mønstergenkendelse ud fra delvist input, er det banebrydende.
En universel optimeringsmotor
Hopfield og David Tank viste i 1985, at Hopfield-netværk kan løse problemet med den handelsrejsende. Hvis en omkostningsfunktion kan skrives på formen af Hopfield-energien, er netværkets ligevægtspunkter løsningerne. Siden da er arkitekturen blevet brugt til jobshop-planlægning, kanaltildeling i trådløse netværk, billedrestaurering, analog-til-digital-konvertering, mobil routing og kombinatorisk optimering. En artikel i Nature Communications fra 2024 introducerede et Sparse Quantized Hopfield Network til online-kontinuerlig hukommelsesindlæring med lokale regler på samme måde som biologiske hjerner, en evne som transformere grundlæggende mangler.
Hardware, der tænker uden software
Begrænsningen om symmetriske vægte (wᵢⱼ = wⱼᵢ) kan overføres direkte til analoge elektroniske kredsløb en resistiv forbindelse er i sig selv symmetrisk. Hopfield-netværk kan fremstilles som ASIC'er eller FPGA'er med inferens på nanosekunders tidsskala. Natures samling fra 2025 om neuromorfisk databehandling bekræfter denne retning: energieffektiv analog hardware, der implementerer neurale dynamikker helt ude ved kanten, med indholdsadresserbar hukommelse, der hverken kræver GPU, CPU eller softwarestak.
Neuromorfe og analoge AI-chips, der implementerer neurale netværks dynamik direkte i hardware. Hopfield-netværkenes symmetriske, energibaserede struktur passer naturligt til resistive kredsløb og gør AI-inferens mulig på nanosekunders tidsskala uden traditionelle softwarestakke.
Fleksibelt – både binært og kontinuerligt
Klassiske Hopfield-netværk bruger binære neuroner (+1 eller −1), mens de kontinuerlige varianter bruger sigmoid-aktivering og differentialligninger. Opdateringer kan ske asynkront (én neuron ad gangen, hvilket garanterer konvergens) eller synkront (alle på én gang, hvilket giver mulighed for parallelisme). Den samme arkitektur kan tilpasses alt fra en mikrocontroller med få kilobytes RAM til en massivt parallel FPGA og nu, med moderne Hopfield-lag, til GPU-accelererede deep learning-pipelines.
Lagerkapacitet: Den ærlige begrænsning
Den klassiske begrænsning er klar: Et netværk med N neuroner kan pålideligt lagre cirka 0,138N mønstre, før falske tilstande forringer genkaldelsen. Det er en reel begrænsning, men det er en ærlig en af slagsen. Transformere har ikke en tydelig matematisk grænse for, hvornår de begynder at hallucinere.
Desuden opnår moderne Hopfield-netværk (Krotov & Hopfield, 2016; Demircigil et al., 2017) eksponentiel lagerkapacitet gennem interaktionsled af højere orden. Forskningen fortsætter med at flytte grænserne: sparse og strukturerede Hopfield-netværk, Hopfield-hukommelse til lange sekvenser og Hopfield-netværk til aktivallokering er alle aktive udviklingsområder, og der udkommer hastigt flere og flere artikler.
Praktisk anvendelse: Fra pc'er til kredsløb
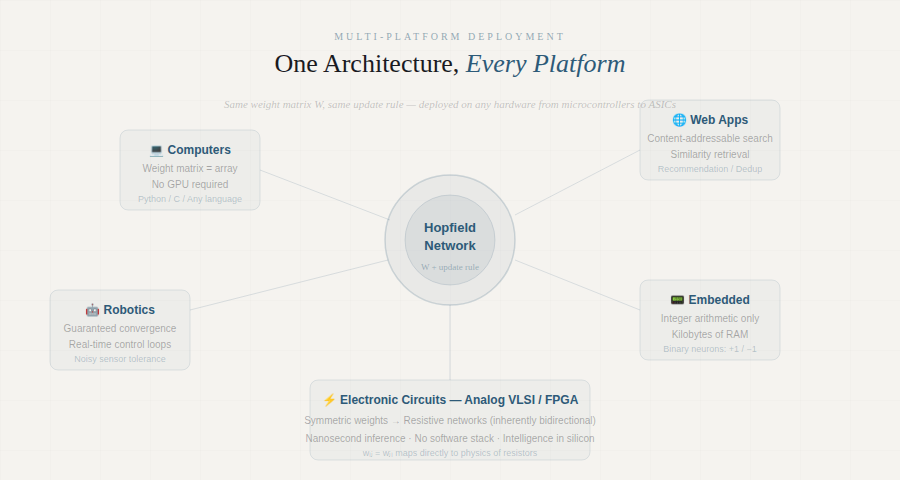
De tidlige forskere i neurale netværk havde en klar vision: en ramme, der kunne beskrives én gang og anvendes overalt. Hopfields arkitektur indfrier den:
Computerapplikationer En vægtmatrix og en opdateringsregel. Ingen GPU nødvendig.
Internetapplikationer Indholdsadresserbar hukommelse til lighedssøgning, anbefalinger og fjernelse af dubletter.
Robotteknologi Garanteret konvergens til realtidsstyring. Bevægelsesmønstre lagres som attraktorer og kan genkaldes, selv ud fra støjende sensorinput.
Indlejrede systemer Binære Hopfield-netværk kan køre på mikrocontrollere med ren heltalsaritmetik.
Elektroniske kredsløb Symmetriske vægte svarer til resistive netværk. Intelligens fremstillet direkte i silicium.
Vejen frem
Transformer-æraen har givet os ekstraordinære sprogmaskiner. Men grænsen rykker nu ind i den fysiske verden: robotter, sensorer, aktuatorer og beslutninger i realtid. Den grænse kræver arkitekturer, der er stabile, effektive, fortolkelige og kan køre på hardware, der faktisk findes ude i udkanten af netværket.
Beviset fra 2020 for, at transformerens attention er en moderne Hopfield-opdateringsregel, var ikke bare en matematisk kuriositet. Det afslørede, at vi hele tiden har brugt Hopfield-netværk, pakket ind i en ramme, der skjulte deres sande natur. NeurIPS-arbejdet fra 2025, der viser, at skjulte Hopfield-tilstande løser transformeres patologier som rangkollaps, peger på næste skridt: ikke at lappe transformere med Hopfield-indsigter, men at bygge direkte på selve Hopfield-paradigmet.
John Hopfield viste os vejen i 1982. Donald Hebb lagde de biologiske fundamenter i 1949. Nu er forskningsmiljøet ved at samle sig om den.
Det er på tide at skifte.
Referencer
- Hopfield, J.J. (1982). "Neural networks and physical systems with emergent collective computational abilities." PNAS, 79(8), 2554–2558.
- Hebb, D.O. (1949). The Organization of BehaviorWiley.
- Ramsauer, H. et al. (2020). "Hopfield Networks is All You Need." ICLR 2021. arXiv:2008.02217
- Krotov, D. & Hopfield, J.J. (2016). "Dense Associative Memory for Pattern Recognition." NeurIPS.
- Storkey, A. (1997). "Increasing the capacity of a Hopfield network without sacrificing functionality." ICANN.
- Hoover, B., Krotov, D. et al. (2023). "Energy Transformer." NeurIPS 2023. arXiv:2302.07253
- Masumura, T. & Taki, M. (2025). "On the Role of Hidden States of Modern Hopfield Network in Transformer." NeurIPS 2025. arXiv:2511.20698
- Alonso, N. & Krichmar, J. (2024). "A sparse quantized Hopfield network for online-continual memory." Nature Communications, 15, 3722. nature.com
- Hu, J.Y. et al. (2024). "Outlier-Efficient Hopfield Layers for Large Transformer-Based Models." arXiv:2404.03828
- Hu, J.Y. et al. (2026). "Transformers as Intrinsic Optimizers: Forward Inference through the Energy Principle." arXiv:2511.00907
- Hopfield, J.J. & Tank, D.W. (1985). "'Neural' Computation of Decisions in Optimization Problems." Biological Cybernetics, 52, 141–152.
- Bruck, J. (1990). "On the convergence properties of the Hopfield model." Proceedings of the IEEE.
- Krotov, D. (2025). "Searching for brain-inspired AI algorithms." IBM Research Blog. research.ibm.com
- "Energy-Based Learning and the Evolution of Hopfield Networks." TechRxiv, april 2025. techrxiv.org

