
Hebbiana lernado renkontas retojn de Hopfield: la arkitekturo, kiu ĉiam estis pli saĝa ol la transformiloj
Dum la lasta jardeko transformiloj (transformers) kaj iliaj atentomekanismoj dominis la pejzaĝon de artefarita inteligento. De GPT al BERT kaj Vision Transformers, la moto „atento estas ĉio, kion vi bezonas“ ŝanĝis nian manieron pensi pri maŝina lernado. Tradukaj sistemoj, kodigil-dekodigilaj duktoj, kiuj konvertas datumojn inter prezentoj, fariĝis la spino de ĉio, de lingva prilaborado ĝis bilda generado. Ili estis revoluciaj. Ili estis potencaj.
Kaj nun ili trafas muron.
La ironio estas, ke la solvo ekzistas ekde 1982. En tiu jaro John Hopfield publikigis artikolon en la Proceedings of the National Academy of Sciences, kiu prezentis rekurentan neŭralan reton kun propraĵo, kiun transformiloj neniam vere atingis: garantiita konverĝo al stabilaj statoj per minimumigo de energio. La reto de Hopfield ne simple lernis ŝablonojn, ĝi konservis ilin kiel fizikajn altirpunktojn (attractors) en energia pejzaĝo, rehaveblajn eĉ el brua aŭ nekompleta enigo.
La komunumo de AI nur nun komencas ensorbi tion, kion la komunumoj de fiziko kaj neŭroscienco konas jam delonge: la energi-bazita, asocia aliro al neŭrala komputado ne estas historia kuriozaĵo, sed fundamenta paradigmo, sur kiu la epoko de la transformiloj nur konstruis, ne plene komprenante ĝin.
La plafono de la transformiloj
Transformiloj funkcias kalkulante rilatojn inter ĉiuj elementoj de sekvenco samtempe per mem-atento (self-attention). Tio estas bonega por lingvo. Tio estas bonega por strukturitaj datumoj kun klaraj sinsekvaj ŝablonoj. Sed la reala mondo, la mondo de robotiko, enkonstruitaj cirkvitoj, sensil-gvidata decidado kaj randa komputado (edge computing), ne ordigas sin en glatajn sekvencojn, kiuj atendas ricevi atenton.
La arkitekturo de transformiloj supozas abundon: abundan komputpovon, abundan memoron, abundan energion. Mem-atento kreskas kvadrate laŭ la longo de la sekvenco. Antaŭenalimentaj tavoloj kreskas lineare, sed masive. Kiam vi disponigas transformil-bazitan sistemon sur movebla roboto, kiu navigas en magazeno, aŭ enkonstruas ĝin en elektronikan cirkviton, kiu regas fabrikan brakon, tiuj supozoj diseriĝas.
La traduka paradigmo portas sian propran limigon: ĝi traktas inteligenton ĉefe kiel konvertan problemon inter fiksitaj prezentoj. Kodigu la enigon. Dekodigu la eligon. Sed vera inteligento ne nur tradukas, ĝi memoras, ĝi asocias kaj ĝi konverĝas al stabilaj interpretoj eĉ kiam la enigo estas difektita aŭ ambigua.
Ni flikadis tiujn problemojn per kvantigo, distilado, tondado kaj cent aliaj optimumigaj lertaĵoj. Enketoj pri Edge AI en 2025 konfirmas, ke disponigi profundan lernadon sur enkonstruita aparataro restas „limigita de striktaj limoj de memoro, komputado kaj energio“. Sed optimumigo de esence neharmonia arkitekturo nur prokrastas la finan kalkulon. Ni bezonas arkitekturon, kiu traktas memoron, stabilecon kaj energian efikecon kiel unuajn principojn, ne kiel postpensojn.
Eniras la neŭrala reto de Hopfield
Reto de Hopfield estas rekurenta neŭrala reto, konsistanta el unu sola tavolo de neŭronoj, kie ĉiu neŭrono estas ligita al ĉiu alia neŭrono, escepte de si mem. La reto formas kompletan neorientitan grafeon, en kiu ĉiu paro de neŭronoj havas simetrian ligpezon, tio signifas, ke la forto de neŭrono i al neŭrono j estas identa al la forto de jal i. Mem-konektoj ne ekzistas (wᵢᵢ = 0). Neniu tavola hierarkio. Neniu sinsekva prilabora ĉeno. Anstataŭe la tuta reto funkcias kiel unu sola, interkonektita dinamika sistemo, kiu evoluas laŭ la tempo al stabilaj ekvilibraj statoj.
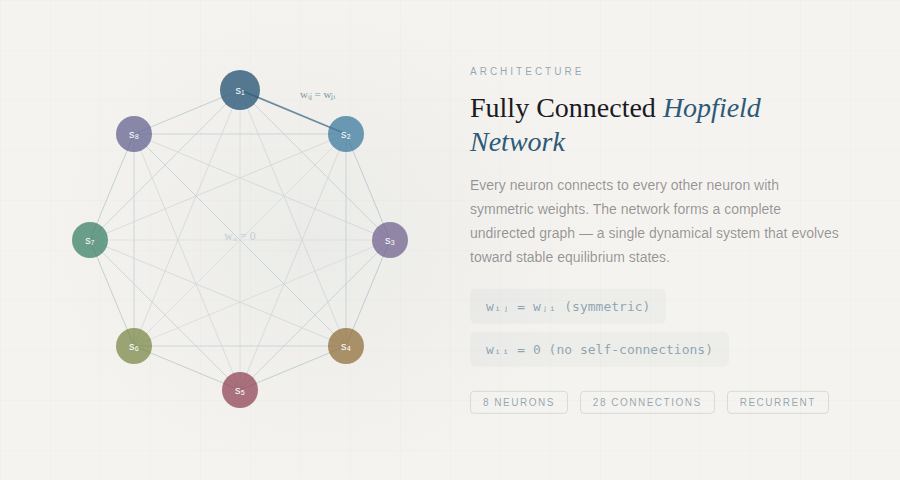
Hopfield-reto kun plene konektitaj neŭronoj. Ĉiu nodo konektiĝas kun ĉiu alia per simetriaj pezoj (wᵢⱼ = wⱼᵢ), formante kompletan neorientitan grafeon. Mem-konektoj ne ekzistas.
La eleganteco de ĉi tiu arkitekturo kuŝas en ĝia energifunkcio. Hopfield pruvis, ke lia reto posedas asociitan energifunkcion de Lyapunov:
E = −½ Σᵢ Σⱼ wᵢⱼ sᵢ sⱼ − Σᵢ θᵢ sᵢ
Tiu energio garantiite malkreskas (aŭ restas konstanta) ĉe ĉiu ĝisdatigo de neŭrono. La reto ĉiam konverĝas: ĝi neniam oscilas senfine, neniam diverĝas, neniam kaptiĝas en senfinaj komputaj bukloj. Ĝi stabiliĝas. Bruck pruvis en 1990, ke tiu stabiliĝa konduto rilatas al tranĉoj en la asociita grafeo: la reto esence plenumas avidan algoritmon por la problemo de maksimuma tranĉo (max-cut) ĉe ĉiu ĝisdatiga paŝo.
Kaj tie, kie la reto stabiliĝas, loĝas la inteligento. Konservitaj ŝablonoj respondas al lokaj minimumoj de la energifunkcio: la valoj en la energia pejzaĝo. Kiam vi prezentas al la reto difektitan, bruan aŭ nekompletan version de konservita ŝablono, la dinamiko ruligas la staton de la reto malsupren, ĝis ĝi falas en la plej proksiman valon: la konservitan ŝablonon, kiu plej bone kongruas kun la enigo.
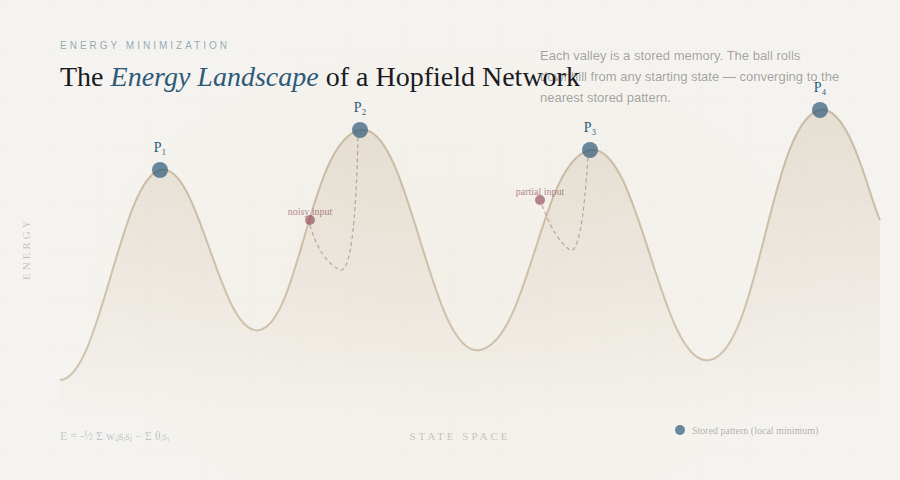
La energia pejzaĝo de Hopfield-reto. Ĉiu valo (loka minimumo) respondas al konservita memora ŝablono. Ekde iu ajn komenca stato, la dinamiko de la reto ruliĝas "malsupren" ĝis ĝi stabiliĝas en la plej proksima altiranto, rekuperante la kompletan ŝablonon el parta aŭ brua enigo.
Tio estas enhav-adresebla asocia memoro la kapablo rememori kompletajn memorojn el partaj indikoj, kion biologiaj cerboj faras senpene, sed kion transformiloj (transformers) povas nur proksimumi per multekosta komputado.
La ligo kun fiziko estas profunda. La Hopfield-reto estas matematike ekvivalenta al modelo de Ising, la sama kadro uzata por priskribi magnetismon en statistika mekaniko. La modelo de spinvitro de Sherrington kaj Kirkpatrick, publikigita en 1975, estas esence Hopfield-reto kun hazardaj pezoj. La kompreno de Hopfield estis intence ekspluati tiun econ, projektante la energian pejzaĝon tiel, ke ĉiu minimumo respondu al utila konservita ŝablono.
Heba lernado: neŭronoj, kiuj ekfajras kune, ligiĝas kune
La lernoregulo, per kiu Hopfield-retoj funkcias, havas radikojn ankoraŭ pli malproksimajn, ĝis la libro de Donald Hebb el 1949, The Organization of Behavior, kiu proponis tion, kio hodiaŭ estas rigardata kiel la fonda principo de la teorio de neŭrona lernado.
La kompreno de Hebb estis trompe simpla: kiam presinapsa ĉelo ripete kaj persiste partoprenas en la ekfajrigo de postsinapsa ĉelo, la sinapsa ligo inter ili fortiĝas. "Neŭronoj, kiuj ekfajras kune, ligiĝas kune", kvankam Hebb mem estis pli preciza, substrekante ke ĉelo A devas partopreni en la kaŭzado de la ekfajro de ĉelo B, ne nur ekfajri samtempe. Tiu tempa kaŭzeco antaŭsignis tion, kio nun nomiĝas plastikeco dependa de la tempigo de pikoj (STDP), eksperimente konfirmita post jardekoj, inkluzive de la plejpioniraj esploroj de Eric Kandel pri la mara limako Aplysia californica.
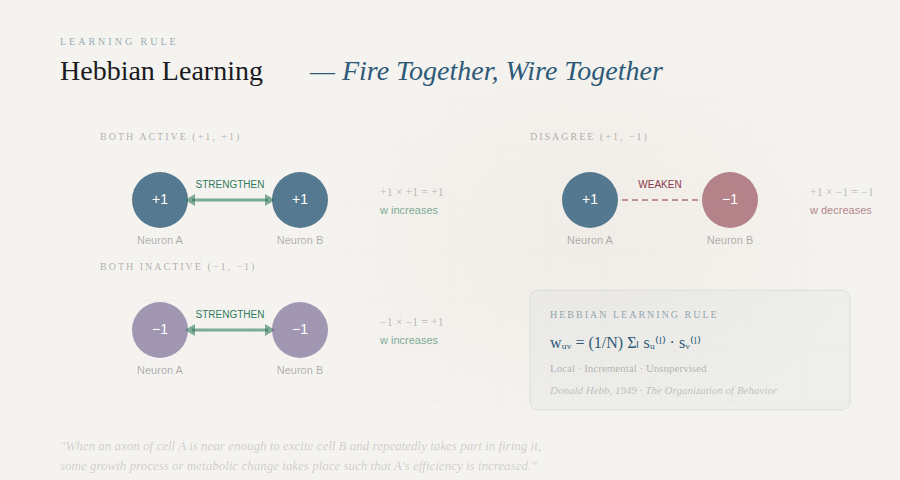
Hebba lernado: kiam du konektitaj neŭronoj ripete aktiviĝas kune, la sinapso inter ili fortiĝas. Ĉi tiu principo, "neŭronoj, kiuj ekfajras kune, ligiĝas kune", estas la biologia fundamento de tio, kiel la retoj de Hopfield stokas ŝablonojn.
En la reto de Hopfield, la Hebba lernado estas realigita jene:
wᵤᵥ = (1/N) Σₗ sᵤ(l) · sᵥ(l) por ĉiuj stokitaj ŝablonoj l, kie u ≠ v
Kiam du neŭronoj havas la saman staton en donita ŝablono (ambaŭ +1 aŭ ambaŭ −1), ilia produto estas pozitiva, kaj la eksciteca ligo fortiĝas. Kiam ili malkonsentas, la produto estas negativa kaj naskas malhibician ligon. La akumula efiko skulptas energian pejzaĝon kun valo ĉe ĉiu stokita ŝablono.
La Hebba regulo estas loka (ĉiu ĝisdatigo de pezo uzas nur informon disponeblan al la du konektitaj neŭronoj) kaj pliiga (novajn ŝablonojn eblas stoki sen reprocesi la malnovajn). Rimarkinde, oni povas matematike pruvi, ke Hebba lernado plenumas nesuperrigardatan ĉefkomponentan analizon (PCA) de la enirdatenoj: la reto nature ĉerpas el sia medio la plej statistike signifajn trajtojn.
En 1997, Amos Storkey enkondukis plibonigitan lernan regulon, kiu konsideras la lokan kampon ĉe ĉiu neŭrono kaj atingas pli grandan stokan kapaciton ol la norma Hebba lernado. Tio montras, ke eĉ ene de la sama arkitekturo la elekto de lerna algoritmo gravas profunde, principo, kiu resonas kun la pli ampleksa leciono de la esplorado pri neŭralaj retoj.
La trarompo: "Hopfield Networks is All You Need"
En 2020, teamo gvidata de Hubert Ramsauer ĉe la Johannes Kepler-Universitato en Linz publikigis artikolon kun provoka titolo, eĥo de la deveno de la transformilo: "Hopfield Networks is All You Need." Ilia kontribuo estis la matematika pruvo de tio, kion multaj suspektis: la mem-atenta mekanismo en transformiloj estas ĝuste la ĝisdatiga regulo de moderna kontinua reto de Hopfield.
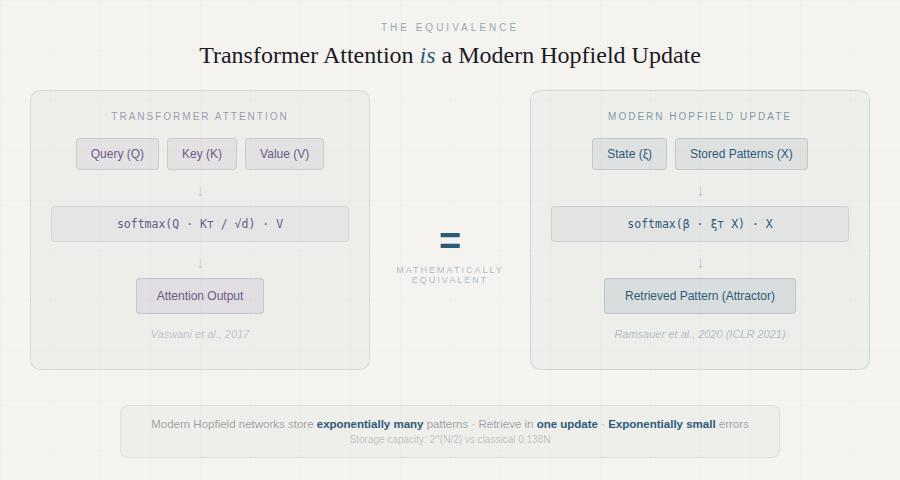
La ligo inter modernaj retoj de Hopfield kaj la atento en transformiloj. La softmax-bazita atenta mekanismo en transformiloj estas matematike ekvivalenta al unu ĝisdatiga paŝo de kontinua reto de Hopfield kun eksponenta energifunkcio. Bildo el Ramsauer et al., "Hopfield Networks is All You Need."
Ĉi tio ne estis nura analogio. La teamo montris, ke ĝeneraligante la klasikan energifunkcion de Hopfield al kontinuaj statoj kaj uzante eksponentan interagan termon, la rezulta ĝisdatiga regulo fariĝas:
Z = softmax(β · R Wq Wk⊤ Y⊤) Y Wk Wv
kio estas precize la formulo de atento en transformiloj. La moderna reto de Hopfield povas stoki eksponente multajn ŝablonojn (laŭ la dimensio de la asocia spaco), reakiras ilin per unu sola ĝisdatigo kaj havas eksponente malgrandajn reakirajn erarojn.
La artikolo identigis tri specojn de energiaj minimumoj en ĉi tiu moderna kadro: (1) tutmonda fikspunkto, kiu averaĝas ĉiujn stokitajn ŝablonojn, (2) metastabilaj statoj, kiuj averaĝas subarojn de ŝablonoj, kaj (3) fikspunktoj, kiuj stokas unuopajn ŝablonojn. Atentokapoj de transformiloj en malsupraj tavoloj emas funkcii en la tutmonda averaĝa reĝimo, dum kapoj en pli altaj tavoloj uzas metastabilajn statojn por kolekti kaj prilabori informon, trovo, kiu donas profundan komprenon pri tio, kial transformiloj funkcias tiel, kiel ili funkcias.
La praktika sekvo estis tuja: la teamo publikigis tavolojn de Hopfieldkiel enmeteblaj PyTorch-moduloj, kiuj povus anstataŭi kunigajn tavolojn (pooling), GRU/LSTM-tavolojn kaj ordinarajn atentotavolojn. En komparaj testoj ĉi tiuj Hopfield-tavoloj atingis plej altnivelajn rezultojn pri klasifikado de imunaj repertuaroj (kun pluraj centoj da miloj da kazoj por ĉiu specimeno), pri problemoj de lernado per pluraj kazoj kaj pri UCI-klasifikaj komparaj testoj, kie tradiciaj profundlernaj metodoj kutime luktas.
Ĝis decembro 2025 artikolo de Masumura kaj Taki ĉe NeurIPS iris pli for: ĝi montris, ke transpaŝo de la „adiabata proksimumo“ malkaŝas kaŝitajn statojn en la korespondo inter Hopfield kaj transformiloj, kiuj povas solvi la problemojn de rangokolapso kaj unuformeco de ĵetonoj, turmentantajn profundajn transformilojn, plibonigante la precizecon sen aldoni eĉ unu trejnan parametron.
La kreskanta konsento: kiu ankoraŭ diras tion?
Ĉi tiu argumento, ke Hopfield-retoj prezentas la sekvan paradigmon post la transformiloj, ne estas divenado. Gravaj esplorinstitucioj aktive sekvas ĝin, kaj la pruvoj amasiĝas rapide. Jen la ĉefaj voĉoj kaj artikoloj, kiuj konverĝas al la sama konkludo.
IBM Research kaj Dmitry Krotov
En januaro 2025 IBM Research publikigis ampleksan intervjuon kun Dmitry Krotov, longtempa kunlaboranto de Hopfield kaj unu el la arkitektoj de Dense Associative Memory. Krotov argumentis rekte: ĉar Hopfield-retoj spegulas la rekurajn religajn bukleojn de la cerbo, malkiel la antaŭenigan arkitekturon de 90% de nunaj AI-modeloj, ili estas „promesplena alternativo al la hodiaŭaj antaŭenigaj retoj“. Li rimarkigis, ke transformiloj prilaboras informon nur en unu direkto, kaj dum kunteksto-fenestroj plilongiĝas, la komputa komplekseco rapide kreskas. La cerbo, male, uzas rekurajn religajn bukleojn por resumi kaj konservi pasintajn informojn en memoro. Hopfield-retoj funkcias same.
Krotov ankaŭ priskribis la Energy Transformer (NeurIPS 2023), kunlaboron de IBM Research kaj Georgia Tech, kiu ne simple tavoligas komprenojn de Hopfield sur ekzistantajn transformilojn, sed anstataŭigas la tutan vicon de antaŭenigaj transformilaj blokoj per unu granda modelo de Asocia Memoro. La atentmekanismo en la Energy Transformer eksplicite malsamas de la konvencia atento: ĝi devenas de bazaj principoj de energia minimumigo, ne estas flikita sur antaŭenigan duktan procezon.
🔗 IBM Research „Searching for brain-inspired AI algorithms“ (jan. 2025)
🔗 Energy Transformer arXiv:2302.07253 (NeurIPS 2023)
Universitato Johannes Kepler – grupo de Hochreiter
Sepp Hochreiter, kunaŭtoro de la LSTM, gvidis la teamon, kiu publikigis „Hopfield Networks is All You Need“. Ilia deponejo de Hopfield-tavoloj provizas produktad-pretajn PyTorch-modulojn, kiuj servas kiel enmeteblaj anstataŭaĵoj de atentotavoloj de transformiloj, kunigaj tavoloj kaj rekuraj tavoloj. La kuna blogaĵo trairas la matematikan derivadon, kiu montras, ke la softmax-formulo de atento estas speciala okazo de la moderna Hopfield-ĝisdatiga regulo, kaj ke Hopfield-tavoloj proponas aldonajn funkciojn, kiujn ordinara atento ne povas provizi, inkluzive de statikaj lernitaj prototipoj kaj fleksebla agordo de asocia memoro.
🔗 Hopfield Networks is All You Need – ICLR 2021
NeurIPS 2025: Hopfield Attention Improves GPT and Vision Transformers
La plej freŝa pruvo venas de la decembra 2025 NeurIPS-artikolo de Masumura kaj Taki. Ili montris, ke Moderna Hopfield-Atento (MHA), kiu aldonas kaŝitajn statojn derivitajn el la plena (ne-adiabata) dinamiko de Hopfield, sisteme plibonigas kaj la lingvomodelojn GPT-2 kaj LLaMA, kaj la Vidajn Transformilojn. La plibonigoj venis sen iuj aldonaj trejnaj parametroj. Pli grave, oni trovis, ke MHA solvas la problemon de rangokolapso (kiam atentomatricoj en profundaj transformiloj degeneras, igante ĉiujn ĵetonojn konverĝi al similaj prezentoj), fundamenta patologio, kiu delonge ĝenas la skaladon de transformiloj. La aŭtoroj konkludis: "Ni esperas, ke tiu ĉi esplorado malfermos novajn eblojn por la sistema projektado de Transformil-arkitekturoj per Hopfield-retoj."
🔗 On the Role of Hidden States of Modern Hopfield Network in Transformer arXiv:2511.20698 (NeurIPS 2025)
Nature Communications: Biologie kredinda reta lernado
En majo 2024 Nature Communications publikigis laboron pri la Sparse Quantized Hopfield Network, modelo, kiu lernas per lokaj lernaj reguloj en daŭraj retaj scenaroj, ĝuste tiel, kiel faras biologiaj cerboj. Tio traktas fundamentan limigon de transformiloj, kiuj postulas nelokan retropropagadon kaj eksterretan trejnadon per zorge pretigitaj datumaroj. La artikolo prezentas Hopfield-bazitajn arkitekturojn kiel la naturan ponton inter artefaritaj neŭralaj retoj kaj neŭromorfa komputila aparataro.
🔗 A Sparse Quantized Hopfield Network for Online-Continual Memory Nature Communications (2024)
Outlier-Efficient Hopfield Layers for Large Foundation Models
Artikolo de 2024 traktis praktikan problemon en grandaj transformil-modeloj: la emon asigni atenton al neinformaj ĵetonoj (disigiloj, interpunkciaj signoj), la problemon de la "no-op outlier". Ilia solvo estis outlier-efika energifunkcio de Hopfield, kiu klasifikas tiujn ĵetonojn kaj direktas ilin al nulenergia punkto, malhelpante ke ili diluu la utilan atenton. La rezulta modelo ampleksas la Softmax₁-atenton kiel apartan okazon kaj estis validigita sur BERT, OPT kaj Vidaj Transformiloj. Jen Hopfield-teorio solvanta realajn inĝenierajn problemojn de transformiloj.
🔗 Outlier-Efficient Hopfield Layers for Large Transformer-Based Models (2024)
Transformiloj kiel energi-minimumigiloj (januaro 2026)
La plej freŝa teoria laboro, publikigita en januaro 2026, enkadrigas la tutan antaŭan pason de transformilo kiel internan energi-minimumigon, plene adoptante la Hopfield-perspektivon kiel klarigan kadron pri tio, kial transformiloj entute funkcias. La artikolo ligas maldensajn modernajn Hopfield-modelojn kun la tuta familio de atentovariantoj (softmax, sparsemax, α-entmax), montrante, ke ĉiuj ili estas apartaj okazoj de energi-bazita retrovada dinamiko.
🔗 Transformers as Intrinsic Optimizers: Forward Inference through the Energy Principle (jan. 2026)
Recenzaj artikoloj kaj komunumaj rimedoj
La pli larĝa esplorkomunumo organiziĝas ĉirkaŭ tiu ĉi konverĝo:
- "Energy-Based Learning and the Evolution of Hopfield Networks" (TechRxiv, aprilo 2025) Ampleksa recenzo, kiu spuras la tutan arkon de Hopfield (1982) tra Boltzmann-maŝinoj ĝis la reinterpreto de transformila atento kiel moderna Hopfield-dinamiko. → Legu la artikolon
- "An Energy-Based Perspective on Attention Mechanisms in Transformers" Profunda teknika blogaĵo, kiu argumentas, ke kompreni transformilojn tra la Hopfield-energia lenso "povus konduki al kvalite malsamaj plibonigoj preter tio, kio eblas sole per skalado kaj malpliigo de komputa komplekseco." → Legu la blogon
- Awesome Modern Hopfield Networks Zorge kuratorita GitHub-deponejo, kiu sekvas pli ol 50 artikolojn pri modernaj Hopfield-retoj en diversaj fakoj: asignado de havaĵoj, detekto de ŝanĝoj, rekonstruo de kreiva pensado, detekto de eksteraj-de-distribuo datumoj, klasifikado de imunaj repertuaroj, kaj pli. → Foliumi la kolekton
- "Ĉu Hopfield-retoj sufiĉas?" (Analytics India Magazine, dec. 2024) Praktikist-orientita raporto pri tio, kiel la teamo de Hochreiter montris, ke Hopfield-retoj estas „interŝanĝeblaj kun la plej modernaj transformilaj modeloj“. → Legu la artikolon
- "Nova esplorado pri Hopfield-retoj: mallonga enkonduko" (Medium, jul. 2024) Alirebla superrigardo, kiu rimarkigas, ke la konserva kapacito kreskis de 0,138N ĝis 2^(N/2) danke al eksponentaj aktivigaj funkcioj. → Legu ĉe Medium
La direkto estas klara. Ĉi tio ne estas propono de unu laboratorio nek konjekto de unu artikolo. IBM Research, la Universitato Johannes Kepler, MIT, NeurIPS, Nature Communications kaj la pli vasta komunumo de maŝinlernado konverĝas al la sama konkludo el malsamaj direktoj: la energi-bazita paradigmo de asocia memoro, kiun establis Hopfield, ne estas nur la fundamento, sur kiu transformiloj estis konstruitaj senscie – ĝi estas la kadro, kiu portos artefaritan inteligentecon preter tio, kion transformiloj sole povas atingi.
Kial tio gravas nun: la argumentoj por ŝanĝo
Garantiita konverĝo por sekurec-kritikaj sistemoj
Transformiloj produktas rezultojn, sed ne ekzistas matematika garantio de stabileco. Hopfield-retoj konverĝas al stabilaj statoj laŭ pruvo la energia funkcio malkreskas monotone. Por robotiko, aŭtonomaj veturiloj, medicinaj aparatoj kaj ĉiu sistemo, kie fidindeco ne estas intertraktebla, tio estas postulo, kiun transformiloj ne povas plenumi.
Asocia memoro kiel kerna kapablo
Se vi trejnas Hopfield-reton tiel, ke la stato (1, −1, 1, −1, 1) estu energia minimumo, kaj prezentas la difektitan enigon (1, −1, −1, −1, 1), la reto konverĝas al la ĝusta konservita ŝablono. Ĝi ne divenas nek interpolas – ĝi rulas laŭ la deklivo de la energia pejzaĝo ĝis la plej proksima altiranto. Por robotiko kun kovritaj sensiloj, enkorpigitaj sistemoj kun brua datumaro kaj ĉiu apliko, kiu postulas kompletigon de ŝablono el nekompleta enigo, tio estas transforma.
Universala optimumiga motoro
Hopfield kaj David Tank pruvis en 1985, ke Hopfield-retoj povas solvi la problemon de la vojaĝanta komizo. Se kostfunkcio povas esti skribita en la formo de la Hopfield-energio, tiam la ekvilibraj punktoj de la reto estas la solvoj. Ekde tiam la arkitekturo estis aplikata al planado de laborpostenoj, kanal-asignado en sendrataj retoj, restarigo de bildoj, analog-cifereca konvertado, movebla enrutado kaj kombineca optimumigo. Artikolo en Nature Communications de 2024 prezentis Sparse Quantized Hopfield Network por reta kontinua lernado de memoro per lokaj reguloj, same kiel faras biologiaj cerboj – kapablo, kiun transformiloj principe mankas.
Aparataro, kiu pensas sen programaro
La limigo de simetriaj pezoj (wᵢⱼ = wⱼᵢ) rekte kongruas kun analogaj elektronikaj cirkvitoj – rezistila konekto estas esence simetria. Hopfield-retoj povas esti produktataj kiel ASIC-oj aŭ FPGA-oj kun inferenco en nanosekundaj temposkaloj. La kolekto de Nature en 2025 pri neŭromorfa komputado konfirmas ĉi tiun direkton: energiefika analoga aparataro, kiu realigas neŭralan dinamikon ĉe la rando, kun enhav-adresebla memoro, kiu bezonas nek GPU-on, nek CPU-on, nek programaran stakon.
Neŭromorfaj kaj analogaj AI-blatoj, kiuj realigas la dinamikon de neŭralaj retoj rekte en aparataro. La simetria, energi-bazita strukturo de Hopfield-retoj trafe konformiĝas al rezistaj cirkvitoj kaj ebligas AI-inferon en nanosekundaj skaloj, sen la tradiciaj programaraj stakoj.
Binara kaj kontinua fleksebleco
Klasikaj Hopfield-retoj uzas binarajn neŭronojn (+1 aŭ −1); kontinuaj variantoj uzas sigmoidan aktivigon kaj diferencialajn ekvaciojn. La ĝisdatigoj povas esti malsinkronaj (unu neŭrono samtempe, kio garantias konverĝon) aŭ sinkronaj (ĉiuj samtempe, kio ebligas paralelismon). La sama arkitekturo taŭgas por mikroregilo kun kelkaj kilobajtoj da RAM, same kiel por masive paralela FPGA, kaj nun, per modernaj Hopfield-tavoloj, ankaŭ por GPU-akcelitaj profundlernaj duktoj.
Stoka kapacito: la honesta limigo
La klasika limo estas klara: reto de N neŭronoj fidinde stokas ĉirkaŭ 0.138N ŝablonojn, antaŭ ol falsaj stabilaj statoj difektas la rehavon. Tio estas reala limigo, sed ĝi estas honesta limigo. Transformiloj (transformers) ne havas puran matematikan limon pri tio, kiam ili komencos halucini.
Cetere, modernaj Hopfield-retoj (Krotov & Hopfield, 2016; Demircigil et al., 2017) atingas eksponentan stokan kapaciton per pli altordaj interagaj terminoj. La esplorado daŭre vastigas tiujn limojn: maldensaj kaj strukturitaj Hopfield-retoj, Hopfield-memoro por longaj sekvencoj kaj Hopfield-retoj por asigno de aktivaĵoj estas ĉiuj aktivaj evolufakoj, kaj artikoloj amasiĝas rapide.
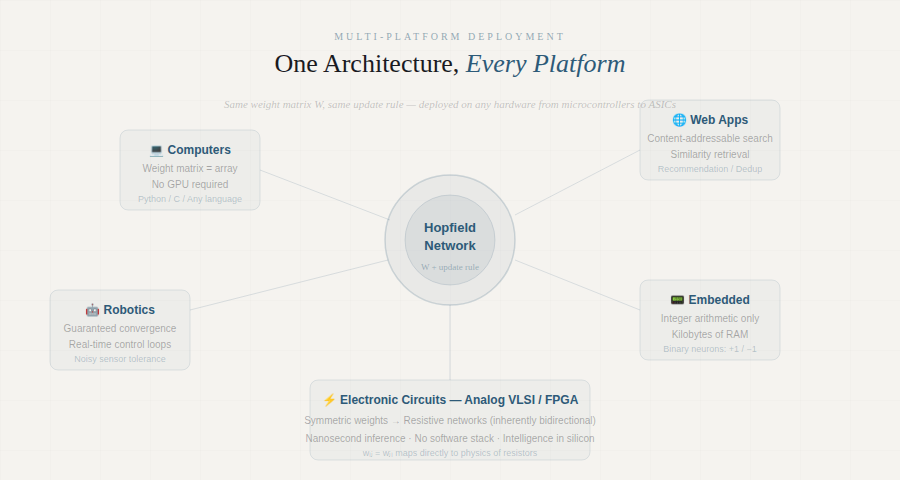
Praktika disvolvo: de komputiloj ĝis cirkvitoj
La originala vizio de la fruaj esploristoj de neŭralaj retoj estis klara: kadro, kiun oni priskribu unufoje kaj disvolvu ĉie. La arkitekturo de Hopfield realigas tion:
Komputilaj aplikaĵoj Pezmatrico kaj ĝisdatiga regulo. Neniu GPU necesas.
Interretaj aplikaĵoj Enhav-adresebla memoro por serĉo de similaĵoj, rekomendoj kaj forigo de duplikatoj.
Robotiko Garantiita konverĝo por realtempaj regaj bukloj. Motoraj ŝablonoj stokiĝas kiel altiraĵoj kaj estas rememoritaj eĉ el brua sensila enigo.
Enkonstruitaj sistemoj Binaraj Hopfield-retoj funkcias sur mikroregiloj nur per entjera aritmetiko.
Elektronikaj cirkvitoj Simetriaj pezoj konformiĝas al rezistaj retoj. Inteligento fabrikita rekte en silicio.
La vojo antaŭen
La epoko de transformiloj donis al ni eksterordinarajn lingvomaŝinojn. Sed la landlimo vastiĝas en la fizikan mondon: robotoj, sensiloj, aktuatoroj kaj realtempaj decidoj. Tiu landlimo postulas arkitekturojn stabilajn, efikajn, interpreteblajn kaj disvolveblajn sur aparataro, kiu efektive ekzistas ĉe la rando (edge).
La pruvo de 2020, ke la atento de transformiloj estas moderna Hopfield-ĝisdatiga regulo, ne estis nur matematika kuriozaĵo: ĝi malkaŝis, ke ni tutan tempon uzis Hopfield-retojn, envolvitajn en kadro, kiu kaŝis ilian veran naturon. La laboro de NeurIPS 2025, montranta ke kaŝitaj statoj de Hopfield solvas patologiojn de transformiloj kiel rangan kolapson, sugestas la sekvan paŝon: ne flikadi transformilojn per Hopfield-komprenoj, sed konstrui rekte sur la Hopfield-paradigmo mem.
John Hopfield montris al ni la vojon en 1982. Donald Hebb metis la biologiajn fundamentojn en 1949. La esplorkomunumo nun konverĝas al ĝi.
Venis la tempo ŝanĝi.
Referencoj
- Hopfield, J.J. (1982). "Neural networks and physical systems with emergent collective computational abilities." PNAS, 79(8), 2554–2558.
- Hebb, D.O. (1949). The Organization of Behavior. Wiley.
- Ramsauer, H. et al. (2020). "Hopfield Networks is All You Need." ICLR 2021. arXiv:2008.02217
- Krotov, D. & Hopfield, J.J. (2016). "Dense Associative Memory for Pattern Recognition." NeurIPS.
- Storkey, A. (1997). "Increasing the capacity of a Hopfield network without sacrificing functionality." ICANN.
- Hoover, B., Krotov, D. et al. (2023). "Energy Transformer." NeurIPS 2023. arXiv:2302.07253
- Masumura, T. & Taki, M. (2025). "On the Role of Hidden States of Modern Hopfield Network in Transformer." NeurIPS 2025. arXiv:2511.20698
- Alonso, N. & Krichmar, J. (2024). "A sparse quantized Hopfield network for online-continual memory." Nature Communications, 15, 3722. nature.com
- Hu, J.Y. et al. (2024). "Outlier-Efficient Hopfield Layers for Large Transformer-Based Models." arXiv:2404.03828
- Hu, J.Y. et al. (2026). "Transformers as Intrinsic Optimizers: Forward Inference through the Energy Principle." arXiv:2511.00907
- Hopfield, J.J. & Tank, D.W. (1985). "'Neural' Computation of Decisions in Optimization Problems." Biological Cybernetics, 52, 141–152.
- Bruck, J. (1990). "On the convergence properties of the Hopfield model." Proceedings of the IEEE.
- Krotov, D. (2025). "Searching for brain-inspired AI algorithms." IBM Research Blog. research.ibm.com
- "Energy-Based Learning and the Evolution of Hopfield Networks." TechRxiv, aprilo 2025. techrxiv.org

