
Aprendizaje hebbiano y redes de Hopfield: la arquitectura que siempre fue más lista que los transformers
Durante la última década, los transformers y sus mecanismos de atención han dominado el panorama de la IA. De GPT a BERT y a los Vision Transformers, el lema «attention is all you need» cambió nuestra forma de pensar el aprendizaje automático. Los sistemas traductores, esos pipelines codificador-decodificador que convierten datos de una representación a otra, se convirtieron en la columna vertebral de todo, desde el procesamiento del lenguaje hasta la generación de imágenes. Fueron revolucionarios. Fueron potentes.
Y ahora se topan con un muro.
La ironía es que la solución existe desde 1982. Ese año, John Hopfield publicó un artículo en las Proceedings of the National Academy of Sciences que presentaba una red neuronal recurrente con una propiedad que los transformers nunca han logrado de verdad: la convergencia garantizada hacia estados estables mediante la minimización de energía. La red de Hopfield no se limitaba a aprender patrones: los almacenaba como atractores físicos en un paisaje de energía, recuperables incluso a partir de entradas ruidosas o incompletas.
La comunidad de la IA apenas empieza a interiorizar lo que las comunidades de la física y la neurociencia saben desde hace décadas: el enfoque asociativo y basado en la energía para la computación neuronal no es una curiosidad histórica, sino un paradigma fundacional sobre el que la era de los transformers construyó sin llegar a entenderlo del todo.
El techo de los transformers
Los transformers funcionan calculando, mediante la autoatención, las relaciones entre todos los elementos de una secuencia a la vez. Eso es brillante para el lenguaje. Es brillante para los datos estructurados con patrones secuenciales claros. Pero el mundo real, el de la robótica, los circuitos embebidos, la toma de decisiones guiada por sensores y la computación en el borde, no se organiza en secuencias ordenadas que esperan a que se les preste atención.
La arquitectura transformer da por supuesta la abundancia: abundante cómputo, abundante memoria, abundante energía. La autoatención escala de forma cuadrática con la longitud de la secuencia. Las capas feed-forward crecen de forma lineal, pero masiva. Cuando despliegas un sistema basado en transformers en un robot móvil que se mueve por un almacén, o lo integras en un circuito electrónico que controla un brazo de fabricación, esas suposiciones se vienen abajo.
El paradigma del traductor arrastra su propia limitación: trata la inteligencia sobre todo como un problema de conversión entre representaciones fijas. Codifica la entrada. Decodifica la salida. Pero la inteligencia real no se limita a traducir: recuerda, asocia y converge hacia interpretaciones estables incluso cuando la entrada está degradada o es ambigua.
Llevamos tiempo parcheando estos problemas con cuantización, destilación, poda y cien trucos de optimización más. Los estudios sobre IA en el borde de 2025 confirman que desplegar aprendizaje profundo en hardware embebido sigue estando «limitado por estrictas restricciones de memoria, cómputo y energía». Pero optimizar una arquitectura fundamentalmente desajustada solo aplaza el ajuste de cuentas. Lo que necesitamos es una arquitectura que trate la memoria, la estabilidad y la eficiencia energética como principios básicos, no como ocurrencias tardías.
Entra en escena la red neuronal de Hopfield
Una red de Hopfield es una red neuronal recurrente formada por una sola capa de neuronas, en la que cada neurona está conectada con todas las demás salvo consigo misma. La red forma un grafo completo no dirigido: cada par de neuronas comparte un peso de conexión simétrico, es decir, la fuerza de la neurona i a la neurona j es idéntica a la fuerza de ja j. No hay autoconexiones (wᵢᵢ = 0). No hay jerarquía de capas. No hay una cadena de procesamiento secuencial. En su lugar, toda la red funciona como un único sistema dinámico interconectado que evoluciona con el tiempo hacia estados de equilibrio estables.
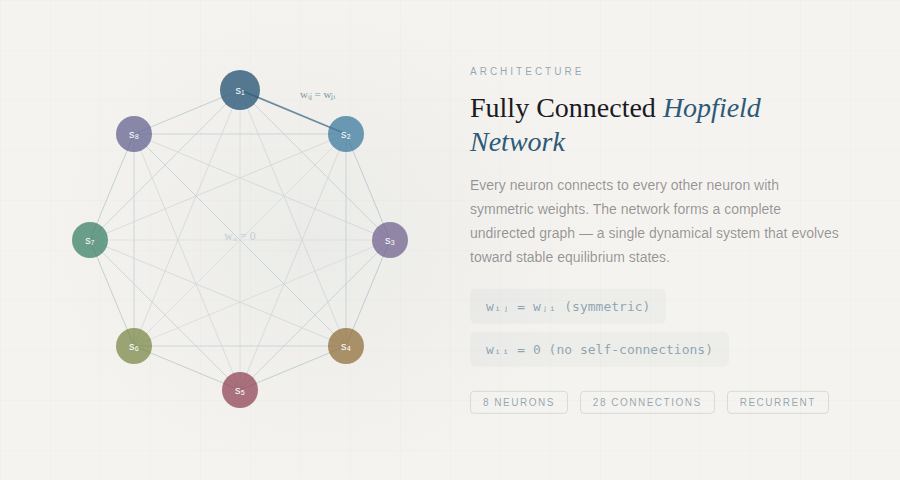
Una red de Hopfield con neuronas totalmente conectadas. Cada nodo se conecta con todos los demás mediante pesos simétricos (wᵢⱼ = wⱼᵢ), formando un grafo completo no dirigido. No existen autoconexiones.
La elegancia de esta arquitectura reside en su función de energía. Hopfield demostró que su red posee una función de energía de Lyapunov asociada:
E = −½ Σᵢ Σⱼ wᵢⱼ sᵢ sⱼ − Σᵢ θᵢ sᵢ
Se garantiza que esta energía disminuye (o se mantiene constante) con cada actualización de una neurona. La red siempre converge: nunca oscila sin fin, nunca diverge, nunca queda atrapada en bucles de cómputo infinitos. Se estabiliza. En 1990, Bruck demostró que este comportamiento de estabilización está relacionado con los cortes del grafo asociado: en cada paso de actualización, la red ejecuta en esencia un algoritmo voraz para el problema del corte máximo (max-cut).
Y donde la red se estabiliza es donde vive la inteligencia. Los patrones almacenados corresponden a los mínimos locales de la función de energía, los valles del paisaje energético. Cuando le presentas a la red una versión corrupta, ruidosa o incompleta de un patrón almacenado, la dinámica hace rodar su estado cuesta abajo hasta que cae en el valle más cercano: el patrón almacenado que mejor coincide con la entrada.
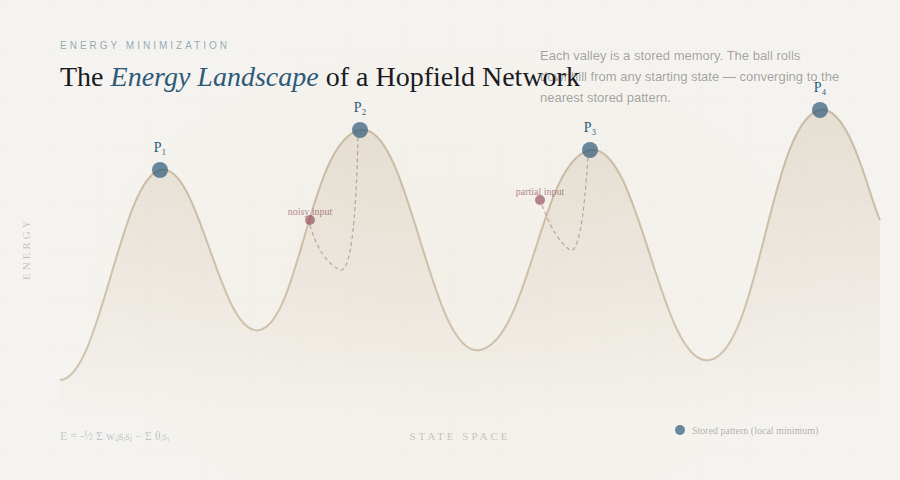
El paisaje energético de una red de Hopfield. Cada valle (mínimo local) corresponde a un patrón de memoria almacenado. Partiendo de cualquier estado inicial, la dinámica de la red rueda "cuesta abajo" hasta asentarse en el atractor más cercano, y así recupera el patrón completo a partir de una entrada parcial o ruidosa.
Esto es memoria asociativa direccionable por contenido la capacidad de recordar memorias completas a partir de indicios parciales, algo que los cerebros biológicos hacen sin esfuerzo pero que los transformers solo pueden aproximar mediante un cómputo costoso.
La conexión con la física es profunda. La red de Hopfield es matemáticamente equivalente a un modelo de Ising, el mismo marco que se usa para describir el magnetismo en la mecánica estadística. El modelo de vidrio de espín de Sherrington-Kirkpatrick, publicado en 1975, es en esencia una red de Hopfield con pesos aleatorios. La intuición de Hopfield fue aprovechar esta propiedad de forma deliberada, diseñando el paisaje energético para que cada mínimo corresponda a un patrón almacenado útil.
Aprendizaje hebbiano: las neuronas que se activan juntas se conectan juntas
La regla de aprendizaje que hace funcionar las redes de Hopfield tiene raíces aún más antiguas, que se remontan al libro de Donald Hebb de 1949, The Organization of Behavior, que propuso lo que hoy se considera el principio fundacional de la teoría del aprendizaje neuronal.
La intuición de Hebb era engañosamente simple: cuando una célula presináptica participa de forma repetida y persistente en la activación de una célula postsináptica, la conexión sináptica entre ambas se fortalece. "Las neuronas que se activan juntas, se conectan juntas", aunque el propio Hebb fue más preciso y subrayó que la célula A debe participar en provocar la activación de la célula B, no limitarse a activarse al mismo tiempo. Esta causalidad temporal anticipó lo que hoy se conoce como plasticidad dependiente del tiempo de los impulsos (STDP), confirmada experimentalmente décadas después, incluida la investigación pionera de Eric Kandel con la babosa de mar Aplysia californica.
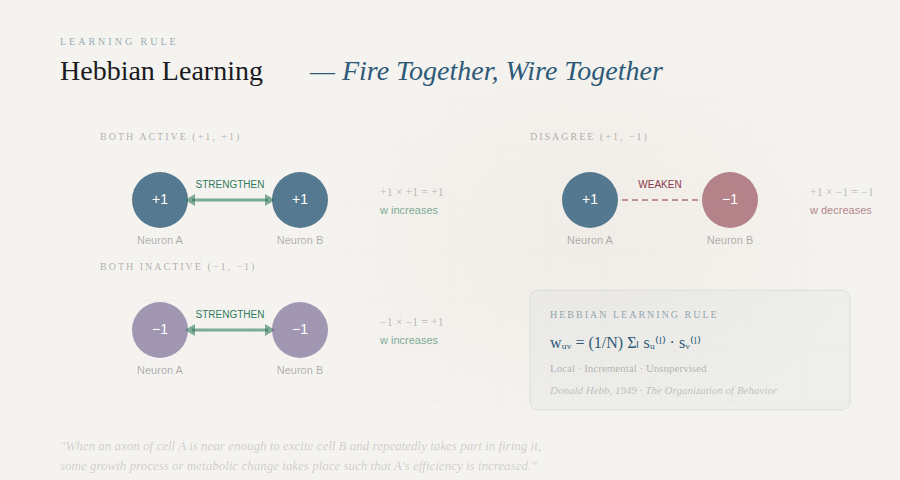
El aprendizaje hebbiano: cuando dos neuronas conectadas se activan juntas de forma repetida, la sinapsis que las une se fortalece. Este principio, «las neuronas que se activan juntas se conectan juntas», es el fundamento biológico de cómo las redes de Hopfield almacenan patrones.
En la red de Hopfield, el aprendizaje hebbiano se implementa así:
wᵤᵥ = (1/N) Σₗ sᵤ(l) · sᵥ(l) para todos los patrones almacenados l, donde u ≠ v
Cuando dos neuronas tienen el mismo estado en un patrón dado (ambas +1 o ambas −1), su producto es positivo y refuerza la conexión excitadora. Cuando discrepan, el producto es negativo y crea una conexión inhibidora. El efecto acumulado esculpe un paisaje de energía con un valle en cada patrón almacenado.
La regla hebbiana es local (cada actualización de un peso usa solo la información disponible para las dos neuronas conectadas) e incremental (se pueden almacenar nuevos patrones sin volver a procesar los anteriores). Resulta notable que se pueda demostrar matemáticamente que el aprendizaje hebbiano realiza, sin supervisión, un análisis de componentes principales (PCA) de los datos de entrada: la red extrae de forma natural las características estadísticamente más significativas de su entorno.
En 1997, Amos Storkey presentó una regla de aprendizaje mejorada que tiene en cuenta el campo local de cada neurona y logra una mayor capacidad de almacenamiento que el aprendizaje hebbiano estándar. Esto demuestra que, incluso dentro de la misma arquitectura, la elección del algoritmo de aprendizaje importa mucho, un principio que resuena con la lección más amplia de la investigación en redes neuronales.
El gran avance: «Hopfield Networks is All You Need»
En 2020, un equipo dirigido por Hubert Ramsauer en la Universidad Johannes Kepler de Linz publicó un artículo con un título deliberadamente provocador, que hacía eco del origen del transformer: «Hopfield Networks is All You Need». Su aportación fue la demostración matemática de lo que muchos sospechaban: el mecanismo de autoatención de los transformers es exactamente la regla de actualización de una red de Hopfield continua moderna.
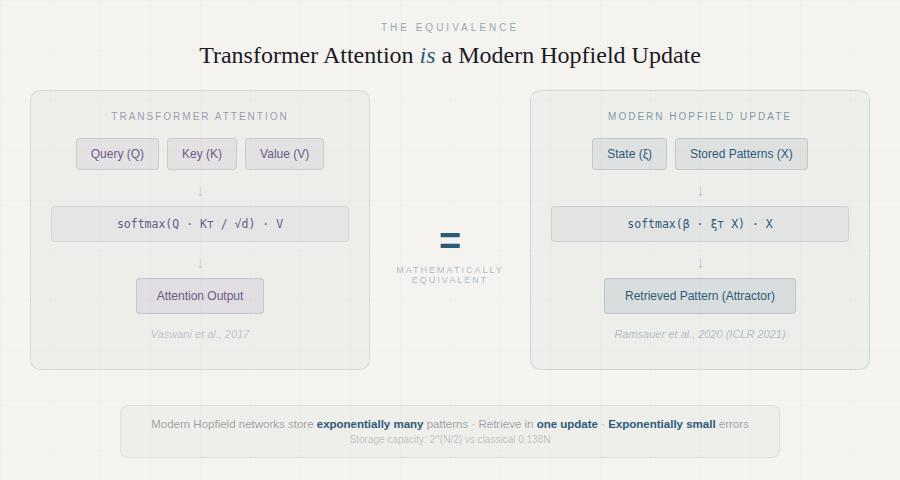
La conexión entre las redes de Hopfield modernas y la atención de los transformers. El mecanismo de atención basado en softmax de los transformers equivale matemáticamente a un paso de actualización de una red de Hopfield continua con función de energía exponencial. Imagen de Ramsauer et al., «Hopfield Networks is All You Need».
Esto no era una simple analogía. El equipo mostró que, al generalizar la función de energía clásica de Hopfield a estados continuos y usar un término de interacción exponencial, la regla de actualización resultante queda así:
Z = softmax(β · R Wq Wk⊤ Y⊤) Y Wk Wv
que es precisamente la fórmula de atención del transformer. La red de Hopfield moderna puede almacenar un número exponencial de patrones (en función de la dimensión del espacio asociativo), los recupera en una sola actualización y tiene errores de recuperación exponencialmente pequeños.
El artículo identificó tres tipos de mínimos de energía en este marco moderno: (1) un punto fijo global que promedia todos los patrones almacenados, (2) estados metaestables que promedian subconjuntos de patrones, y (3) puntos fijos que almacenan patrones individuales. Las cabezas de los transformers en las capas inferiores tienden a operar en el régimen de promedio global, mientras que las de las capas superiores usan estados metaestables para recopilar y procesar información, un hallazgo que ofrece una visión profunda de por qué los transformers funcionan como lo hacen.
La implicación práctica fue inmediata: el equipo publicó las capas de Hopfieldcomo módulos de PyTorch intercambiables que podrían sustituir las capas de pooling, las capas GRU/LSTM y las capas de atención estándar. En las pruebas comparativas, estas capas Hopfield lograron resultados de vanguardia en la clasificación de repertorios inmunitarios (con varios cientos de miles de instancias por muestra), en problemas de aprendizaje de múltiples instancias y en los benchmarks de clasificación de UCI, donde los métodos tradicionales de aprendizaje profundo suelen tener dificultades.
En diciembre de 2025, un artículo de NeurIPS de Masumura y Taki fue más allá y demostró que ir más allá de la «aproximación adiabática» revela estados ocultos en la correspondencia entre Hopfield y los transformers, capaces de resolver los problemas de colapso de rango y de uniformidad de tokens que afectan a los transformers profundos, mejorando la precisión sin añadir ningún parámetro de entrenamiento.
El consenso crece: ¿quién más lo está diciendo?
Este argumento de que las redes de Hopfield representan el siguiente paradigma después de los transformers no es una especulación. Importantes instituciones de investigación lo están persiguiendo activamente, y las pruebas se acumulan con rapidez. Estas son las voces y los artículos clave que convergen en la misma conclusión.
IBM Research y Dmitry Krotov
En enero de 2025, IBM Research publicó una extensa entrevista con Dmitry Krotov, colaborador de larga data de Hopfield y uno de los arquitectos de la Memoria Asociativa Densa (Dense Associative Memory). Krotov lo planteó sin rodeos: dado que las redes de Hopfield reproducen los bucles de retroalimentación recurrentes del cerebro, a diferencia de la arquitectura feedforward del 90 % de los modelos de IA actuales, representan «una alternativa prometedora a las redes feedforward de hoy». Señaló que los transformers procesan la información en una sola dirección y que, a medida que las ventanas de contexto se alargan, la complejidad computacional aumenta rápidamente. El cerebro, en cambio, usa bucles de retroalimentación recurrentes para resumir y almacenar en la memoria la información pasada. Las redes de Hopfield funcionan del mismo modo.
Krotov también describió el Energy Transformer (NeurIPS 2023), una colaboración entre IBM Research y Georgia Tech que no se limita a añadir ideas de Hopfield a los transformers existentes, sino que sustituye toda la secuencia de bloques transformer feedforward por un único gran modelo de Memoria Asociativa. El mecanismo de atención del Energy Transformer es explícitamente distinto de la atención convencional: se deriva de los principios fundamentales de la minimización de energía, y no se le añade como un parche a una canalización feedforward.
🔗 IBM Research: «Searching for brain-inspired AI algorithms» (enero de 2025)
🔗 Energy Transformer arXiv:2302.07253 (NeurIPS 2023)
Universidad Johannes Kepler - el grupo de Hochreiter
Sepp Hochreiter, coinventor de la LSTM, lideró el equipo que publicó «Hopfield Networks is All You Need». Su repositorio de capas Hopfield ofrece módulos de PyTorch listos para producción que sirven como sustitutos directos de las capas de atención de los transformers, las capas de pooling y las capas recurrentes. La entrada de blog complementaria recorre la derivación matemática que demuestra que la fórmula de atención softmax es un caso especial de la regla de actualización de Hopfield moderna y que las capas Hopfield ofrecen funcionalidades adicionales que la atención estándar no puede proporcionar, como los prototipos estáticos aprendidos y las configuraciones flexibles de memoria asociativa.
🔗 Hopfield Networks is All You Need - ICLR 2021
NeurIPS 2025: Hopfield Attention Improves GPT and Vision Transformers
La evidencia más reciente procede del artículo de NeurIPS de diciembre de 2025 de Masumura y Taki. Demostraron que Atención de Hopfield moderna (MHA) que añade estados ocultos derivados de la dinámica completa (no adiabática) de Hopfield, mejora de forma sistemática tanto los modelos de lenguaje GPT-2 y LLaMA como los Vision Transformers. Las mejoras llegaron sin ningún parámetro de entrenamiento adicional. Y lo más importante: se comprobó que MHA resuelve el problema del colapso de rango (cuando las matrices de atención de los transformers profundos se degeneran y todos los tokens convergen hacia representaciones parecidas), una patología fundamental que lleva tiempo lastrando los esfuerzos por escalar los transformers. Los autores concluyen: «Esperamos que esta investigación abra nuevas posibilidades para el diseño sistemático de arquitecturas Transformer a partir de redes de Hopfield».
🔗 On the Role of Hidden States of Modern Hopfield Network in Transformer arXiv:2511.20698 (NeurIPS 2025)
Nature Communications: aprendizaje en línea biológicamente plausible
En mayo de 2024, Nature Communications publicó un trabajo sobre la Sparse Quantized Hopfield Network, un modelo que aprende con reglas de aprendizaje locales en escenarios continuos y en línea, exactamente como lo hacen los cerebros biológicos. Esto aborda una limitación fundamental de los transformers, que requieren retropropagación no local y entrenamiento fuera de línea con conjuntos de datos seleccionados. El artículo sitúa las arquitecturas basadas en Hopfield como el puente natural entre las redes neuronales artificiales y el hardware de computación neuromórfica.
🔗 A Sparse Quantized Hopfield Network for Online-Continual Memory Nature Communications (2024)
Capas de Hopfield eficientes frente a valores atípicos para grandes modelos fundacionales
Un artículo de 2024 abordó un problema práctico de los grandes modelos transformer: la tendencia a asignar atención a tokens poco informativos (delimitadores, signos de puntuación), el problema de los valores atípicos «no-op». Su solución fue una función de energía de Hopfield eficiente frente a valores atípicos que clasifica esos tokens y los dirige a un punto de energía cero, evitando que diluyan la atención útil. El modelo resultante engloba la atención Softmax₁ como caso particular y se validó en BERT, OPT y Vision Transformers. Es la teoría de Hopfield resolviendo problemas reales de ingeniería de transformers.
🔗 Outlier-Efficient Hopfield Layers for Large Transformer-Based Models (2024)
Los transformers como minimizadores de energía (enero de 2026)
El trabajo teórico más reciente, publicado en enero de 2026, plantea todo el paso hacia delante del transformer como una minimización de energía intrínseca, adoptando por completo la perspectiva de Hopfield como el marco que explica por qué los transformers funcionan. El artículo conecta los modelos de Hopfield modernos dispersos con toda la familia de variantes de atención (softmax, sparsemax, α-entmax) y muestra que todas son casos particulares de una dinámica de recuperación basada en energía.
🔗 Transformers as Intrinsic Optimizers: Forward Inference through the Energy Principle (enero de 2026)
Artículos de revisión y recursos de la comunidad
La comunidad investigadora en general se está organizando en torno a esta convergencia:
- "Energy-Based Learning and the Evolution of Hopfield Networks" (TechRxiv, abril de 2025). Una revisión exhaustiva que recorre todo el arco, desde Hopfield (1982) y las máquinas de Boltzmann hasta la reinterpretación de la atención de los transformers como dinámica de Hopfield moderna. → Leer el artículo
- "An Energy-Based Perspective on Attention Mechanisms in Transformers" Un blog técnico en profundidad que sostiene que entender los transformers a través de la lente de la energía de Hopfield «podría conducir a mejoras cualitativamente distintas, más allá de lo que es posible confiando solo en el escalado y en la reducción de la complejidad computacional». → Leer el blog
- Awesome Modern Hopfield Networks Un repositorio curado de GitHub que reúne más de 50 artículos sobre redes de Hopfield modernas en distintos ámbitos: asignación de activos, detección de cambios, reconstrucción del pensamiento creativo, detección de datos fuera de distribución, clasificación de repertorios inmunitarios y mucho más. → Explorar la colección
- «¿Son las redes de Hopfield todo lo que necesitas?» (Analytics India Magazine, dic. 2024) Una cobertura orientada a profesionales sobre cómo el equipo de Hochreiter demostró que las redes de Hopfield son «intercambiables con los modelos transformer de última generación». → Leer el artículo
- «New Research in Hopfield Networks: A Short Intro» (Medium, julio 2024) Una introducción accesible que señala que la capacidad de almacenamiento ha pasado de 0,138N a 2^(N/2) gracias a las funciones de activación exponenciales. → Leer en Medium
La trayectoria es clara. No se trata de la propuesta de un solo laboratorio ni de la especulación de un solo artículo. IBM Research, la Universidad Johannes Kepler, el MIT, NeurIPS, Nature Communications y la comunidad más amplia del aprendizaje automático están convergiendo en la misma conclusión desde direcciones distintas: el paradigma de memoria asociativa basado en la energía que estableció Hopfield no es solo el cimiento sobre el que se construyeron los transformers sin saberlo, sino el marco que llevará a la IA más allá de lo que los transformers pueden lograr por sí solos.
Por qué importa ahora: el argumento para cambiar
Convergencia garantizada para sistemas críticos para la seguridad
Los transformers producen resultados, pero no existe ninguna garantía matemática de estabilidad. Las redes de Hopfield convergen a estados estables por demostración la función de energía disminuye de forma monótona. Para la robótica, los vehículos autónomos, los dispositivos médicos y cualquier sistema donde la fiabilidad no sea negociable, este es un requisito que los transformers no pueden ofrecer.
La memoria asociativa como capacidad central
Si entrenas una red de Hopfield de modo que el estado (1, −1, 1, −1, 1) sea un mínimo de energía y le presentas la entrada corrupta (1, −1, −1, −1, 1), la red converge hacia el patrón almacenado correcto. No adivina ni interpola: rueda cuesta abajo por el paisaje de energía hasta el atractor más cercano. Para la robótica con sensores ocluidos, los sistemas embebidos con datos ruidosos y cualquier aplicación que requiera completar patrones a partir de una entrada parcial, esto es transformador.
Un motor de optimización universal
Hopfield y David Tank demostraron en 1985 que las redes de Hopfield pueden resolver el problema del viajante. Si una función de coste se puede escribir con la forma de la energía de Hopfield, entonces los puntos de equilibrio de la red son las soluciones. Desde entonces, la arquitectura se ha aplicado a la programación de talleres (job-shop scheduling), la asignación de canales en redes inalámbricas, la restauración de imágenes, la conversión analógico-digital, el enrutamiento móvil y la optimización combinatoria. Un artículo de Nature Communications de 2024 presentó una Sparse Quantized Hopfield Network para el aprendizaje de memoria continuo en línea con reglas locales, del mismo modo que lo hacen los cerebros biológicos, una capacidad de la que los transformers carecen por completo.
Hardware que piensa sin software
La restricción de pesos simétricos (wᵢⱼ = wⱼᵢ) se traduce directamente en circuitos electrónicos analógicos: una conexión resistiva es simétrica por naturaleza. Las redes de Hopfield pueden fabricarse como ASIC o FPGA, con inferencia a escala de nanosegundos. La colección de Nature de 2025 sobre computación neuromórfica confirma esta dirección: hardware analógico de bajo consumo que implementa dinámicas neuronales en el borde, con memoria direccionable por contenido que no necesita GPU, ni CPU, ni pila de software.
Chips de IA neuromórficos y analógicos que implementan la dinámica de las redes neuronales directamente en el hardware. La estructura simétrica y basada en energía de las redes de Hopfield encaja de forma natural con los circuitos resistivos, y permite realizar inferencia de IA en escalas de nanosegundos, sin las pilas de software tradicionales.
Flexibilidad binaria y continua
Las redes de Hopfield clásicas usan neuronas binarias (+1 o −1); las variantes continuas emplean activación sigmoidea y ecuaciones diferenciales. Las actualizaciones pueden ser asíncronas (una neurona a la vez, lo que garantiza la convergencia) o síncronas (todas a la vez, lo que permite el paralelismo). La misma arquitectura se adapta desde un microcontrolador con kilobytes de RAM hasta una FPGA masivamente paralela y, ahora, con las capas de Hopfield modernas, a los flujos de aprendizaje profundo acelerados por GPU.
Capacidad de almacenamiento: la limitación honesta
La limitación clásica es clara: una red de N neuronas almacena de forma fiable aproximadamente 0,138N patrones antes de que los estados espurios degraden la recuperación. Es una restricción real, pero es una restricción honesta. Los transformers no tienen un límite matemático claro que diga cuándo empezarán a alucinar.
Además, las redes de Hopfield modernas (Krotov & Hopfield, 2016; Demircigil et al., 2017) alcanzan una capacidad de almacenamiento exponencial gracias a términos de interacción de orden superior. La investigación sigue ampliando estos límites: las redes de Hopfield dispersas y estructuradas, la memoria de Hopfield para secuencias largas y las redes de Hopfield para la asignación de activos son áreas en pleno desarrollo, con artículos que se acumulan a gran velocidad.
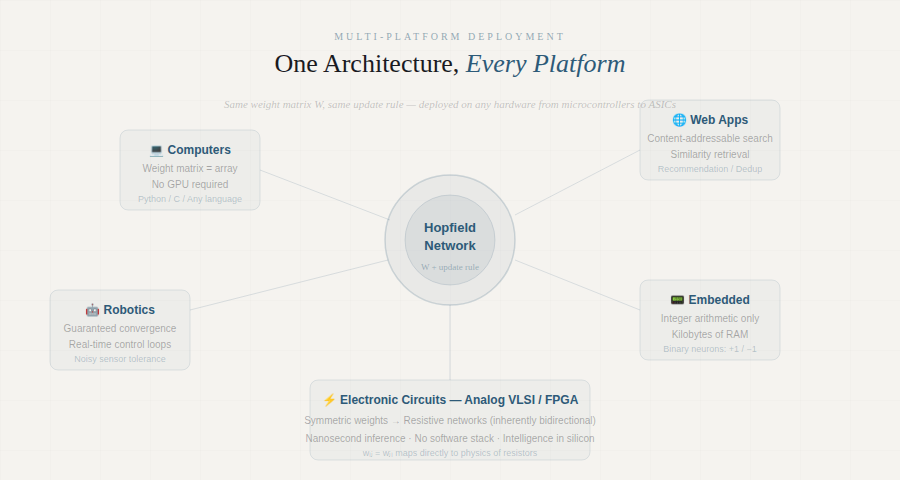
Despliegue práctico: de los PC a los circuitos
La visión original de los primeros investigadores de redes neuronales era clara: un marco que pudiera describirse una vez y desplegarse en cualquier parte. La arquitectura de Hopfield lo hace realidad:
Aplicaciones de computadora Una matriz de pesos y una regla de actualización. Sin necesidad de GPU.
Aplicaciones de internet Memoria direccionable por contenido para búsqueda por similitud, recomendación y eliminación de duplicados.
Robótica Convergencia garantizada para bucles de control en tiempo real. Los patrones motores se almacenan como atractores y se recuperan incluso a partir de señales ruidosas de los sensores.
Sistemas embebidos Las redes de Hopfield binarias funcionan en microcontroladores usando solo aritmética de enteros.
Circuitos electrónicos Los pesos simétricos se corresponden con redes resistivas. La inteligencia, fabricada directamente en silicio.
El camino a seguir
La era de los transformers nos dio máquinas de lenguaje extraordinarias. Pero la frontera se está expandiendo hacia el mundo físico: robots, sensores, actuadores y decisiones en tiempo real. Esa frontera exige arquitecturas estables, eficientes, interpretables y que se puedan desplegar en el hardware que realmente existe en el borde.
La demostración de 2020 de que la atención de los transformers es una regla de actualización de Hopfield moderna no fue solo una curiosidad matemática: reveló que llevábamos todo este tiempo usando redes de Hopfield, envueltas en un marco que ocultaba su verdadera naturaleza. El trabajo de NeurIPS 2025, que muestra que los estados ocultos de Hopfield resuelven patologías de los transformers como el colapso de rango, apunta al siguiente paso: no parchear los transformers con ideas de Hopfield, sino construir directamente sobre el propio paradigma de Hopfield.
John Hopfield nos mostró el camino en 1982. Donald Hebb sentó las bases biológicas en 1949. La comunidad investigadora está convergiendo ahora hacia ello.
Es hora de cambiar.
Referencias
- Hopfield, J.J. (1982). "Neural networks and physical systems with emergent collective computational abilities." PNAS, 79(8), 2554–2558.
- Hebb, D.O. (1949). The Organization of BehaviorWiley.
- Ramsauer, H. et al. (2020). "Hopfield Networks is All You Need." ICLR 2021. arXiv:2008.02217
- Krotov, D. & Hopfield, J.J. (2016). "Dense Associative Memory for Pattern Recognition." NeurIPS.
- Storkey, A. (1997). "Increasing the capacity of a Hopfield network without sacrificing functionality." ICANN.
- Hoover, B., Krotov, D. et al. (2023). "Energy Transformer." NeurIPS 2023. arXiv:2302.07253
- Masumura, T. & Taki, M. (2025). "On the Role of Hidden States of Modern Hopfield Network in Transformer." NeurIPS 2025. arXiv:2511.20698
- Alonso, N. & Krichmar, J. (2024). "A sparse quantized Hopfield network for online-continual memory." Nature Communications, 15, 3722. nature.com
- Hu, J.Y. et al. (2024). "Outlier-Efficient Hopfield Layers for Large Transformer-Based Models." arXiv:2404.03828
- Hu, J.Y. et al. (2026). "Transformers as Intrinsic Optimizers: Forward Inference through the Energy Principle." arXiv:2511.00907
- Hopfield, J.J. & Tank, D.W. (1985). "'Neural' Computation of Decisions in Optimization Problems." Biological Cybernetics, 52, 141–152.
- Bruck, J. (1990). "On the convergence properties of the Hopfield model." Proceedings of the IEEE.
- Krotov, D. (2025). "Searching for brain-inspired AI algorithms." IBM Research Blog. research.ibm.com
- "Energy-Based Learning and the Evolution of Hopfield Networks." TechRxiv, abril de 2025. techrxiv.org

