
Hebbi õppimine kohtub Hopfieldi võrkudega: arhitektuur, mis oli alati transformeritest targem
Viimase kümnendi jooksul on transformerid ja nende tähelepanumehhanismid tehisintellekti maastikku valitsenud. GPT-st BERT-ini ja Vision Transformeriteni: mantra „tähelepanu on kõik, mida vajad“ muutis meie arusaama masinõppest. Tõlkijasüsteemid ehk kodeerija-dekodeerija torujuhtmed, mis teisendavad andmeid ühest esitusest teise, said kõige alustalaks, alates keeletöötlusest kuni pildiloomeni. Need olid revolutsioonilised. Need olid võimsad.
Ja nüüd on need jõudnud müürini.
Iroonia seisneb selles, et lahendus on olemas olnud juba aastast 1982. Sel aastal avaldas John Hopfield ajakirjas Proceedings of the National Academy of Sciences artikli, mis tutvustas rekurrentset närvivõrku omadusega, milleni transformerid pole tegelikult kunagi jõudnud: garanteeritud koondumine stabiilsetesse olekutesse energia minimeerimise kaudu. Hopfieldi võrk ei õppinud mustreid lihtsalt selgeks, vaid salvestas need füüsiliste atraktoritena energiamaastikule, kust neid sai kätte ka müraste või puudulike sisendite põhjal.
Tehisintellekti kogukond hakkab alles nüüd mõistma seda, mida füüsika ja neuroteaduse kogukonnad on teadnud aastakümneid: närvilise arvutuse energiapõhine assotsiatiivne lähenemine ei ole ajalooline kurioosum, vaid aluspõhimõte, millele transformerite ajastu on küll ehitanud, kuid mida ta pole täielikult mõistnud.
Transformerite lagi
Transformerid arvutavad enesetähelepanu abil korraga välja seosed jada kõigi elementide vahel. See sobib suurepäraselt keele jaoks. See sobib suurepäraselt ka struktureeritud andmetele, milles on selged järjestikused mustrid. Kuid päris maailm, see tähendab robootika, sardsüsteemid, sensoritel põhinev otsustamine ja servarvutus, ei korralda ennast korralikeks jadadeks, mis ootaksid, et neile tähelepanu pöörataks.
Transformeri arhitektuur eeldab külluslikkust: külluslikku arvutusvõimsust, külluslikku mälu, külluslikku energiat. Enesetähelepanu kasvab jada pikkusega ruutsõltuvuses. Edasisuunatud kihid kasvavad küll lineaarselt, kuid tohutult. Kui paigaldada transformeril põhinev süsteem laos liikuvale mobiilsele robotile või põimida see tootmismanipulaatorit juhtivasse elektroonikalülitusse, kukuvad need eeldused kokku.
Tõlkijaparadigmal on omaenda piirang: see käsitleb intelligentsust peamiselt teisendusülesandena kindlate esituste vahel. Kodeeri sisend. Dekodeeri väljund. Tõeline intelligentsus aga ei tõlgi lihtsalt, vaid see mäletab, see seostab ja see koondub stabiilsetele tõlgendustele ka siis, kui sisend on moonutatud või mitmetähenduslik.
Oleme neid probleeme lappinud kvantimise, destilleerimise, kärpimise ja sajaviiekümne muu optimeerimisvõttega. 2025. aasta servtehisintellekti ülevaated kinnitavad, et süvaõppe juurutamist sardriistvarale „piiravad jätkuvalt ranged mälu-, arvutus- ja energiapiirangud“. Kuid põhimõtteliselt sobimatu arhitektuuri optimeerimine lükkab arvete tasumise aega vaid edasi. Meil on vaja arhitektuuri, mis peab mälu, stabiilsust ja energiatõhusust esimesteks põhimõteteks, mitte tagantjärele mõtteks.
Sisenegu Hopfieldi närvivõrk
Hopfieldi võrk on rekurrentne närvivõrk, mis koosneb ühest neuronite kihist, kus iga neuron on ühendatud kõigi teiste neuronitega peale iseenda. Võrk moodustab täieliku suunamata graafi: iga neuronipaar jagab sümmeetrilist ühenduskaalu, mis tähendab, et ühenduse tugevus neuronilt i neuronile j on täpselt sama mis neuronilt j → i. Enesesiseseid ühendusi pole (wᵢᵢ = 0). Kihilist hierarhiat pole. Järjestikust töötlusahelat pole. Kogu võrk toimib hoopis ühtse, omavahel seotud dünaamilise süsteemina, mis areneb ajas stabiilsete tasakaaluseisundite poole.
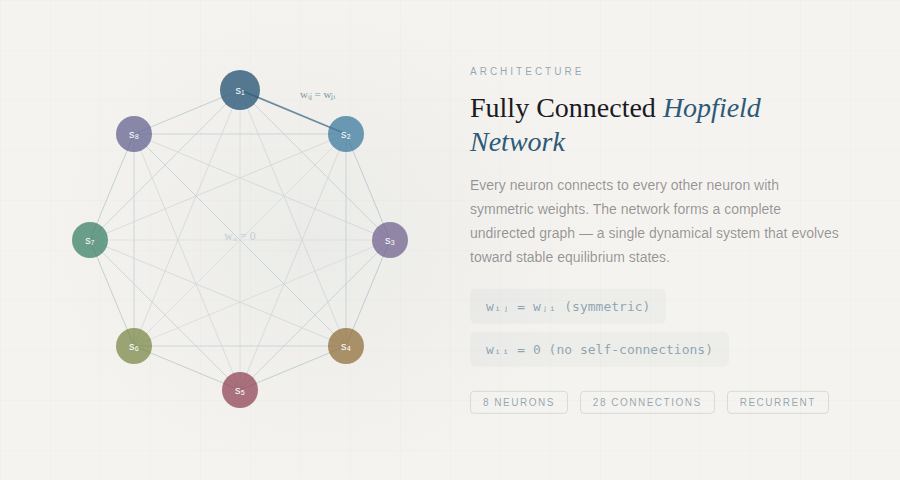
Täielikult seotud neuronitega Hopfieldi võrk. Iga sõlm on ühendatud kõigi teistega sümmeetriliste kaaludega (wᵢⱼ = wⱼᵢ), moodustades täieliku suunamata graafi. Enesesiseseid ühendusi ei ole.
Selle arhitektuuri elegants peitub tema energiafunktsioonis. Hopfield tõestas, et tema võrguga on seotud Ljapunovi energiafunktsioon:
E = −½ Σᵢ Σⱼ wᵢⱼ sᵢ sⱼ − Σᵢ θᵢ sᵢ
See energia ei saa iga neuroni uuendusega kunagi kasvada, see väheneb või jääb samaks. Võrk koondub alati: see ei võngu lõputult, ei hajune ega jää lõpmatutesse arvutussilmustesse kinni. See rahuneb. Bruck tõestas 1990. aastal, et see rahunemine on seotud vastava graafi lõigetega: võrk täidab igal uuendussammul sisuliselt ahnet algoritmi maksimaalse lõike probleemi jaoks.
Ja just seal, kus võrk rahuneb, asub ka intelligents. Salvestatud mustrid vastavad energiafunktsiooni lokaalsetele miinimumidele ehk energiamaastiku orgudele. Kui anda võrgule ette rikutud, mürane või puudulik versioon salvestatud mustrist, veeretab dünaamika võrgu seisundi allamäge, kuni see langeb lähimasse orgu: salvestatud mustrisse, mis sisendiga kõige paremini sobib.
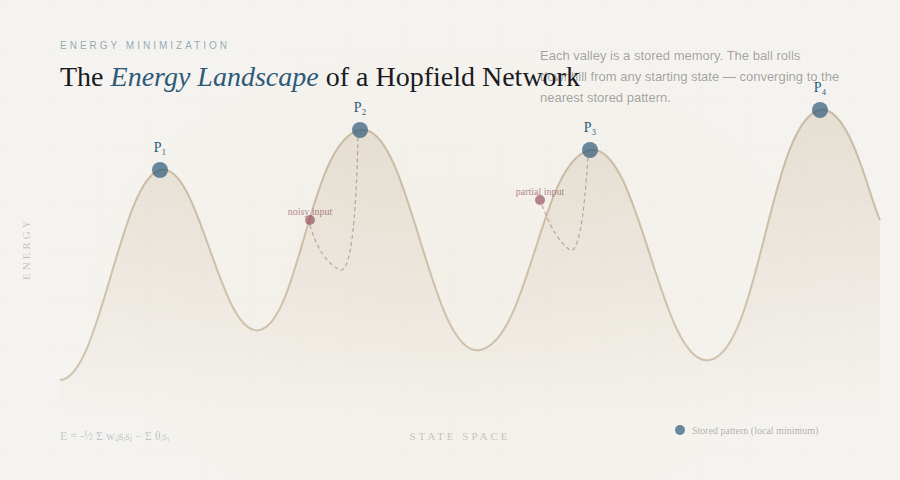
Hopfieldi võrgu energiamaastik. Iga org (lokaalne miinimum) vastab ühele salvestatud mälumustrile. Alustades suvalisest algseisundist veeretab võrgu dünaamika seisundi „allamäge“, kuni see settib lähimasse atraktorisse ning taastab täieliku mustri osalisest või mürasest sisendist.
See on sisu järgi adresseeritav assotsiatiivne mälu võime meenutada tervikmälestusi osaliste vihjete põhjal. Bioloogilised ajud teevad seda vaevata, transformerid aga suudavad seda vaid kalli arvutuse kaudu ligikaudselt järele aimata.
Seos füüsikaga on sügav. Hopfieldi võrk on matemaatiliselt samaväärne Isingi mudeliga, st samasuguse raamistikuga, millega kirjeldatakse magnetismi statistilises mehaanikas. 1975. aastal avaldatud Sherringtoni–Kirkpatricki spinnklaasi mudel on sisuliselt Hopfieldi võrk juhuslike kaaludega. Hopfieldi mõte oli seda omadust teadlikult ära kasutada ja kujundada energiamaastik nii, et iga miinimum vastaks kasulikule salvestatud mustrile.
Hebbi õppimine: koos tulistavad neuronid ühenduvad koos
Õppereegel, mis paneb Hopfieldi võrgud toimima, ulatub juurtega veelgi kaugemale, Donald Hebbi 1949. aasta raamatuni The Organization of Behavior, milles esitati põhimõte, mida täna peetakse neuraalse õppimise teooria alustalaks.
Hebbi mõte oli petlikult lihtne: kui presünaptiline rakk osaleb korduvalt ja järjekindlalt postsünaptilise raku tulistamises, siis nende vaheline sünaptiline ühendus tugevneb. „Koos tulistavad neuronid ühenduvad koos“, kuigi Hebb ise oli täpsem ja rõhutas, et rakk A peab osalema raku B tulistamise põhjustamises, mitte lihtsalt tulistama samal ajal. See ajaline põhjuslikkus andis aimu sellest, mida täna tuntakse kui spaiki ajastusest sõltuvat plastilisust (STDP). Seda kinnitati katseliselt aastakümneid hiljem, sealhulgas Eric Kandeli murrangulistes uuringutes mereteo Aplysia californica.
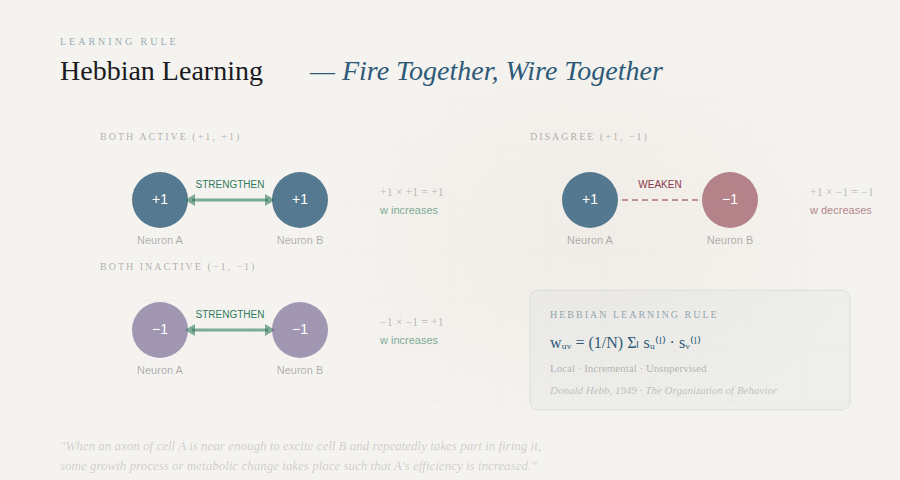
Hebbi õppimine: kui kaks omavahel ühendatud neuronit on korduvalt korraga aktiivsed, nende vaheline sünaps tugevneb. See põhimõte „koos tulistavad neuronid ühenduvad omavahel“ on bioloogiline alus, mille najal Hopfieldi võrgud mustreid talletavad.
Hopfieldi võrgus rakendatakse Hebbi õppimist nii:
wᵤᵥ = (1/N) Σₗ sᵤ(l) · sᵥ(l) kõigi talletatud mustrite l jaoks, kus u ≠ v
Kui kahel neuronil on antud mustris sama olek (mõlemad +1 või mõlemad −1), on nende korrutis positiivne ja erutav ühendus tugevneb. Kui nende olekud on vastandlikud, on korrutis negatiivne ja tekib pärssiv ühendus. Kumulatiivne mõju kujundab energiamaastiku, kus igal talletatud mustril on oma org.
Hebbi reegel on lokaalne (iga kaalu uuendamiseks piisab infost, mis on kättesaadav kahele ühendatud neuronile) ja inkrementaalne (uusi mustreid saab talletada ilma vanu uuesti läbi töötlemata). Tähelepanuväärselt saab matemaatiliselt näidata, et Hebbi õppimine teostab sisendandmete juhendamata peakomponentanalüüsi (PCA): võrk eraldab oma keskkonnast ise kõige statistiliselt olulisemad tunnused.
1997. aastal tutvustas Amos Storkey täiustatud õpireeglit, mis arvestab iga neuroni lokaalset välja ja saavutab suurema mahutavuse kui tavaline Hebbi õppimine. See näitab, et ka sama arhitektuuri piires on õppealgoritmi valikul sügav tähtsus, mis kõlab kokku närvivõrkude uurimise laiema õppetunniga.
Läbimurre: „Hopfield Networks is All You Need“
2020. aastal avaldas Linzi Johannes Kepleri ülikooli meeskond eesotsas Hubert Ramsaueriga artikli, mille pealkiri kajastab provokatiivselt transformeri sünnilugu: „Hopfield Networks is All You Need.“ Nende panus oli matemaatiline tõestus sellele, mida paljud olid aimanud: transformerite enesetähelepanu mehhanism on täpselt kaasaegse pideva Hopfieldi võrgu uuendusreegel.
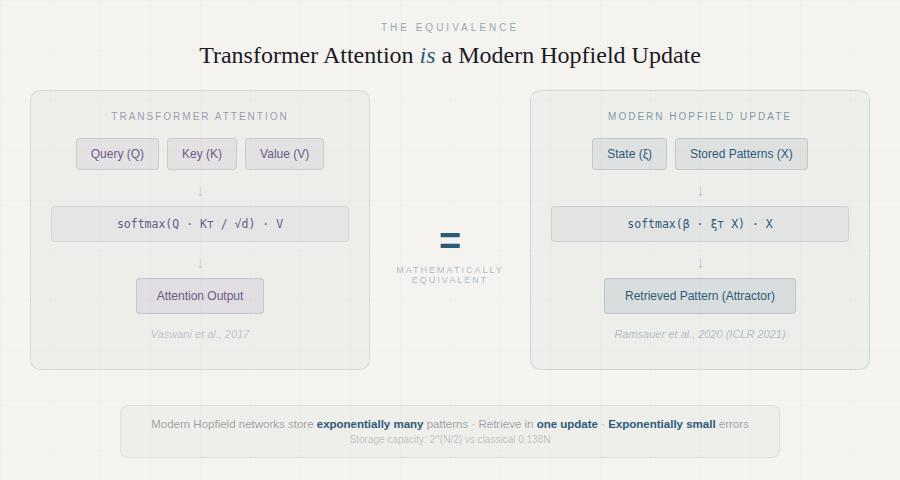
Seos kaasaegsete Hopfieldi võrkude ja transformeri tähelepanu vahel. Transformerite softmaxil põhinev tähelepanumehhanism on matemaatiliselt samaväärne eksponentsiaalse energiafunktsiooniga pideva Hopfieldi võrgu ühe uuendussammuga. Pilt: Ramsauer et al., „Hopfield Networks is All You Need.“
See polnud pelgalt analoogia. Meeskond näitas, et kui üldistada klassikaline Hopfieldi energiafunktsioon pidevatele olekutele ja kasutada eksponentsiaalset vastastikmõju liiget, saab uuendusreegliks:
Z = softmax(β · R Wq Wk⊤ Y⊤) Y Wk Wv
ja see on just transformeri tähelepanuvalem. Kaasaegne Hopfieldi võrk suudab talletada eksponentsiaalselt palju mustreid (assotsiatiivse ruumi dimensiooni suhtes), leiab need üles ühe uuendusega ja selle otsinguvead on eksponentsiaalselt väikesed.
Artikkel tuvastas selles kaasaegses raamistikus kolme tüüpi energiaminimume: (1) globaalne püsipunkt, mis keskmistab kõik talletatud mustrid, (2) metastabiilsed olekud, mis keskmistavad mustrite alamhulki, ja (3) püsipunktid, mis talletavad üksikuid mustreid. Madalamate kihtide transformeripead kalduvad töötama globaalse keskmistamise režiimis, kõrgemate kihtide pead aga kasutavad metastabiilseid olekuid, et teavet koguda ja töödelda. See leid annab sügava ülevaate sellest, miks transformerid just nii töötavad.
Praktiline järeldus oli kohene: meeskond avaldas Hopfieldi kihidkui PyTorchi drop-in moodulid, mis võivad asendada koondamiskihte (pooling), GRU/LSTM-kihte ja tavalisi tähelepanukihte. Võrdlustestides saavutasid need Hopfieldi kihid tipptasemel tulemusi immuunrepertuaari klassifitseerimisel (mitusada tuhat instantsi proovi kohta), mitme instantsiga õppimise (multiple instance learning) ülesannetes ning UCI klassifitseerimise võrdlustestides, kus traditsioonilised süvaõppe meetodid tavaliselt hätta jäävad.
2025. aasta detsembriks läks Masumura ja Taki NeurIPS-i artikkel veel kaugemale ning näitas, et „adiabaatilisest lähendusest“ kaugemale minnes ilmnevad peidetud olekud Hopfieldi ja transformeri vastavuses, mis suudavad lahendada sügavaid transformereid vaevavad astme kollapsi (rank collapse) ja tokenite ühtlustumise probleemid ning parandada täpsust ilma ühtegi lisaõppeparameetrit lisamata.
Kasvav üksmeel: kes veel seda ütleb?
Väide, et Hopfieldi võrgud on transformeritele järgnev uus paradigma, ei ole spekulatsioon. Seda uuritakse aktiivselt suurtes teadusasutustes ja tõendeid koguneb kiiresti. Siin on peamised hääled ja artiklid, mis jõuavad samale järeldusele.
IBM Research ja Dmitry Krotov
2025. aasta jaanuaris avaldas IBM Research põhjaliku intervjuu Dmitry Krotoviga, Hopfieldi pikaaegse kaastöölise ja Dense Associative Memory ühe arhitektiga. Krotov esitas oma seisukoha otse: kuna Hopfieldi võrgud jäljendavad aju rekurrentseid tagasisideahelaid, erinevalt 90% tänapäeva tehisintellekti mudelite päripidisest (feedforward) arhitektuurist, on need „paljutõotav alternatiiv tänastele päripidistele võrkudele“. Ta juhtis tähelepanu, et transformerid töötlevad infot ainult ühes suunas ning konteksti pikenedes kasvab arvutuslik keerukus kiiresti. Aju seevastu kasutab rekurrentseid tagasisideahelaid, et möödunud infot kokku võtta ja mällu salvestada. Hopfieldi võrgud töötavad samamoodi.
Krotov kirjeldas ka Energy Transformerit (NeurIPS 2023), IBM Researchi ja Georgia Techi koostööprojekti, mis ei lisa Hopfieldi ideid olemasolevatele transformeritele lihtsalt kihina, vaid asendab kogu päripidiste transformeriplokkide jada ühe suure assotsiatiivse mälu mudeliga. Energy Transformeri tähelepanumehhanism erineb selgelt tavapärasest: see on tuletatud energia minimeerimise esimestest printsiipidest, mitte päripidisele torujuhtmele külge paigatud.
🔗 IBM Research „Searching for brain-inspired AI algorithms“ (jaan 2025)
🔗 Energy Transformer arXiv:2302.07253 (NeurIPS 2023)
Johannes Kepleri Ülikool – Hochreiteri uurimisrühm
Sepp Hochreiter, LSTM-i kaasleiutaja, juhtis meeskonda, mis avaldas artikli „Hopfield Networks is All You Need“. Nende Hopfield layers’i repositoorium pakub tootmisvalmis PyTorchi mooduleid, mis sobivad drop-in asendajaks transformeri tähelepanukihtidele, koondamiskihtidele ja rekurrentsetele kihtidele. Kaasnev blogipostitus käib samm-sammult läbi matemaatilise tuletuse, mis näitab, et softmax-tähelepanu valem on tänapäevase Hopfieldi uuendusreegli erijuht ning et Hopfieldi kihid pakuvad lisavõimalusi, mida tavaline tähelepanu pakkuda ei suuda, sealhulgas staatilisi õpitud prototüüpe ja paindlikke assotsiatiivse mälu seadistusi.
🔗 Hopfield Networks is All You Need – ICLR 2021
NeurIPS 2025: Hopfield Attention Improves GPT and Vision Transformers
Kõige värskemad tõendid pärinevad Masumura ja Taki 2025. aasta detsembri NeurIPS-i artiklist. Nad näitasid, et Kaasaegne Hopfieldi tähelepanu (Modern Hopfield Attention, MHA), mis lisab täielikust (mitteadiabaatilisest) Hopfieldi dünaamikast tuletatud peidetud olekud, parandab süstemaatiliselt nii GPT-2 ja LLaMA keelemudeleid kui ka Vision Transformereid. Paranemine ei nõudnud ühtegi lisaõpetatavat parameetrit. Veelgi olulisem: selgus, et MHA lahendab astme kollapsi probleemi (sügavates transformerites degenereeruvad tähelepanumaatriksid ja kõik tokenid koonduvad sarnastele representatsioonidele), mis on transformerite skaleerimist pikka aega kimbutanud põhiline patoloogia. Autorid jõudsid järeldusele: "Loodame, et see uurimus avab uusi võimalusi Transformeri arhitektuuride süstemaatiliseks kavandamiseks Hopfieldi võrkude abil."
🔗 On the Role of Hidden States of Modern Hopfield Network in Transformer arXiv:2511.20698 (NeurIPS 2025)
Nature Communications: bioloogiliselt usutav veebiõpe
2024. aasta mais avaldas Nature Communications töö hõreda kvantiseeritud Hopfieldi võrgu (Sparse Quantized Hopfield Network) kohta. See mudel õpib lokaalsete õppereeglitega veebipõhistes pidevõppe stsenaariumides, täpselt nii nagu bioloogilised ajud. See lahendab transformerite põhipiirangu: nad vajavad mittelokaalset tagasilevi ja õpet kureeritud andmekogudel võrguühenduseta. Artikkel pakub Hopfieldi-põhised arhitektuurid välja loomuliku sillana tehisnärvivõrkude ja neuromorfse riistvara vahel.
🔗 A Sparse Quantized Hopfield Network for Online-Continual Memory Nature Communications (2024)
Erandeid arvestavad Hopfieldi kihid suurtele alusmudelitele
2024. aasta artikkel võttis ette praktilise probleemi suurtes transformermudelites: kalduvuse suunata tähelepanu infot mittekandvatele tokenitele (eraldajad, kirjavahemärgid) ehk nn "no-op outlier" probleemi. Lahenduseks oli erandeid arvestav Hopfieldi energiafunktsioon, mis klassifitseerib sellised tokenid ja suunab need nullenergiaga punkti, nii et need ei lahjenda kasulikku tähelepanu. Saadud mudel hõlmab Softmax₁ tähelepanu erijuhuna ning seda valideeriti BERT-i, OPT ja Vision Transformeritega. See on Hopfieldi teooria, mis lahendab päris transformerite inseneriprobleeme.
🔗 Outlier-Efficient Hopfield Layers for Large Transformer-Based Models (2024)
Transformerid kui energia minimeerijad (jaanuar 2026)
Kõige värskem teoreetiline töö, mis ilmus 2026. aasta jaanuaris, kirjeldab kogu transformeri otsest läbivoolu (forward pass) sisemise energia minimeerimisena ning võtab Hopfieldi vaate täielikult omaks seletusraamistikuna, miks transformerid üldse töötavad. Artikkel seob hõredad kaasaegsed Hopfieldi mudelid kogu tähelepanuvariantide perekonnaga (softmax, sparsemax, α-entmax) ning näitab, et need kõik on energiapõhise otsingudünaamika erijuhud.
🔗 Transformers as Intrinsic Optimizers: Forward Inference through the Energy Principle (jaan 2026)
Ülevaateartiklid ja kogukonna ressursid
Laiem uurimiskogukond koondub selle kokkulangevuse ümber:
- "Energy-Based Learning and the Evolution of Hopfield Networks" (TechRxiv, aprill 2025) Põhjalik ülevaade, mis jälgib kogu teekonda Hopfieldist (1982) Boltzmanni masinateni ja transformeri tähelepanu uuestitõlgendamiseni kaasaegse Hopfieldi dünaamikana. → Loe artiklit
- "An Energy-Based Perspective on Attention Mechanisms in Transformers" Põhjalik tehniline blogipostitus, mis väidab, et transformerite mõistmine Hopfieldi energia vaatenurgast "võib viia kvalitatiivselt teistsugusteni parandusteni, kui on võimalik pelgalt skaleerimisele ja arvutuskeerukuse vähendamisele toetudes." → Loe ajaveebi
- Awesome Modern Hopfield Networks Kureeritud GitHubi hoidla, mis jälgib enam kui 50 teadustööd tänapäevaste Hopfieldi võrkude kohta eri valdkondades: varade jaotus, muutuste tuvastamine, loova mõtlemise rekonstrueerimine, jaotusvälise andmestiku tuvastamine, immuunrepertuaari klassifitseerimine ja palju muud. → Sirvi kogu
- "Is Hopfield Networks All You Need?" (Analytics India Magazine, detsember 2024) Praktikutele suunatud ülevaade sellest, kuidas Hochreiteri meeskond näitas, et Hopfieldi võrgud on „asendatavad tipptasemel transformer-mudelitega“. → Loe artiklit
- "New Research in Hopfield Networks: A Short Intro" (Medium, juuli 2024) Hõlpsasti jälgitav ülevaade, mis märgib, et mahutavus on eksponentsiaalsete aktivatsioonifunktsioonide abil kasvanud 0,138N-lt väärtuseni 2^(N/2). → Loe Mediumis
Suund on selge. See ei ole ühe labori ettepanek ega ühe teadustöö spekulatsioon. IBM Research, Johannes Kepleri ülikool, MIT, NeurIPS, Nature Communications ja laiem masinõppe kogukond jõuavad eri suundadest samale järeldusele: Hopfieldi rajatud energiapõhine assotsiatiivse mälu paradigma ei ole mitte ainult vundament, millele transformerid teadmatult ehitati, vaid ka raamistik, mis viib tehisintellekti kaugemale sellest, mida suudavad saavutada üksnes transformerid.
Miks see praegu loeb: põhjused üle minna
Garanteeritud koondumine ohutuskriitilistele süsteemidele
Transformerid annavad tulemusi, kuid stabiilsuse matemaatilist garantiid neil pole. Hopfieldi võrgud koonduvad stabiilsetesse olekutesse tõestatult energiafunktsioon kahaneb monotoonselt. Robootika, isejuhtivate sõidukite, meditsiiniseadmete ja kõigi süsteemide jaoks, kus töökindlus ei ole läbiräägitav, on see nõue, mida transformerid täita ei suuda.
Assotsiatiivne mälu kui põhivõime
Kui treenid Hopfieldi võrku nii, et olek (1, −1, 1, −1, 1) on energiaminimum, ja esitad rikutud sisendi (1, −1, −1, −1, 1), koondub võrk õige salvestatud mustrini. See ei oska ega interpoleeri, vaid veereb energiamaastikul allamäge lähima atraktorini. Robootikas varjatud andurite puhul, müraste andmetega manussüsteemides ja igas rakenduses, kus on vaja mustrit osalise sisendi põhjal täiendada, on see murranguline.
Universaalne optimeerimismootor
Hopfield ja David Tank näitasid 1985. aastal, et Hopfieldi võrgud suudavad lahendada kauplejast ränduri ülesande. Kui kulufunktsiooni saab kirjutada Hopfieldi energia kujul, siis on võrgu tasakaalupunktid just need lahendused. Sestsaadik on arhitektuuri rakendatud tööde planeerimisel, juhtmeta võrkude kanalite jaotamisel, kujutiste taastamisel, analoog-digitaalmuundamisel, mobiilsel marsruutimisel ja kombinatoorsel optimeerimisel. 2024. aasta Nature Communicationsi artiklis tutvustati hõredat kvantiseeritud Hopfieldi võrku (Sparse Quantized Hopfield Network) veebipõhiseks pidevaks mäluõppeks lokaalsete reeglitega, nagu seda teevad bioloogilised ajud, mida transformerid põhimõtteliselt ei suuda.
Riistvara, mis mõtleb ilma tarkvarata
Sümmeetrilise kaalu kitsendus (wᵢⱼ = wⱼᵢ) kaardistub otse analoogelektroonilistele ahelatele, sest takistuslik ühendus on olemuselt sümmeetriline. Hopfieldi võrke saab valmistada ASIC-ide või FPGA-dena, kus järeldamine toimub nanosekundite skaalas. Nature'i 2025. aasta neuromorfse andmetöötluse kogumik kinnitab seda suunda: energiatõhus analoogriistvara, mis rakendab neurodünaamikat võrgu servas ning sisuga adresseeritav mälu, mis ei vaja GPU-d, CPU-d ega tarkvaraveeru.
Neuromorfsed ja analoogtehisintellekti kiibid, mis realiseerivad närvivõrgu dünaamika otse riistvaras. Hopfieldi võrkude sümmeetriline, energiapõhine struktuur sobib loomulikult kokku takistuslike vooluringidega, võimaldades tehisintellekti järeldamist nanosekundi skaalal ilma traditsiooniliste tarkvarapinudeta.
Binaarne ja pidev paindlikkus
Klassikalised Hopfieldi võrgud kasutavad binaarseid neuroneid (+1 või −1); pidevad variandid kasutavad sigmoidset aktivatsiooni ja diferentsiaalvõrrandeid. Uuendamine võib olla asünkroonne (üks neuron korraga, mis garanteerib koondumise) või sünkroonne (kõik korraga, mis võimaldab paralleelsust). Sama arhitektuur sobib nii kilobaitidega RAM-iga mikrokontrolleriks kui ka massiivselt paralleelseks FPGA-ks ning nüüd, tänapäevaste Hopfieldi kihtidega, ka GPU-kiirendusega süvaõppe torujuhtmeteks.
Mahutavus: aus piirang
Klassikaline piirang on selge: N neuroniga võrk suudab usaldusväärselt salvestada umbes 0,138N mustrit, enne kui võltsseisundid hakkavad meenutamist rikkuma. See on tõeline piirang, kuid see on aus piirang. Transformeritel pole selget matemaatilist piiri, millal nad hakkavad hallutsineerima.
Pealegi saavutavad tänapäevased Hopfieldi võrgud (Krotov & Hopfield, 2016; Demircigil jt, 2017) kõrgemat järku vastasmõjuliikmete abil eksponentsiaalse mahutavuse. Uuringud nihutavad neid piire jätkuvalt: hõredad ja struktureeritud Hopfieldi võrgud, pika jada Hopfieldi mälu ning Hopfieldi võrgud varade jaotamiseks on kõik aktiivsed arendusvaldkonnad ning artikleid koguneb kiiresti.
Praktiline rakendamine: personaalarvutitest vooluringideni
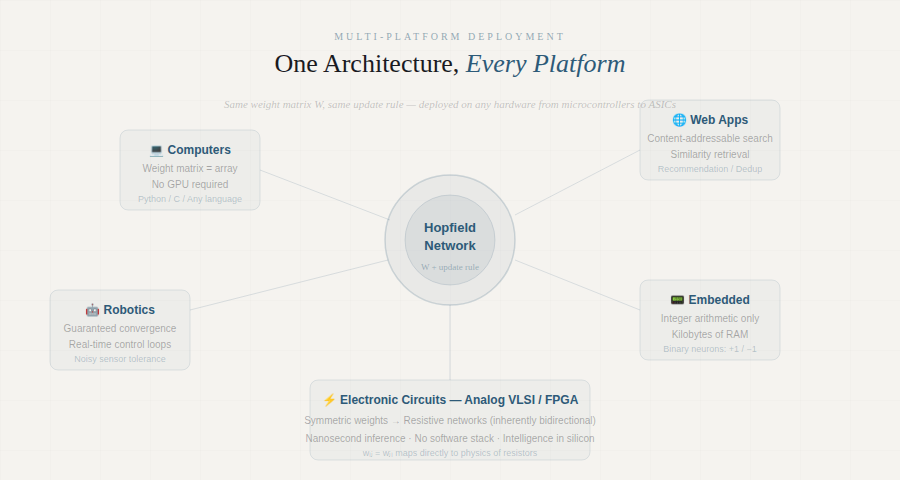
Närvivõrkude varajaste uurijate algne nägemus oli selge: raamistik, mida saab kirjeldada üks kord ja rakendada igal pool. Hopfieldi arhitektuur teeb selle teoks:
Arvutirakendused Kaalumaatriks ja uuendamisreegel. GPU-d pole vaja.
Veebirakendused Sisu järgi adresseeritav mälu sarnasusotsinguks, soovitusteks ja duplikaatide eemaldamiseks.
Robootika Garanteeritud koondumine reaalajas juhtimissilmustes. Liikumismustrid on salvestatud atraktoritena ja neid meenutatakse isegi müraka sensorsisendi põhjal.
Manussüsteemid Binaarsed Hopfieldi võrgud töötavad mikrokontrolleritel ainult täisarvuaritmeetikaga.
Elektroonilised vooluringid Sümmeetrilised kaalud kujutuvad takistusvõrkudeks. Intelligentsus valmistatakse otse ränile.
Tee edasi
Transformeride ajastu andis meile erakordsed keelemasinad. Kuid piir nihkub füüsilisse maailma: robotitesse, sensoritesse, täiturmehhanismidesse ja reaalajas otsustesse. See piir nõuab arhitektuure, mis on stabiilsed, tõhusad, tõlgendatavad ja rakendatavad riistvaral, mis serval tegelikult olemas on.
2020. aasta tõestus, et transformeri tähelepanu on tänapäevane Hopfieldi uuendamisreegel, polnud pelgalt matemaatiline kurioosum – see näitas, et oleme kogu aeg Hopfieldi võrke kasutanud, need vaid olid mähitud raamistikku, mis varjas nende tegelikku olemust. 2025. aasta NeurIPSi töö, mis näitab, et Hopfieldi peidetud olekud lahendavad transformerite patoloogiaid, näiteks astaku kollapsi, vihjab järgmisele sammule: mitte transformerite lappimist Hopfieldi teadmistega, vaid ehitamist otse Hopfieldi paradigmale endale.
John Hopfield näitas meile teed 1982. aastal. Donald Hebb pani bioloogilised alused 1949. aastal. Teadusringkond koondub nüüd selle ümber.
On aeg ümber lülituda.
Viited
- Hopfield, J.J. (1982). "Neural networks and physical systems with emergent collective computational abilities." PNAS, 79(8), 2554–2558.
- Hebb, D.O. (1949). The Organization of BehaviorWiley.
- Ramsauer, H. et al. (2020). "Hopfield Networks is All You Need." ICLR 2021. arXiv:2008.02217
- Krotov, D. & Hopfield, J.J. (2016). "Dense Associative Memory for Pattern Recognition." NeurIPS.
- Storkey, A. (1997). "Increasing the capacity of a Hopfield network without sacrificing functionality." ICANN.
- Hoover, B., Krotov, D. et al. (2023). "Energy Transformer." NeurIPS 2023. arXiv:2302.07253
- Masumura, T. & Taki, M. (2025). "On the Role of Hidden States of Modern Hopfield Network in Transformer." NeurIPS 2025. arXiv:2511.20698
- Alonso, N. & Krichmar, J. (2024). "A sparse quantized Hopfield network for online-continual memory." Nature Communications, 15, 3722. nature.com
- Hu, J.Y. et al. (2024). "Outlier-Efficient Hopfield Layers for Large Transformer-Based Models." arXiv:2404.03828
- Hu, J.Y. et al. (2026). "Transformers as Intrinsic Optimizers: Forward Inference through the Energy Principle." arXiv:2511.00907
- Hopfield, J.J. & Tank, D.W. (1985). "'Neural' Computation of Decisions in Optimization Problems." Biological Cybernetics, 52, 141–152.
- Bruck, J. (1990). "On the convergence properties of the Hopfield model." Proceedings of the IEEE.
- Krotov, D. (2025). "Searching for brain-inspired AI algorithms." IBM Research Blog. research.ibm.com
- "Energy-Based Learning and the Evolution of Hopfield Networks." TechRxiv, aprill 2025. techrxiv.org

