
Hebbian learenjen moetet Hopfield-netwurken: de arsjitektuer dy't altyd tûker wie as transformers
Yn it ôfrûne desennium hawwe transformers en harren attention-meganismen it AI-lânskip behearske. Fan GPT oant BERT oant Vision Transformers: de mantra "attention is all you need" hat feroare hoe't wy tinke oer machine learning. Translator-systemen, encoder-decoder-pipelines dy't gegevens omsette tusken representaasjes, waarden de rêchbonke fan alles, fan taalferwurking oant ôfbyldingsgeneraasje. Se wiene revolúsjonêr. Se wiene machtich.
En no rinne se tsjin in muorre oan.
De irony is dat de oplossing al sûnt 1982 bestiet. Dat jier publisearre John Hopfield in artikel yn de Proceedings of the National Academy of Sciences dêr't er in weromkearend neuraal netwurk yn yntrodusearre mei in eigenskip dat transformers noch nea echt helle hawwe: garandearre konverginsje nei stabile steaten troch enerzjyminimalisaasje. It Hopfield-netwurk learde net allinne patroanen, it bewarre se as fysike attraktors yn in enerzjylânskip, op te heljen sels út lawaaierige of ûnfolsleine ynput.
De AI-mienskip begjint no pas te begripen wat de natuerkunde en de neurowittenskip al tsientallen jierren witte: de enerzjybasearre, assosjative oanpak fan neuraal rekkenjen is gjin histoarysk kuriosum, mar in fûneminteel paradigma dêr't it transformer-tiidrek op foarthollen hat sûnder it folslein te trochgrûnen.
It transformer-plafond
Transformers wurkje troch yn in rige alle eleminten tagelyk mei inoar yn ferbân te bringen fia self-attention. Dat is prachtich foar taal. It is prachtich foar strukturearre gegevens mei dúdlike folchoardlike patroanen. Mar de echte wrâld, de wrâld fan robotika, ynbêde skeakelingen, sensorstjoerde beslútfoarming en edge computing, ornearret himsels net yn moaie rigen dy't wachtsje op oandacht.
De transformer-arsjitektuer giet út fan oerfloed: oerfloedich rekkenkrêft, oerfloedich ûnthâld, oerfloedich enerzjy. Self-attention groeit kwadratysk mei de rigelingte. Feed-forward-lagen groeije lineêr, mar yn massale mjitte. As jo in transformer-basearre systeem ynsette op in mobile robot dy't troch in pakhús navigearret, of ynbouwe yn in elektroanyske skeakeling dy't in produksjearm oanstjoert, falle dy oannames yninoar.
It translator-paradigma hat in eigen beheining: it behannelet yntelliginsje yn it foarste plak as in omsettingsprobleem tusken fêste representaasjes. De ynput kodearje. De útfier dekodearje. Mar echte yntelliginsje oersetten net allinne, it ûnthâldt, it assosjearret en it konvergearret nei stabile ynterpretaasjes, sels as de ynput ferslechte of dûbelsinnich is.
Wy hawwe dizze problemen oerlaapt mei kwantisaasje, destillaasje, snoeien en hûndert oare optimalisaasjetrúkjes. Edge-AI-oersichten fan 2025 befestigje dat deep learning ynsette op ynbêde hardware "beheind bliuwt troch strikte beheiningen yn ûnthâld, rekkenkrêft en enerzjy." Mar optimalisaasje fan in yn it fûnemint misspaste arsjitektuer stelt de ôfrekkening allinne út. Wat wy nedich hawwe is in arsjitektuer dy't ûnthâld, stabiliteit en enerzjyeffisjinsje as earste prinsipes behannelet, net as neigedachte.
It Hopfield-neuraal netwurk komt yn byld
In Hopfield-netwurk is in weromkearend neuraal netwurk besteande út ien inkele laach neuroanen, dêr't elk neuroan ferbûn is mei alle oare neuroanen, útsein himsels. It netwurk foarmet in folslein net-rjochte graaf: elk pear neuroanen dielt in symmetrysk ferbiningsgewicht, wat betsjut dat de sterkte fan neuroan i nei neuroan j gelyk is oan de sterkte fan joanti. Der binne gjin selsferbiningen (wᵢᵢ = 0). Gjin lagenhierargy. Gjin opfolgjende ferwurkingspipeline. It hiele netwurk wurket as ien inkeld, ûnderling ferbûn dynamysk systeem dat him yn de rin fan de tiid ûntwikkelet nei stabile evenwichtstastannen.
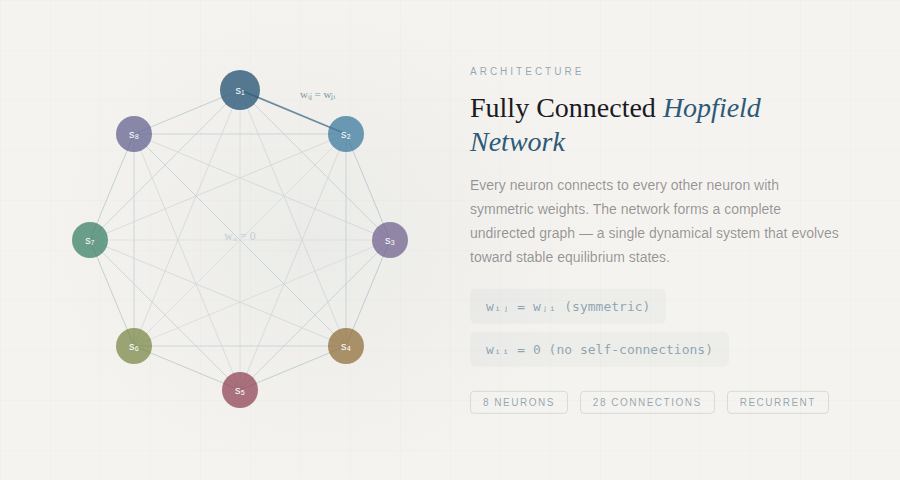
In Hopfield-netwurk mei folslein ferbûne neuroanen. Elke knooppunt is mei elk oar knooppunt ferbûn troch symmetryske gewichten (wᵢⱼ = wⱼᵢ), wat in folsleine net-rjochte graaf foarmet. Selsferbiningen binne der net.
De elegânsje fan dizze arsjitektuer sit yn de enerzjyfunksje. Hopfield bewiisde dat syn netwurk in bypassende Lyapunov-enerzjyfunksje hat:
E = −½ Σᵢ Σⱼ wᵢⱼ sᵢ sⱼ − Σᵢ θᵢ sᵢ
Dizze enerzjy nimt mei elke bywurking fan in neuroan garandearre ôf (of bliuwt gelyk). It netwurk konvergearret altyd: it slingert nea einleas hinne en wer, rint nea út inoar en rekket nea fêst yn einleaze rekkenlussen. It komt ta rêst. Bruck bewiisde yn 1990 dat dit ta-rêst-kommen gearhinget mei besunigingen (cuts) yn de byhearrende graaf: it netwurk docht by elke bywurkstap yn wêzen in gierrich algoritme foar it max-cut-probleem.
En dêr't it netwurk ta rêst komt, dêr sit de yntelliginsje. Opsleine patroanen komme oerien mei lokale minima fan de enerzjyfunksje, de dellingen yn it enerzjylânskip. As jo it netwurk in fersteurde, lawaaierige of ûnfolsleine ferzje fan in opslein patroan oanbiede, rôlet de dynamyk de netwurktastân del oant er yn de tichtstbyste delling falt: it opsleine patroan dat it bêste by de ynfier past.
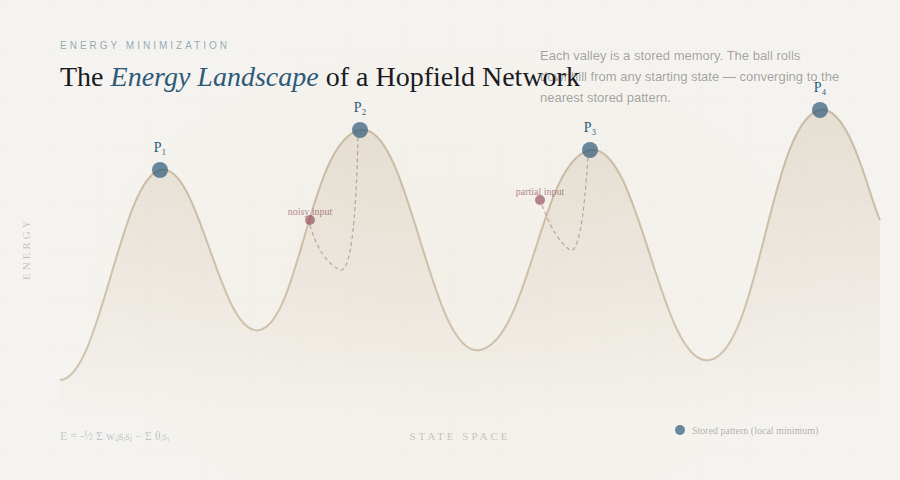
It enerzjylânskip fan in Hopfield-netwurk. Elke delling (lokaal minimum) komt oerien mei in opslein ûnthâldpatroan. Fan elke begjintastân ôf rôlet de netwurkdynamyk "del" oant it yn de tichtstbyste attraktor ta rêst komt, en sa wurdt it folsleine patroan weromhelle út dielsgewiize of lawaaierige ynfier.
Dit is ynhâldsadresseerber assosjatyf ûnthâld it fermogen om folsleine herinneringen op te roppen út dielsgewiize oanwizings, wat biologyske harsens sûnder muoite dogge, mar transformers mar benaderje kinne troch djoere rekkenarbeid.
De ferbining mei de natuerkunde giet djip. It Hopfield-netwurk is wiskundich lykweardich oan in Ising-model, itselde ramt dat yn de statistyske meganika brûkt wurdt om magnetisme te beskriuwen. It Sherrington-Kirkpatrick-model fan spinglês, publisearre yn 1975, is yn wêzen in Hopfield-netwurk mei willekeurige gewichten. Hopfields ynsjoch wie om dizze eigenskip mei opset te benutten en it enerzjylânskip sa te boetsearjen dat elk minimum oerienkomt mei in nuttich opslein patroan.
Hebbiaansk learen: neuroanen dy't tegearre fjoere, ferbine har tegearre
De learregel dy't Hopfield-netwurken wurkje lit, hat woartels dy't noch fierder werom geane, nei Donald Hebb syn boek út 1949, The Organization of Behavior, dat útstelde wat no jilt as it grûnbegjinsel fan de neuronale learteory.
Hebb syn ynsjoch wie skynber ienfâldich: as in presynaptyske sel hieltyd wer en oanhâldend meidocht oan it fjoerjen fan in postsynaptyske sel, wurdt de synaptyske ferbining tusken harren sterker. "Neuroanen dy't tegearre fjoere, ferbine har tegearre", al wie Hebb sels krekter: sel A moat meidwaan oan it feroarsaakjen dat sel B fjoert, net gewoan op itselde momint fjoere. Dizze tydlike kausaliteit wiisde al foarút nei wat no bekend is as spike-timing-dependent plasticity (STDP), tsientallen jierren letter eksperimintele befêstige, ûnder oaren troch it baanbrekkende ûndersyk fan Eric Kandel oan de seeslak Aplysia californica.
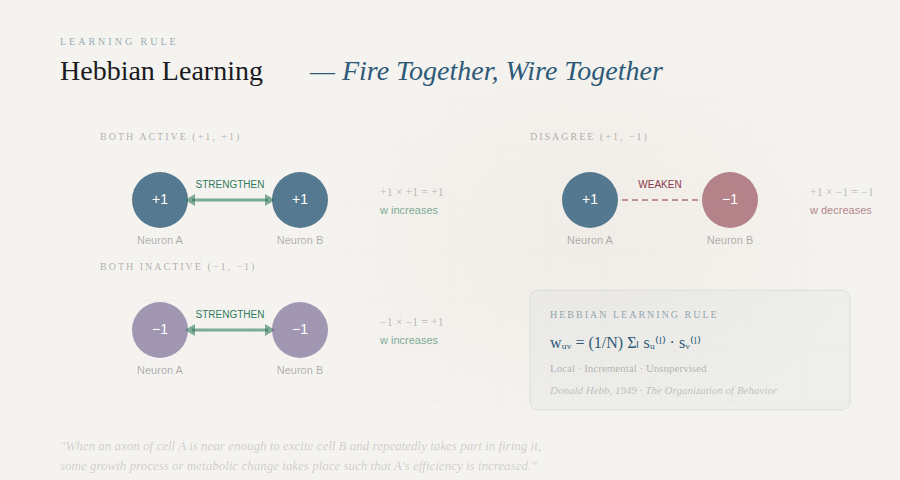
Hebbiaansk learen: as twa ferbûne neuroanen werhelle tagelyk aktyf binne, wurdt de synapse tusken harren sterker. Dit prinsipe, "neuroanen dy't tegearre fjurje, wurde tegearre ferbûn", is de biologyske basis fan hoe't Hopfield-netwurken patroanen opslaan.
Yn it Hopfield-netwurk wurdt Hebbiaansk learen sa útfierd:
wᵤᵥ = (1/N) Σₗ sᵤ(l) · sᵥ(l) foar alle opsleine patroanen l, wêrby't u ≠ v
As twa neuroanen yn in bepaald patroan deselde steat hawwe (beide +1 of beide −1), is harren produkt posityf en wurdt de eksitearjende ferbining sterker. As se it net iens binne, is it produkt negatyf en ûntstiet der in ynhibearjende ferbining. It kumulative effekt foarmet in enerzjylânskip mei in delling by elk opsleine patroan.
De Hebbiaanske regel is lokaal (elke gewichtsoanpassing brûkt allinnich ynformaasje dy't beskikber is foar de twa ferbûne neuroanen) en ynkrementeel (nije patroanen kinne opslein wurde sûnder de âlde opnij te ferwurkjen). Opmerklik is dat Hebbiaansk learen wiskundich oantoand wurde kin om sûnder tafersjoch in haadkomponintanalyze (PCA) fan de ynfiergegevens út te fieren: it netwurk helet fansels de statistysk meast betsjuttingsfolle skaaimerken út syn omjouwing.
Yn 1997 yntrodusearre Amos Storkey in ferbettere learregel dy't rekken hâldt mei it lokale fjild by elke neuroan en dêrmei in gruttere opslachkapasiteit berikt as standert Hebbiaansk learen. Dit lit sjen dat sels binnen deselde arsjitektuer de kar fan it leealgoritme djip fan belang is, in prinsipe dat oanslút by de bredere les út it ûndersyk nei neurale netwurken.
De trochbraak: "Hopfield Networks is All You Need"
Yn 2020 publisearre in team ûnder lieding fan Hubert Ramsauer oan de Johannes Kepler Universiteit Linz in artikel mei in provokatyf neamde echo fan it ûntstean fan de transformer: "Hopfield Networks is All You Need." Harren bydrage wie it wiskundige bewiis fan wat in protte ferdocht hiene: it self-attention-meganisme yn transformers is krekt de bywurkregel fan in moderne trochgeande Hopfield-netwurk.
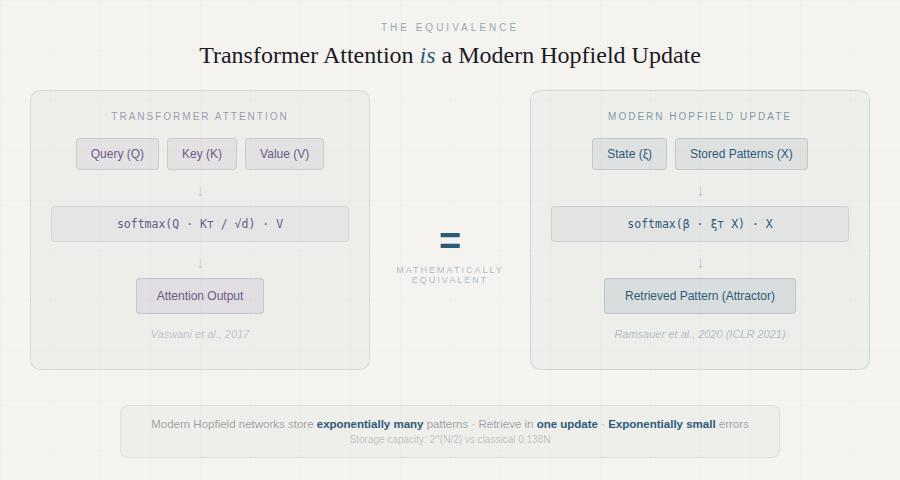
De ferbining tusken moderne Hopfield-netwurken en de attention fan transformers. It softmax-basearre attention-meganisme yn transformers is wiskundich lykweardich oan ien bywurkstap fan in trochgeand Hopfield-netwurk mei in eksponensjele enerzjyfunksje. Ofbylding út Ramsauer et al., "Hopfield Networks is All You Need."
Dit wie net gewoan in analogy. It team liet sjen dat, troch de klassike Hopfield-enerzjyfunksje te generalisearjen nei trochgeande steaten en in eksponensjele ynteraksjeterm te brûken, de bywurkregel wurdt:
Z = softmax(β · R Wq Wk⊤ Y⊤) Y Wk Wv
wat krekt de attention-formule fan de transformer is. It moderne Hopfield-netwurk kin eksponensjeel in protte patroanen opslaan (mei de dimensje fan de assosjatyfromte), helet se op yn ien bywurkstap werom en hat eksponensjeel lytse weromhelfeats.
It artikel identifisearre trije soarten enerzjyminima yn dit moderne ramt: (1) in globaal fêst punt dat it gemiddelde nimt oer alle opsleine patroanen, (2) metastabile steaten dy't it gemiddelde nimme oer dielsets fan patroanen, en (3) fêste punten dy't ien patroan opslaan. Transformer-hollen yn legere lagen wurkje oer it algemien yn it globale gemiddelderegime, wylst hollen yn hegere lagen metastabile steaten brûke om ynformaasje te sammeljen en te ferwurkjen, in fynst dy't djip ynsjoch jout yn wêrom transformers wurkje sa't se dat dogge.
De praktyske gefolgen wiene daliks te fernimmen: it team publisearre Hopfield-lagen as drop-in PyTorch-modules dy't pooling-lagen, GRU/LSTM-lagen en standert attention-lagen ferfange kinne. Yn benchmarks helle dizze Hopfield-lagen state-of-the-art-resultaten op de klassifikaasje fan immune repertoires (mei ferskate hûnderttûzenen eksimplaren per stekproef), by multiple-instance-learning-problemen en by UCI-klassifikaasjebenchmarks, dêr't tradisjonele deep-learning-metoaden meastal muoite mei hawwe.
Yn desimber 2025 gie in NeurIPS-paper fan Masumura en Taki noch in stap fierder: se lieten sjen dat it oerstekken fan de "adiabatyske approximaasje" ferburgen steaten bleatlient yn de oerienkomst tusken Hopfield-netwurken en transformers. Dy kinne de problemen fan rank collapse en token-uniformiteit oplosse dy't djippe transformers pleagje, en dat ferbettet de krektens sûnder ien ekstra trainingsparameter ta te foegjen.
De groeiende konsensus: wa sizze dit noch mear?
Dit argumint, dat Hopfield-netwurken it folgjende paradigma nei de transformers fertsjintwurdigje, is gjin spekulaasje. Grutte ûndersyksynstellingen wurkje der aktyf oan, en it bewiis stapelt him rap op. Hjir binne de wichtichste stimmen en papers dy't ta deselde konklúzje komme.
IBM Research en Dmitry Krotov
Yn jannewaris 2025 publisearre IBM Research in wiidweidich ynterview mei Dmitry Krotov, de lange tiid gearwurkingspartner fan Hopfield en ien fan de arsjitekten fan Dense Associative Memory. Krotov makke it beslist dúdlik: omdat Hopfield-netwurken de weromkearende feedbackloops fan it brein neibuorje, oars as de feedforward-arsjitektuer fan 90% fan de hjoeddeiske AI-modellen, binne se "in kânsrik alternatyf foar de feedforward-netwurken fan hjoed." Hy wiisde derop dat transformers ynformaasje mar yn ien rjochting ferwurkje, en dat de komputaasjonele kompleksiteit rap tanimt as de kontekstfinsters langer wurde. It brein brûkt dêrfoar yn it ferlykjen weromkearende feedbackloops om eardere ynformaasje gear te nimmen en yn it ûnthâld op te slaan. Hopfield-netwurken wurkje op deselde wize.
Krotov beskreau ek de Energy Transformer (NeurIPS 2023), in gearwurking tusken IBM Research en Georgia Tech. Dy leit Hopfield-ynsjoggen net gewoan oer besteande transformers hinne, mar ferfangt de hiele rige feedforward-transformerblokken troch ien grut Associative Memory-model. It attention-meganisme yn de Energy Transformer is dúdlik oars as konvinsjonele attention: it is ôfliede fan de earste prinsipes fan enerzjyminimalisaasje en net op in feedforward-pipeline plakt.
🔗 IBM Research "Searching for brain-inspired AI algorithms" (jan 2025)
🔗 Energy Transformer arXiv:2302.07253 (NeurIPS 2023)
Johannes Kepler Universität - Hochreiters groep
Sepp Hochreiter, mei-útfiner fan de LSTM, late it team dat "Hopfield Networks is All You Need" publisearre. Harren Hopfield layers repository biedt produksjeklear PyTorch-modules dy't brûkt wurde kinne as drop-in ferfangers foar transformer-attentionlagen, pooling-lagen en weromkearende lagen. De begelieddende blogpost rint de wiskundige ôflieding troch dy't sjen lit dat de softmax-attentionformule in spesjaal gefal is fan de moderne Hopfield-updateregel, en dat Hopfield-lagen ekstra funksjonaliteiten biede dy't standert attention net leverje kin, ynklusyf statyske lear-prototypes en fleksibele konfiguraasjes foar associative memory.
🔗 Hopfield Networks is All You Need - ICLR 2021
NeurIPS 2025: Hopfield Attention Improves GPT and Vision Transformers
It meast resinte bewiis komt út it NeurIPS-paper fan Masumura en Taki fan desimber 2025. Se lieten sjen dat Modern Hopfield Attention (MHA) dat ferburgen steaten tafoeget dy't ôflaat binne fan 'e folsleine (net-adiabatyske) Hopfield-dynamyk, ferbetteret systematysk sawol GPT-2- en LLaMA-taalmodellen as Vision Transformers. De ferbetterings kamen sûnder ekstra trainingsparameters. Wichtiger noch: MHA bliek it rangkollaps probleem op te lossen (dêr't attention-matriksen yn djippe transformers degenerearje, wêrtroch alle tokens nei ferlykbere represintaasjes konvergearje), in fûneminteel gebrek dat de opskaling fan transformers al lang plaget. De auteurs konkludearren: "Wy hoopje dat dit ûndersyk nije mooglikheden iepenet foar it systematysk ûntwerpen fan Transformer-arsjitektueren mei help fan Hopfield-netwurken."
🔗 On the Role of Hidden States of Modern Hopfield Network in Transformer arXiv:2511.20698 (NeurIPS 2025)
Nature Communications: biologysk plausibel online learen
Yn maaie 2024 publisearre Nature Communications wurk oer it Sparse Quantized Hopfield Network in model dat leart mei lokale learregels yn online-trochgeande (continual) senario's, krekt sa't biologyske harsens dat dogge. Dit giet yn tsjin in fûneminteel beheinde fan transformers, dy't net-lokale efterpropagaasje (backpropagation) en offline training op kurearre datasets nedich hawwe. It papier set Hopfield-basearre arsjitektueren del as de natuerlike brêge tusken keunstmjittige neurale netwurken en neuromorfyske hardware.
🔗 A Sparse Quantized Hopfield Network for Online-Continual Memory Nature Communications (2024)
Outlier-Efficient Hopfield Layers for Large Foundation Models
In papier út 2024 pakte in praktysk probleem oan yn grutte transformermodellen: de oanstriid om attention ta te kennen oan ynformaasjeleaze tokens (skiedingstekens, ynterpunksjetekens), it "no-op outlier"-probleem. Harren oplossing wie in outlier-efficient Hopfield-enerzjyfunksje dy't dizze tokens klassifisearret en nei in nulenerzjypunt liedt, sadat se nuttige attention net fertinne. It resultearjende model omfiemet Softmax₁-attention as spesjaal gefal en waard falidearre op BERT, OPT en Vision Transformers. Dit is Hopfield-teory dy't echte technyske problemen fan transformers oplost.
🔗 Outlier-Efficient Hopfield Layers for Large Transformer-Based Models (2024)
Transformers as enerzjyminimalisearders (jannewaris 2026)
It meast resinte teoretyske wurk, publisearre yn jannewaris 2026, beskôget de hiele forward pass fan in transformer as yntrinsike enerzjyminimalisaasje en nimt dêrmei it Hopfield-perspektyf folslein oan as ferklearjend ramt foar wêrom't transformers oerhaupt wurkje. It papier keppelet sparse moderne Hopfield-modellen oan de hiele famylje fan attention-farianten (softmax, sparsemax, α-entmax) en lit sjen dat dat allegear spesjale gefallen binne fan enerzjybasearre retrieval-dynamyk.
🔗 Transformers as Intrinsic Optimizers: Forward Inference through the Energy Principle (jan 2026)
Oersichtspapieren en mienskipsboarnen
De bredere ûndersyksmienskip organisearret him om dizze konverginsje hinne:
- "Energy-Based Learning and the Evolution of Hopfield Networks" (TechRxiv, april 2025) In wiidweidich oersichtsstik dat de hiele line folget fan Hopfield (1982) fia Boltzmann-masines oant de werynterpretaasje fan transformer-attention as moderne Hopfield-dynamyk. → Lês it papier
- "An Energy-Based Perspective on Attention Mechanisms in Transformers" In djipgeand technysk blog dat beweart dat it begripen fan transformers troch de Hopfield-enerzjylens "miskien liedt ta kwalitatyf oare ferbetterings dan mooglik is allinnich troch te fertrouwen op opskaling en it ferminderjen fan rekkenkompleksiteit." → Lês it blog
- Awesome Modern Hopfield Networks In kurearre GitHub-repository dy't mear as 50 papers oer moderne Hopfield-netwurken folget, oer ferskate domeinen: aktiva-allokaasje, feroaringsdeteksje, werkonstruksje fan kreatyf tinken, deteksje fan out-of-distribution-gegevens, klassifikaasje fan immúnrepertoires en mear. → Trochblêdzje de kolleksje
- "Is Hopfield Networks All You Need?" (Analytics India Magazine, des 2024) Praktykgerichte ferslachjouwing oer hoe't it team fan Hochreiter oantoand hat dat Hopfield-netwurken "útwikselber binne mei state-of-the-art transformer-modellen." → Lês it artikel
- "New Research in Hopfield Networks: A Short Intro" (Medium, july 2024) Tagonklik oersjoch dat neamt hoe't de opslachkapasiteit troch eksponinsjele aktivaasjefunksjes groeid is fan 0.138N nei 2^(N/2). → Lês op Medium
It paad is dúdlik. Dit is gjin foarstel fan ien laboratoarium of de spekulaasje fan ien papier. IBM Research, de Johannes Kepler Universiteit, MIT, NeurIPS, Nature Communications en de bredere mienskip fan masinelearen komme út ferskillende rjochtingen by deselde konklúzje út: it enerzjybasearre, assosjatyfgeheugen-paradigma dat Hopfield fêstlein hat, is net allinnich it fûnemint dêr't transformers sûnder it te witten op boud binne, it is it ramt dat AI fierder bringe sil as transformers allinnich ooit kinne.
Wêrom dit no wichtich is: de reden om oer te stappen
Garandearre konverginsje foar feiligenskrityske systemen
Transformers jouwe útkomsten, mar der is gjin wiskundige garânsje foar stabiliteit. Hopfield-netwurken konvergearje bewiisber nei stabile tastannen de enerzjyfunksje nimt monotoon ôf. Foar robotika, autonome auto's, medyske apparaten en elk systeem dêr't betrouberens net ûnderhandelber is, is dit in eask dêr't transformers net oan foldwaan kinne.
Assosjatyf geheugen as kearnfermogen
As jo in Hopfield-netwurk sa trainje dat tastân (1, −1, 1, −1, 1) in enerzjyminimum is, en jo it beskeadige ynput (1, −1, −1, −1, 1) oanbiede, konvergearret it netwurk nei it juste opslein patroan. It rekket net, en it ynterpolearret net it rôlet nei ûnderen yn it enerzjylânskip nei de tichtstbyste attraktor. Foar robotika mei bedutsen sensoren, ynbêde systemen mei lawaaierige gegevens en elke tapassing dy't patroanfoltôging út dielgegevens freget, is dit transformatyf.
In universele optimalisaasjemotor
Hopfield en David Tank lieten yn 1985 sjen dat Hopfield-netwurken it rinnende-keapman-probleem (traveling salesman problem) oplosse kinne. As in kostenfunksje skreaun wurde kin yn de foarm fan de Hopfield-enerzjy, dan binne de lykwichtspunten fan it netwurk de oplossingen. Sûnt dy tiid is de arsjitektuer tapast op job-shop-planning, kanaaltawizing yn draadloze netwurken, ôfbyldingsherstel, analoog-nei-digitale omsetting, mobile routering en kombinatoaryske optimalisaasje. In Nature Communications-papier út 2024 yntrodusearre in Sparse Quantized Hopfield Network foar online-trochgeand ûnthâldlearen mei lokale regels, krekt sa't biologyske harsens dat dogge, in fermogen dat transformers yn prinsipe misse.
Hardware dy't tinkt sûnder software
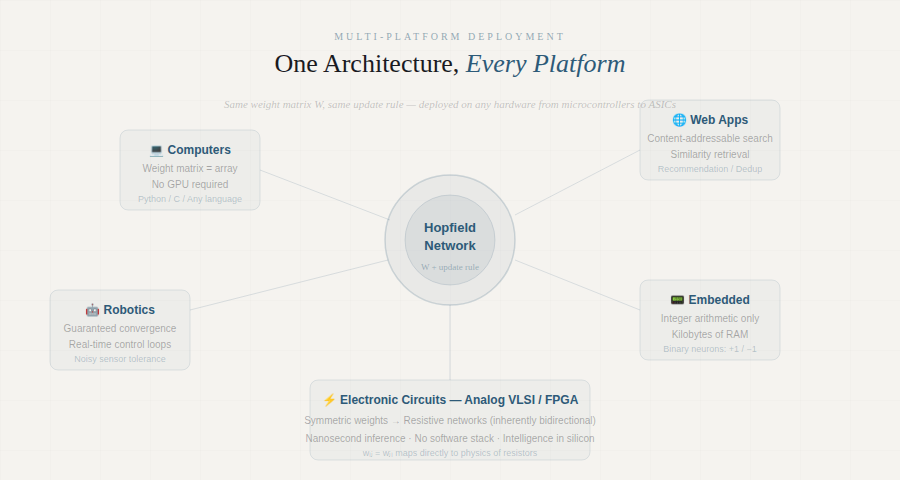
De symmetryske gewichtsbeheining (wᵢⱼ = wⱼᵢ) lit him direkt ôfbyldzje op analoge elektroanyske circuits in resistive ferbining is fan nature symmetrysk. Hopfield-netwurken kinne makke wurde as ASIC's of FPGA's mei ynferinsje op nanosekonde-tiidskalen. Nature's kolleksje fan 2025 oer neuromorfysk rekkenjen befêstiget dizze rjochting: enerzjysunige analoge hardware dy't neurale dynamyk útfiert oan de râne, mei ynhâldsadresseerber geheugen dat gjin GPU, gjin CPU en gjin softwarestack nedich hat.
Neuromorfe en analoge AI-chips dy't de dynamyk fan neurale netwurken rjochtstreeks yn hardware útfiere. De symmetryske, enerzjybasearre struktuer fan Hopfield-netwurken past fansels op resistive skeakelingen, wêrtroch AI-ynferinsje op nanosekondeskaal mooglik wurdt sûnder tradisjonele softwarestacks.
Binêre en trochgeande fleksibiliteit
Klassike Hopfield-netwurken brûke binêre neuroanen (+1 of −1); trochgeande farianten brûke sigmoïde aktivaasje en differinsjaalfergelikingen. Updates kinne asynchroan (ien neuron tagelyk, wat konverginsje garandearret) of synchroan (alles tagelyk, wat parallellisme mooglik makket) wêze. Deselde arsjitektuer past him oan fan in mikrocontroller mei kilobytes RAM oant in massaal parallelle FPGA en no, mei moderne Hopfield-lagen, ek oan GPU-fersneldere deep-learning-pipelines.
Opslachkapasiteit: de earlike beheining
De klassike beheining is dúdlik: in netwurk fan N neuroanen bewarret betrouber likernôch 0.138N patroanen, foardat falske steaten it opheljen oantaaste. Dat is in echte beheining, mar in earlike. Transformers hawwe gjin skjinne wiskundige grins foar wannear't se begjinne te hallusinearjen.
Boppedat berikke moderne Hopfield-netwurken (Krotov & Hopfield, 2016; Demircigil et al., 2017) eksponinsjele opslachkapasiteit troch ynteraksjetermen fan hegere oarder. It ûndersyk wreidet dizze grinzen hieltyd fierder út: sparse en strukturearre Hopfield-netwurken, Hopfield-ûnthâld foar lange sekwinsjes en Hopfield-netwurken foar aktiva-allokaasje binne allegear aktive ûntwikkelingsgebieten, mei in rap groeiend oantal publikaasjes.
Praktyske ynset: fan pc's oant skeakelingen
It oarspronklike idee fan betide ûndersikers fan neurale netwurken wie dúdlik: in ramt dat men ien kear beskriuwe en dan oeral ynsette kin. De arsjitektuer fan Hopfield makket dat wier:
Kompjûterapplikaasjes In gewichtsmatriks en in updateregel. Gjin GPU nedich.
Ynternetapplikaasjes Ynhâldsadressearber ûnthâld foar oerienkomstsykjen, oanbefellings en deduplikaasje.
Robotika Garandearre konverginsje foar real-time stjoerlussen. Motorpatroanen bewarre as attraktors, ek werom te heljen út lawaaierige sensorynput.
Ynbêde systemen Binêre Hopfield-netwurken rinne op mikrocontrollers allinnich mei heule-getallenrekenkunde.
Elektroanyske skeakelingen Symmetryske gewichten fertale nei resistive netwurken. Yntelliginsje direkt yn silisium makke.
It paad foarút
It transformer-tiidrek hat ús útsûnderlike taalmasjines brocht. Mar de grins ferskoot nei de fysike wrâld: robots, sensoren, aktuators en beslissingen yn real-time. Dy grins freget arsjitektueren dy't stabyl, effisjint, ynterpretearber en ynsetber binne op hardware dy't echt oan de râne (edge) bestiet.
It bewiis fan 2020 dat transformer-attinsje is in moderne Hopfield-updateregel, wie net mar in wiskundige kuriositeit: it die bliken dat wy de hiele tiid Hopfield-netwurken brûkt hawwe, ynpakt yn in ramt dat har wiere aard ferburgen hold. It NeurIPS-wurk fan 2025, dat toant dat ferburgen Hopfield-steaten transformer-patologyen as rangkollaps oplosse, wiist op de folgjende stap: gjin transformers lape mei Hopfield-ynsichten, mar direkt bouwe op it Hopfield-paradigma sels.
John Hopfield wiisde ús de wei yn 1982. Donald Hebb lei de biologyske fûneminten yn 1949. De ûndersyksmienskip konvergearret der no op.
It is tiid om oer te stappen.
Referinsjes
- Hopfield, J.J. (1982). "Neural networks and physical systems with emergent collective computational abilities." PNAS, 79(8), 2554–2558.
- Hebb, D.O. (1949). The Organization of Behavior. Wiley.
- Ramsauer, H. et al. (2020). "Hopfield Networks is All You Need." ICLR 2021. arXiv:2008.02217
- Krotov, D. & Hopfield, J.J. (2016). "Dense Associative Memory for Pattern Recognition." NeurIPS.
- Storkey, A. (1997). "Increasing the capacity of a Hopfield network without sacrificing functionality." ICANN.
- Hoover, B., Krotov, D. et al. (2023). "Energy Transformer." NeurIPS 2023. arXiv:2302.07253
- Masumura, T. & Taki, M. (2025). "On the Role of Hidden States of Modern Hopfield Network in Transformer." NeurIPS 2025. arXiv:2511.20698
- Alonso, N. & Krichmar, J. (2024). "A sparse quantized Hopfield network for online-continual memory." Nature Communications, 15, 3722. nature.com
- Hu, J.Y. et al. (2024). "Outlier-Efficient Hopfield Layers for Large Transformer-Based Models." arXiv:2404.03828
- Hu, J.Y. et al. (2026). "Transformers as Intrinsic Optimizers: Forward Inference through the Energy Principle." arXiv:2511.00907
- Hopfield, J.J. & Tank, D.W. (1985). "'Neural' Computation of Decisions in Optimization Problems." Biological Cybernetics, 52, 141–152.
- Bruck, J. (1990). "On the convergence properties of the Hopfield model." Proceedings of the IEEE.
- Krotov, D. (2025). "Searching for brain-inspired AI algorithms." IBM Research Blog. research.ibm.com
- "Energy-Based Learning and the Evolution of Hopfield Networks." TechRxiv, April 2025. techrxiv.org

