
Hebb-tanulás találkozik a Hopfield-hálókkal: az architektúra, amely mindig is okosabb volt a transzformereknél
Az elmúlt évtizedben a transzformerek és figyelemmechanizmusaik uralták az MI világát. A GPT-től a BERT-ön át a Vision Transformerekig az „attention is all you need” jelmondat újraformálta, hogyan gondolkodunk a gépi tanulásról. A fordítórendszerek, vagyis az adatot egyik reprezentációból a másikba alakító kódoló–dekódoló láncok minden gerincévé váltak, a nyelvfeldolgozástól a képgenerálásig. Forradalmiak voltak. Erősek voltak.
És most falba ütköznek.
Az irónia az, hogy a megoldás már 1982 óta létezik. Abban az évben John Hopfield publikált egy tanulmányt a Proceedings of the National Academy of Sciences hasábjain, amely olyan rekurrens neurális hálót mutatott be, amelynek van egy tulajdonsága, amelyet a transzformerek soha nem értek el igazán: az energiaminimalizáláson keresztül garantáltan stabil állapotokba konvergál. A Hopfield-háló nemcsak megtanulta a mintákat, hanem egy energiatájkép fizikai vonzópontjaiként tárolta őket, és zajos vagy hiányos bemenetből is vissza lehetett hívni őket.
Az MI-közösség csak most kezdi felfogni azt, amit a fizikusok és az idegtudósok évtizedek óta tudnak: az idegi számítás energiaalapú, asszociatív megközelítése nem történeti kuriózum, hanem alapvető paradigma, amelyre a transzformerkorszak csupán ráépített, anélkül hogy teljesen megértette volna.
A transzformerek plafonja
A transzformerek úgy működnek, hogy az önfigyelem (self-attention) révén egyszerre számítják ki a sorozat minden eleme közötti kapcsolatokat. Ez nyelvre zseniális. Zseniális a világos sorrendi mintázatú, strukturált adatokra is. A valós világ azonban, vagyis a robotika, a beágyazott áramkörök, az érzékelők által vezérelt döntéshozatal és az edge computing világa, nem rendeződik szép sorozatokba, amelyek arra várnának, hogy figyeljenek rájuk.
A transzformer-architektúra bőségből indul ki: bőséges számítási kapacitásból, bőséges memóriából, bőséges energiából. Az önfigyelem a sorozat hosszával négyzetesen skálázódik. A feed-forward rétegek lineárisan nőnek, de óriási mértékben. Amikor egy transzformer-alapú rendszert egy raktárban közlekedő mobil robotra telepítünk, vagy egy gyártósori kart vezérlő elektronikus áramkörbe építünk be, ezek a feltevések összeomlanak.
A fordító-paradigmának megvan a maga korlátja is: az intelligenciát elsősorban rögzített reprezentációk közötti átalakítási feladatnak tekinti. Kódold a bemenetet. Dekódold a kimenetet. Az igazi intelligencia azonban nem csupán fordít: emlékszik, asszociál, és konvergál stabil értelmezések felé akkor is, ha a bemenet romlott vagy kétértelmű.
Eddig kvantálással, desztillálással, metszéssel és még száz másik optimalizálási trükkel foltozgattuk ezeket a problémákat. A 2025-ös edge AI-áttekintések megerősítik, hogy a mélytanulás beágyazott hardveren való alkalmazását továbbra is „a memória, a számítási kapacitás és az energia szigorú korlátai szorítják”. Egy alapjaiban nem odaillő architektúra optimalizálása azonban csak halogatja a leszámolást. Olyan architektúrára van szükségünk, amely a memóriát, a stabilitást és az energiahatékonyságot alapelvként kezeli, nem utólagos javításként.
Színre lép a Hopfield-féle neurális háló
A Hopfield-háló egyetlen neuronrétegből álló rekurrens neurális háló, amelyben minden neuron az összes többivel össze van kötve, önmagát kivéve. A háló egy teljes irányítatlan gráfot alkot: minden neuronpár szimmetrikus kapcsolati súlyon osztozik, vagyis a i neurontól a j neuronig mért erősség megegyezik a j → i. Önkapcsolatok nincsenek (wᵢᵢ = 0). Nincs rétegzett hierarchia, és nincs szekvenciális feldolgozási csővezeték sem. Ehelyett az egész hálózat egyetlen, összefüggő dinamikai rendszerként működik, amely idővel stabil egyensúlyi állapotok felé fejlődik.
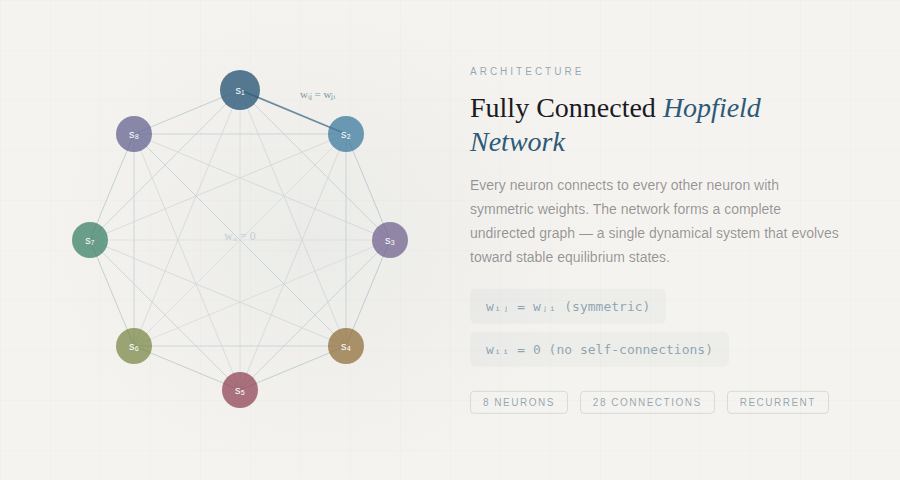
Egy teljesen összekötött neuronokból álló Hopfield-hálózat. Minden csomópont minden másikhoz kapcsolódik szimmetrikus súlyokkal (wᵢⱼ = wⱼᵢ), így teljes irányítatlan gráfot alkotnak. Önkapcsolatok nincsenek.
Ennek az architektúrának az eleganciája az energiafüggvényében rejlik. Hopfield bebizonyította, hogy a hálózatához tartozik egy Ljapunov-féle energiafüggvény:
E = −½ Σᵢ Σⱼ wᵢⱼ sᵢ sⱼ − Σᵢ θᵢ sᵢ
Ez az energia garantáltan csökken (vagy állandó marad) minden egyes neuronfrissítéssel. A hálózat mindig konvergál: soha nem oszcillál a végtelenségig, nem divergál, és nem akad el végtelen számítási hurkokban. Megnyugszik. Bruck 1990-ben kimutatta, hogy ez a megnyugvási viselkedés a hozzá tartozó gráf vágásaival függ össze: a hálózat minden frissítési lépésnél lényegében egy mohó algoritmust hajt végre a maximális vágás problémájára.
És ahol a hálózat megnyugszik, ott lakik az intelligencia. A tárolt minták az energiafüggvény lokális minimumainak felelnek meg, vagyis az energiatáj völgyeinek. Ha a hálózatnak egy tárolt minta sérült, zajos vagy hiányos változatát mutatjuk be, a dinamika lefelé gördíti a hálózat állapotát, míg az bele nem esik a legközelebbi völgybe: abba a tárolt mintába, amely a legjobban illeszkedik a bemenethez.
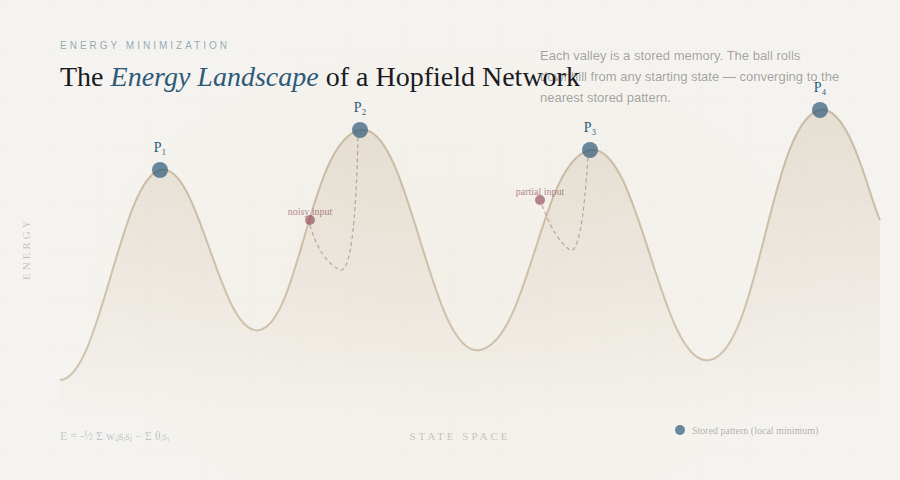
Egy Hopfield-hálózat energiatája. Minden völgy (lokális minimum) egy tárolt emlékmintának felel meg. Bármely kezdőállapotból indulva a hálózat dinamikája „lefelé gördül”, amíg a legközelebbi attraktorba nem jut, így a részleges vagy zajos bemenetből visszaállítja a teljes mintát.
Ez a tartalom szerint címezhető asszociatív memória – az a képesség, hogy részleges jelekből teljes emlékeket idézzünk fel. A biológiai agy ezt erőfeszítés nélkül teszi, a transzformerek viszont csak költséges számítással tudják megközelíteni.
A fizikával való kapcsolat mélyen gyökerezik. A Hopfield-hálózat matematikailag egyenértékű az Ising-modellel, ugyanazzal a keretrendszerrel, amellyel a statisztikus mechanika a mágnesességet írja le. Az 1975-ben publikált Sherrington–Kirkpatrick-féle spinüveg-modell lényegében egy véletlen súlyokkal dolgozó Hopfield-hálózat. Hopfield meglátása az volt, hogy ezt a tulajdonságot tudatosan kihasználja: úgy alakította ki az energiatájat, hogy minden minimum egy hasznos, tárolt mintának feleljen meg.
Hebbi tanulás: ami együtt tüzel, az összekapcsolódik
A tanulási szabály, amely a Hopfield-hálózatokat működőképessé teszi, még régebbre nyúlik vissza: Donald Hebb 1949-es könyvéhez, a The Organization of Behavior címűhöz, amely megfogalmazta azt, amit ma az idegi tanuláselmélet megalapozó elvének tekintünk.
Hebb felismerése megtévesztően egyszerű volt: ha egy preszinaptikus sejt ismétlődően és tartósan részt vesz egy posztszinaptikus sejt tüzelésében, a köztük lévő szinaptikus kapcsolat megerősödik. „Amik együtt tüzelnek, azok összekapcsolódnak” – bár maga Hebb ennél pontosabb volt, és hangsúlyozta, hogy az A sejtnek részt kell vennie a B sejt tüzelésének kiváltásában, nem pusztán egy időben kell tüzelnie vele. Ez az időbeli ok-okozati viszony előrevetítette azt, amit ma tüskeidőzítés-függő plaszticitásnak (STDP) nevezünk. Ezt évtizedekkel később kísérletek is igazolták, többek között Eric Kandel úttörő kutatása is a tengeri csigával, azaz az Aplysia californica.
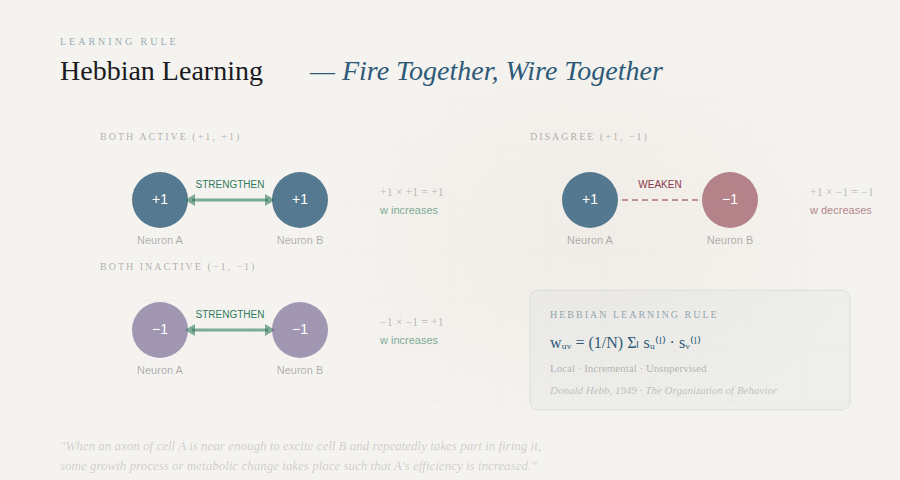
A Hebb-féle tanulás: amikor két összekapcsolt neuron ismétlődően együtt aktív, a köztük lévő szinapszis megerősödik. Ez az elv, a „együtt tüzelő neuronok összekapcsolódnak” ("neurons that fire together wire together"), a Hopfield-hálózatok mintatárolásának biológiai alapja.
A Hopfield-hálózatban a Hebb-féle tanulás így valósul meg:
wᵤᵥ = (1/N) Σₗ sᵤ(l) · sᵥ(l) minden eltárolt l mintára, ahol u ≠ v
Ha két neuron állapota egy adott mintában megegyezik (mindkettő +1 vagy mindkettő −1), a szorzatuk pozitív, és erősíti a serkentő kapcsolatot. Ha eltér az állapotuk, a szorzat negatív, és gátló kapcsolat jön létre. A halmozott hatás egy energiatájat formál, amelyben minden eltárolt mintánál egy-egy völgy mélyül.
A Hebb-szabály lokális (minden súlyfrissítés kizárólag a két összekapcsolt neuron számára elérhető információt használja), és inkrementális (új minták tárolhatók a régiek újrafeldolgozása nélkül). Figyelemre méltó, hogy a Hebb-féle tanulásról matematikailag bizonyítható: felügyelet nélküli főkomponens-analízist (PCA) végez a bemeneti adatokon, vagyis a hálózat magától kinyeri a környezetéből a statisztikailag legjelentősebb jellemzőket.
1997-ben Amos Storkey egy továbbfejlesztett tanulási szabályt mutatott be, amely figyelembe veszi az egyes neuronok lokális terét, és nagyobb tárolókapacitást ér el a hagyományos Hebb-féle tanulásnál. Ez azt mutatja, hogy még azonos architektúrán belül is nagyon sokat számít a tanulási algoritmus megválasztása, ami jól illeszkedik a neurális hálózatok kutatásának tágabb tanulságához.
Az áttörés: „Hopfield Networks is All You Need”
2020-ban a linzi Johannes Kepler Egyetemen Hubert Ramsauer vezetésével egy kutatócsoport olyan tanulmányt tett közzé, amelynek címe szándékosan provokatív visszhangja a transzformer megszületését hozó írásnak: „Hopfield Networks is All You Need”. Hozzájárulásuk annak matematikai bizonyítása volt, amit sokan sejtettek: a transzformerek önfigyelem-mechanizmusa pontosan egy modern, folytonos Hopfield-hálózat frissítési szabálya.
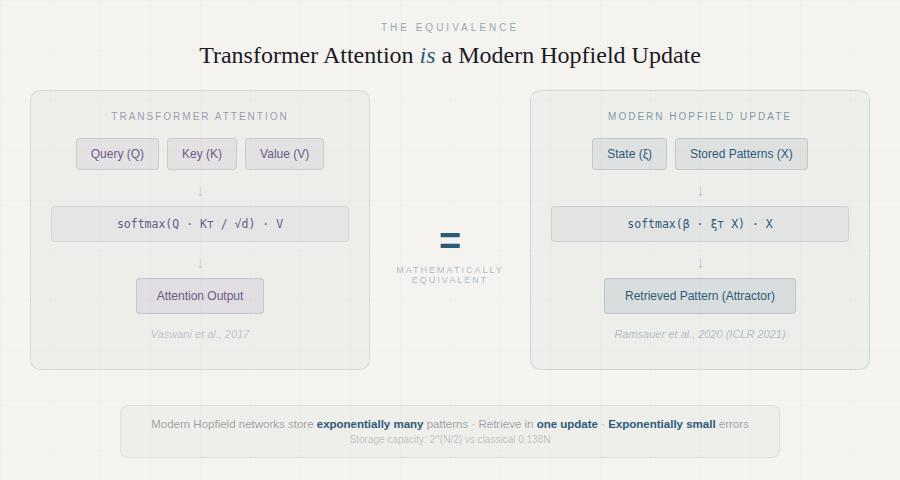
A modern Hopfield-hálózatok és a transzformer figyelemmechanizmusának kapcsolata. A transzformerek softmax-alapú figyelemmechanizmusa matematikailag egyenértékű egy exponenciális energiafüggvényű, folytonos Hopfield-hálózat egyetlen frissítési lépésével. A kép forrása: Ramsauer et al., „Hopfield Networks is All You Need”.
Ez nem csupán hasonlat volt. A csoport megmutatta, hogy ha a klasszikus Hopfield-energiafüggvényt kiterjesztjük folytonos állapotokra, és exponenciális kölcsönhatási tagot használunk, a kapott frissítési szabály a következő lesz:
Z = softmax(β · R Wq Wk⊤ Y⊤) Y Wk Wv
ez pedig pontosan a transzformer figyelemképlete. A modern Hopfield-hálózat exponenciálisan sok mintát képes tárolni (az asszociatív tér dimenziójával arányosan), egyetlen frissítéssel előhívja őket, és az előhívási hibák exponenciálisan kicsik.
A tanulmány a modern keretrendszerben háromféle energiaminimumot azonosított: (1) egy globális fixpontot, amely az összes tárolt mintát átlagolja, (2) metastabil állapotokat, amelyek a minták részhalmazait átlagolják, és (3) fixpontokat, amelyek egyetlen mintát tárolnak. Az alsóbb rétegekben a transzformer fejek jellemzően a globális átlagolás tartományában működnek, a magasabb rétegek fejei pedig metastabil állapotokkal gyűjtik és dolgozzák fel az információt. Ez a felismerés mély betekintést ad abba, miért működnek úgy a transzformerek, ahogy működnek.
A gyakorlati következmény azonnali volt: a csapat kiadta a Hopfield-rétegeket drop-in PyTorch modulokként, amelyek leválthatják a pooling rétegeket, a GRU/LSTM rétegeket és a szokásos attention rétegeket. A teljesítménymérésekben ezek a Hopfield-rétegek élvonalbeli eredményeket értek el az immunrepertoár-osztályozásban (mintánként több százezer példánnyal), a többpéldányos tanulási (multiple instance learning) feladatokban, valamint az UCI osztályozási benchmarkokon, ahol a hagyományos mélytanulási módszerek általában nehezen boldogulnak.
2025 decemberében Masumura és Taki egy NeurIPS-cikke még tovább ment: megmutatta, hogy az „adiabatikus közelítésen” túllépve rejtett állapotok bukkannak fel a Hopfield–transzformer megfeleltetésben, amelyek képesek megoldani a mély transzformereket sújtó rangösszeomlás (rank collapse) és tokenegységesedés problémáját, és mindezt egyetlen további tanítási paraméter nélkül, a pontosság javítása mellett.
Egyre szélesebb egyetértés: ki mondja még ugyanezt?
Az az érv, hogy a Hopfield-hálók jelentik a transzformereken túli következő paradigmát, nem puszta találgatás. Nagy kutatóintézetek aktívan dolgoznak rajta, és a bizonyítékok gyorsan gyűlnek. Íme a legfontosabb hangok és tanulmányok, amelyek ugyanarra a következtetésre jutnak.
IBM Research és Dmitry Krotov
2025 januárjában az IBM Research hosszú interjút közölt Dmitry Krotovval, Hopfield régi munkatársával, a Dense Associative Memory egyik megalkotójával. Krotov egyenesen kimondta: mivel a Hopfield-hálók a agy visszacsatolásos, rekurrens köreit tükrözik, ellentétben a mai AI-modellek 90%-ának előrecsatolt architektúrájával, ezért „ígéretes alternatívát jelentenek a mai előrecsatolt hálókkal szemben”. Rámutatott, hogy a transzformerek az információt csak egy irányban dolgozzák fel, és ahogy a kontextusablak hosszabbodik, a számítási komplexitás gyorsan nő. Az agy ezzel szemben rekurrens visszacsatolási hurkokkal foglalja össze és tárolja a múltbeli információkat a memóriában. A Hopfield-hálók ugyanígy működnek.
Krotov bemutatta az Energy Transformert is (NeurIPS 2023), az IBM Research és a Georgia Tech közös munkáját, amely nem pusztán Hopfield-felismeréseket húz rá a meglévő transzformerekre, hanem az előrecsatolt transzformerblokkok teljes sorozatát egyetlen nagy asszociatív memóriamodellel váltja ki. Az Energy Transformer attention-mechanizmusa kifejezetten különbözik a hagyományostól: az energiaminimalizálás alapelveiből származik, nem pedig egy előrecsatolt csővezetékre van ráerősítve.
🔗 IBM Research: „Searching for brain-inspired AI algorithms” (2025. jan.)
🔗 Energy Transformer, arXiv:2302.07253 (NeurIPS 2023)
Johannes Kepler Egyetem – Hochreiter csoportja
Sepp Hochreiter, az LSTM egyik társfeltalálója vezette a csapatot, amely a „Hopfield Networks is All You Need” című cikket publikálta. Az ő Hopfield-rétegek tárháza éles használatra kész PyTorch modulokat kínál, amelyek közvetlenül behelyettesíthetők a transzformerek attention rétegei, a pooling rétegek és a rekurrens rétegek helyére. A kísérő blogbejegyzés lépésről lépésre levezeti, hogy a softmax attention képlete a modern Hopfield-frissítési szabály különleges esete, és hogy a Hopfield-rétegek olyan többletfunkciókat is nyújtanak, amelyekre a hagyományos attention nem képes, például statikus, tanult prototípusokat és rugalmas asszociatívmemória-konfigurációkat.
🔗 Hopfield Networks is All You Need – ICLR 2021
NeurIPS 2025: Hopfield Attention Improves GPT and Vision Transformers
A legfrissebb bizonyíték Masumura és Taki 2025 decemberi NeurIPS-cikkéből származik. Kimutatták, hogy Modern Hopfield Attention (MHA), amely a teljes (nem adiabatikus) Hopfield-dinamikából származtatott rejtett állapotokat ad hozzá, rendszeresen javítja mind a GPT-2 és a LLaMA nyelvi modelleket, mind a Vision Transformereket. A javulás nulla további tanítható paraméterrel járt. Ennél is fontosabb, hogy az MHA megoldotta a rangkollapszus problémáját (amikor a mély transzformerekben az attenciós mátrixok elfajulnak, és minden token hasonló reprezentációba konvergál), amely a transzformerek skálázását régóta sújtó alapvető patológia. A szerzők így zárják: „Reméljük, hogy ez a kutatás új lehetőségeket nyit a Transformer-architektúrák Hopfield-hálózatokkal történő, rendszerszintű tervezése előtt.”
🔗 On the Role of Hidden States of Modern Hopfield Network in Transformer arXiv:2511.20698 (NeurIPS 2025)
Nature Communications: biológiailag hihető online tanulás
2024 májusában a Nature Communications közölt egy munkát a Sparse Quantized Hopfield Networkről, egy olyan modellről, amely lokális tanulási szabályokkal tanul online-folyamatos helyzetekben, pontosan úgy, ahogyan a biológiai agyak. Ez a transzformerek egyik alapvető korlátjára ad választ: azokhoz nem lokális visszaterjesztés (backpropagation) és gondosan összeállított adathalmazokon végzett offline tanítás kell. A tanulmány a Hopfield-alapú architektúrákat a mesterséges neurális hálózatok és a neuromorf számítástechnikai hardverek természetes hídjaként jelöli meg.
🔗 A Sparse Quantized Hopfield Network for Online-Continual Memory Nature Communications (2024)
Outlier-Efficient Hopfield Layers for Large Foundation Models
Egy 2024-es tanulmány a nagy transzformermodellek egy gyakorlati problémájával foglalkozott: hajlamosak figyelmet fordítani információtlan tokenekre (elválasztójelekre, írásjelekre), ez a „no-op outlier” probléma. A megoldásuk egy outlier-hatékony Hopfield-energiafüggvény volt, amely besorolja ezeket a tokeneket, és egy nulla energiájú pontra irányítja őket, így nem hígítják fel a hasznos figyelmet. Az eredményül kapott modell különleges esetként magában foglalja a Softmax₁ attenciót, és BERT, OPT és Vision Transformer modelleken is igazolták. Ez a Hopfield-elmélet a gyakorlatban: valós transzformer-mérnöki problémákat old meg.
🔗 Outlier-Efficient Hopfield Layers for Large Transformer-Based Models (2024)
Transzformerek mint energiaminimalizálók (2026. január)
A legfrissebb elméleti munka, amely 2026 januárjában jelent meg, a transzformer teljes előreterjesztését (forward pass) belső energiaminimalizálásként írja le, és teljes mértékben a Hopfield-szemléletet fogadja el magyarázó keretként ahhoz, hogy a transzformerek egyáltalán miért működnek. A tanulmány a ritka modern Hopfield-modelleket az attenciós változatok teljes családjához (softmax, sparsemax, α-entmax) kapcsolja, megmutatva, hogy mindegyik az energiaalapú visszakeresési dinamika különleges esete.
🔗 Transformers as Intrinsic Optimizers: Forward Inference through the Energy Principle (2026. jan.)
Összefoglaló tanulmányok és közösségi források
A tágabb kutatói közösség e konvergencia köré szerveződik:
- „Energy-Based Learning and the Evolution of Hopfield Networks” (TechRxiv, 2025. április) Átfogó összefoglaló, amely végigköveti a teljes ívet Hopfieldtől (1982) a Boltzmann-gépeken át a transzformer-attenció modern Hopfield-dinamikaként való újraértelmezéséig. → Olvasd el a tanulmányt
- „An Energy-Based Perspective on Attention Mechanisms in Transformers” Mélyreható szakmai blogbejegyzés, amely amellett érvel, hogy a transzformerek Hopfield-energia szemüvegén át történő megértése „minőségileg más fejlesztésekhez vezethet, mint amit pusztán a skálázásra és a számítási összetettség csökkentésére támaszkodva el lehet érni.” → Olvasd el a blogbejegyzést
- Awesome Modern Hopfield Networks Gondosan válogatott GitHub-tárhely, amely több mint 50 tanulmányt gyűjt össze a modern Hopfield-hálózatokról a legkülönbözőbb területeken: eszközallokáció, változásdetektálás, kreatív gondolatok rekonstrukciója, eloszláson kívüli adatok felismerése, immunrepertoár-osztályozás és sok más. → Böngészd át a gyűjteményt
- "Is Hopfield Networks All You Need?" (Analytics India Magazine, 2024. dec.) Gyakorlati szemszögű összefoglaló arról, hogyan mutatta meg Hochreiter csapata, hogy a Hopfield-hálózatok "felcserélhetők a legmodernebb transzformer-modellekkel". → Olvasd el a cikket
- "New Research in Hopfield Networks: A Short Intro" (Medium, 2024. júl.) Közérthető áttekintés, amely rámutat, hogy a tárolókapacitás az exponenciális aktivációs függvényeknek köszönhetően 0,138N-ről 2^(N/2)-re nőtt. → Olvasd el a Mediumon
Az irány egyértelmű. Ez nem egyetlen labor javaslata, és nem is egyetlen tanulmány spekulációja. Az IBM Research, a Johannes Kepler Egyetem, az MIT, a NeurIPS, a Nature Communications és a gépi tanulás tágabb közössége különböző irányokból ugyanarra a következtetésre jut: a Hopfield által megalapozott energiaalapú, asszociatív memóriára épülő paradigma nem csupán az az alap, amelyre a transzformereket tudtukon kívül építették – hanem az a keretrendszer, amely az MI-t messzebbre viheti, mint amire a transzformerek önmagukban képesek.
Miért fontos ez most: érvek az áttérés mellett
Garantált konvergencia a biztonságkritikus rendszerekben
A transzformerek kimenetet állítanak elő, de a stabilitásukra nincs matematikai garancia. A Hopfield-hálózatok bizonyíthatóan stabil állapotokba konvergálnak az energiafüggvény monoton csökken. Robotikában, önvezető járművekben, orvosi eszközökben és mindenhol, ahol a megbízhatóság nem alku tárgya, ez olyan követelmény, amelyet a transzformerek nem tudnak teljesíteni.
Az asszociatív memória mint alapképesség
Ha úgy tanítasz be egy Hopfield-hálózatot, hogy az (1, −1, 1, −1, 1) állapot energiaminimum legyen, majd a sérült (1, −1, −1, −1, 1) bemenetet adod neki, a hálózat a helyes, eltárolt mintázathoz konvergál. Nem találgat és nem interpolál – legördül az energiatájkép lejtőjén a legközelebbi attraktorig. Eltakart szenzorokkal dolgozó robotoknál, zajos adatokat kezelő beágyazott rendszereknél és minden olyan alkalmazásnál, amelynek hiányos bemenetből kell kiegészítenie a mintázatot, ez áttörést jelent.
Univerzális optimalizálómotor
Hopfield és David Tank 1985-ben megmutatta, hogy a Hopfield-hálózatok megoldhatják az utazóügynök-problémát. Ha egy költségfüggvény felírható a Hopfield-energia alakjában, akkor a hálózat egyensúlyi pontjai maguk a megoldások. Azóta az architektúrát alkalmazták már műhelyütemezésre (job-shop scheduling), vezeték nélküli hálózatok csatornakiosztására, képhelyreállításra, analóg-digitális átalakításra, mobil útvonalválasztásra és kombinatorikus optimalizálásra. Egy 2024-es Nature Communications-tanulmány bemutatta a Sparse Quantized Hopfield Network-öt, amely online, folyamatos memóriatanulásra képes helyi szabályokkal, ugyanúgy, ahogy a biológiai agy – ez a képesség a transzformerekből alapvetően hiányzik.
Hardver, amely szoftver nélkül gondolkodik
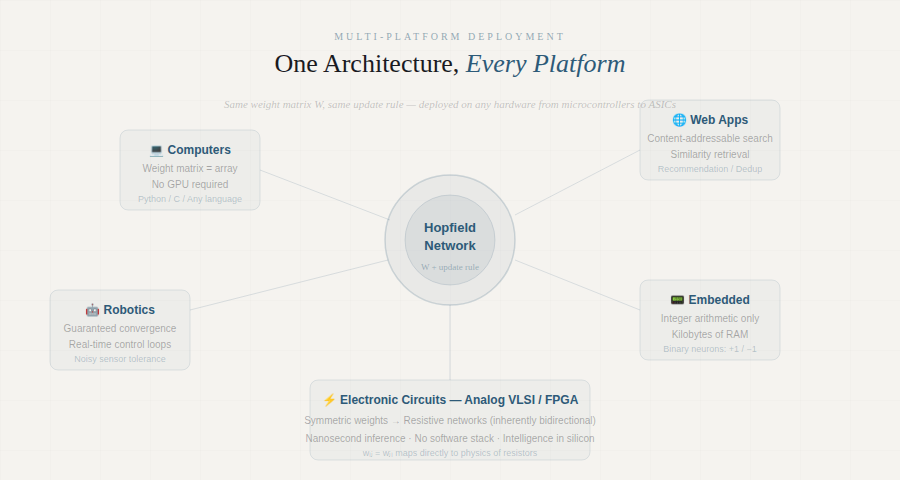
A szimmetrikus súlykorlátozás (wᵢⱼ = wⱼᵢ) közvetlenül leképezhető analóg elektronikus áramkörökre – egy ellenállásos kapcsolat eleve szimmetrikus. A Hopfield-hálózatok ASIC-ként vagy FPGA-ként is megvalósíthatók, nanoszekundumos következtetési idővel. A Nature 2025-ös neuromorf számítástechnikai gyűjteménye megerősíti ezt az irányt: energiahatékony analóg hardver, amely az élen (edge) valósítja meg a neurális dinamikát, tartalom szerint címezhető memóriával, amelyhez nem kell GPU, CPU vagy szoftververem.
Neuromorf és analóg MI-chipek, amelyek a neurális hálózatok dinamikáját közvetlenül hardverben valósítják meg. A Hopfield-hálózatok szimmetrikus, energiaalapú felépítése természetes módon leképezhető ellenállásos áramkörökre, így az MI-következtetés nanoszekundumos időskálán, hagyományos szoftververmek nélkül is megvalósítható.
Bináris és folytonos rugalmasság
A klasszikus Hopfield-hálózatok bináris neuronokat használnak (+1 vagy −1); a folytonos változatok szigmoid aktivációt és differenciálegyenleteket. A frissítés lehet aszinkron (egyszerre egy neuron, ami garantálja a konvergenciát) vagy szinkron (mindegyik egyszerre, ami lehetővé teszi a párhuzamosítást). Ugyanez az architektúra alkalmazkodik a néhány kilobájt RAM-mal rendelkező mikrokontrollertől a masszívan párhuzamos FPGA-ig, a modern Hopfield-rétegekkel pedig mostanra a GPU-gyorsított mélytanulási folyamatokig is.
Tárolókapacitás: az őszinte korlát
A klasszikus korlát egyértelmű: egy N neuronból álló hálózat megbízhatóan nagyjából 0.138N mintát képes tárolni, mielőtt a hamis állapotok rontani kezdik a visszakeresést. Ez valódi korlát, de őszinte korlát. A transzformereknek nincs ilyen tiszta matematikai határuk arra, mikor kezdenek hallucinálni.
Ráadásul a modern Hopfield-hálózatok (Krotov & Hopfield, 2016; Demircigil et al., 2017) magasabb rendű kölcsönhatási tagok révén exponenciális tárolókapacitást érnek el. A kutatás tovább tágítja ezeket a határokat: a ritka és strukturált Hopfield-hálózatok, a hosszú sorozatokat kezelő Hopfield-memória és a vagyonallokációra szánt Hopfield-hálózatok mind aktívan fejlődő területek, a publikációk pedig rohamosan szaporodnak.
A gyakorlati alkalmazás: a PC-któl az áramkörökig
A korai neurálishálózat-kutatók eredeti víziója egyértelmű volt: olyan keretrendszer, amelyet elég egyszer leírni, és mindenhol alkalmazható. A Hopfield-architektúra ezt valósítja meg:
Számítógépes alkalmazások Egy súlymátrix és egy frissítési szabály. GPU nélkül is megy.
Internetes alkalmazások Tartalom szerint címezhető memória hasonlóságkereséshez, ajánlórendszerekhez és duplikátumszűréshez.
Robotika Garantált konvergencia valós idejű vezérlőhurkokhoz. A mozgásmintákat attraktorokként tárolja, és zajos szenzorbemenetből is képes felidézni őket.
Beágyazott rendszerek A bináris Hopfield-hálózatok mikrokontrollereken is futnak, pusztán egész aritmetikával.
Elektronikus áramkörök A szimmetrikus súlyok ellenállás-hálózatokra képezhetők le. Az intelligencia közvetlenül szilíciumba gyártva.
Az előttünk álló út
A transzformerek kora rendkívüli nyelvi gépeket adott nekünk. A határvonal azonban a fizikai világ felé tolódik: robotok, szenzorok, beavatkozók és valós idejű döntések felé. Ehhez olyan architektúrákra van szükség, amelyek stabilak, hatékonyak, értelmezhetők, és ott is telepíthetők, ahol a hardver ténylegesen elérhető: a peremen (edge).
A 2020-as bizonyítás, hogy a transzformerek figyelmi mechanizmusa maga egy modern Hopfield-frissítési szabály, nem csupán matematikai érdekesség volt: kiderült belőle, hogy végig Hopfield-hálózatokat használtunk, csak egy olyan keretbe csomagolva, amely elfedte valódi természetüket. A 2025-ös NeurIPS-munka, amely megmutatja, hogy a Hopfield-rejtett állapotok megoldják a transzformerek olyan bajait, mint a rangösszeomlás (rank collapse), a következő lépésre utal: nem a transzformereket kell Hopfield-felismerésekkel foltozgatni, hanem közvetlenül a Hopfield-paradigmára építeni.
John Hopfield 1982-ben megmutatta az utat. Donald Hebb 1949-ben lefektette a biológiai alapokat. A kutatói közösség most kezd egy irányba tartani.
Itt az ideje váltani.
Hivatkozások
- Hopfield, J.J. (1982). "Neural networks and physical systems with emergent collective computational abilities." PNAS, 79(8), 2554–2558.
- Hebb, D.O. (1949). The Organization of Behavior. Wiley.
- Ramsauer, H. et al. (2020). "Hopfield Networks is All You Need." ICLR 2021. arXiv:2008.02217
- Krotov, D. & Hopfield, J.J. (2016). "Dense Associative Memory for Pattern Recognition." NeurIPS.
- Storkey, A. (1997). "Increasing the capacity of a Hopfield network without sacrificing functionality." ICANN.
- Hoover, B., Krotov, D. et al. (2023). "Energy Transformer." NeurIPS 2023. arXiv:2302.07253
- Masumura, T. & Taki, M. (2025). "On the Role of Hidden States of Modern Hopfield Network in Transformer." NeurIPS 2025. arXiv:2511.20698
- Alonso, N. & Krichmar, J. (2024). "A sparse quantized Hopfield network for online-continual memory." Nature Communications, 15, 3722. nature.com
- Hu, J.Y. et al. (2024). "Outlier-Efficient Hopfield Layers for Large Transformer-Based Models." arXiv:2404.03828
- Hu, J.Y. et al. (2026). "Transformers as Intrinsic Optimizers: Forward Inference through the Energy Principle." arXiv:2511.00907
- Hopfield, J.J. & Tank, D.W. (1985). "'Neural' Computation of Decisions in Optimization Problems." Biological Cybernetics, 52, 141–152.
- Bruck, J. (1990). "On the convergence properties of the Hopfield model." Proceedings of the IEEE.
- Krotov, D. (2025). "Searching for brain-inspired AI algorithms." IBM Research Blog. research.ibm.com
- "Energy-Based Learning and the Evolution of Hopfield Networks." TechRxiv, 2025. április. techrxiv.org

