
ヘッブ学習とホップフィールド・ネットワークの出会い:トランスフォーマーよりずっと賢かったアーキテクチャ
この10年、トランスフォーマーとそのアテンション機構はAIの世界を席巻してきました。GPTからBERT、Vision Transformerに至るまで、「Attention is all you need(必要なのはアテンションだけ)」という合言葉が、機械学習の考え方そのものを塗り替えたのです。データをある表現から別の表現へと変換するトランスレーター系のシステム、つまりエンコーダ・デコーダのパイプラインは、言語処理から画像生成まであらゆるものの土台になりました。革命的でした。そして強力でした。
ところが今、その進歩は壁にぶつかっています。
皮肉なことに、その解決策は1982年から存在していました。この年、ジョン・ホップフィールドは『Proceedings of the National Academy of Sciences』に論文を発表し、トランスフォーマーが一度も本当には手にできていない性質を備えたリカレントニューラルネットワークを提示しました。エネルギー最小化を通じて、安定状態への収束が保証されるという性質です。ホップフィールド・ネットワークは単にパターンを学習するのではなく、エネルギー地形の中に物理的なアトラクタとして記憶します。そのため、ノイズの多い入力や不完全な入力からでも取り出すことができます。
物理学と神経科学の世界で何十年も前から知られていたことを、AIコミュニティはようやく理解し始めたところです。エネルギーベースの連想的なニューラル計算は、歴史上の珍しい一例などではなく、トランスフォーマーの時代が十分に理解しないまま上に積み上げてきた、基礎となるパラダイムなのです。
トランスフォーマーの天井
トランスフォーマーは、セルフアテンションによって、系列内のすべての要素間の関係を同時に計算します。言語にはうってつけですし、明確な順序パターンを持つ構造化データにも見事に働きます。けれども現実世界、つまりロボティクス、組み込み回路、センサー駆動の意思決定、エッジコンピューティングの世界は、アテンションを向けられるのを待つ整然とした系列の形をしてはいません。
トランスフォーマーのアーキテクチャは、潤沢さを前提にしています。潤沢な計算資源、潤沢なメモリ、潤沢な電力です。セルフアテンションは系列長に対して二乗で増大します。フィードフォワード層の増え方は線形ですが、規模が桁違いです。倉庫内を動き回るモバイルロボットや、製造用アームを制御する電子回路にトランスフォーマーベースのシステムを載せようとすると、こうした前提は崩れ去ります。
トランスレーターというパラダイムには、それ自体の限界もあります。知能を、固定された表現同士の変換問題として主に捉えているのです。入力をエンコードし、出力をデコードする。しかし本当の知能は、ただ変換するだけではありません。記憶し、連想し、入力が劣化していたり曖昧だったりしても、安定した解釈へと収束するのです。
私たちはこうした問題を、量子化、蒸留、枝刈り、そのほか無数の最適化テクニックで取り繕ってきました。2025年のエッジAIに関するサーベイも、組み込みハードウェア上でのディープラーニングの展開は依然として「メモリ、計算、エネルギーの厳しい制約に縛られている」と確認しています。しかし、根本的にミスマッチなアーキテクチャをいくら最適化しても、決着を先延ばしにするだけです。必要なのは、メモリ、安定性、エネルギー効率を後付けではなく第一原理として扱うアーキテクチャです。
ホップフィールド・ニューラルネットワークの登場
ホップフィールド・ネットワークは、1層のニューロンからなるリカレントニューラルネットワークで、各ニューロンは自分自身を除くすべてのニューロンと結合しています。このネットワークは完全無向グラフを成します。すべてのニューロンの組が対称な結合重みを共有しており、ニューロンiからニューロンjへの結合の強さは、jへのi。自己結合はありません(wᵢᵢ = 0)。層状の階層もなく、逐次的な処理パイプラインもありません。その代わり、ネットワーク全体がひとつの相互結合した力学系として機能し、時間とともに安定した平衡状態へと発展していきます。
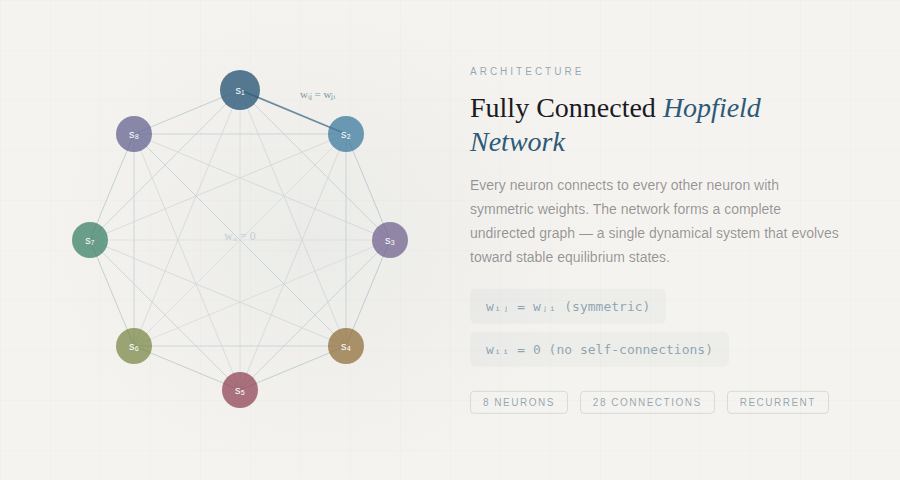
全結合のニューロンからなるホップフィールド・ネットワーク。すべてのノードが、対称な重み(wᵢⱼ = wⱼᵢ)で他のすべてのノードとつながり、完全な無向グラフを形作っています。自己結合は存在しません。
このアーキテクチャの美しさは、そのエネルギー関数にあります。ホップフィールドは、このネットワークにリアプノフ・エネルギー関数が対応することを証明しました。
E = −½ Σᵢ Σⱼ wᵢⱼ sᵢ sⱼ − Σᵢ θᵢ sᵢ
このエネルギーは、ニューロンを更新するたびに必ず減少する(あるいは変わらない)ことが保証されています。ネットワークは必ず収束します。延々と振動することも、発散することも、終わりのない計算ループにはまり込むこともありません。やがて落ち着くのです。1990年にブルックは、この収束の挙動がネットワークに対応するグラフのカットと結びついていることを証明しました。ネットワークは更新のたびに、実質的に最大カット問題に対する貪欲法を実行しているのです。
そして、ネットワークが落ち着く先にこそ、知性が宿ります。記憶されたパターンは、エネルギー関数の局所最小値、つまりエネルギー地形の谷に対応します。破損したもの、ノイズの混じったもの、あるいは不完全なかたちの記憶パターンをネットワークに与えると、ダイナミクスがネットワークの状態を坂の下へ転がし、いちばん近い谷、すなわち入力にもっともよく合致する記憶パターンへと落ち着かせます。
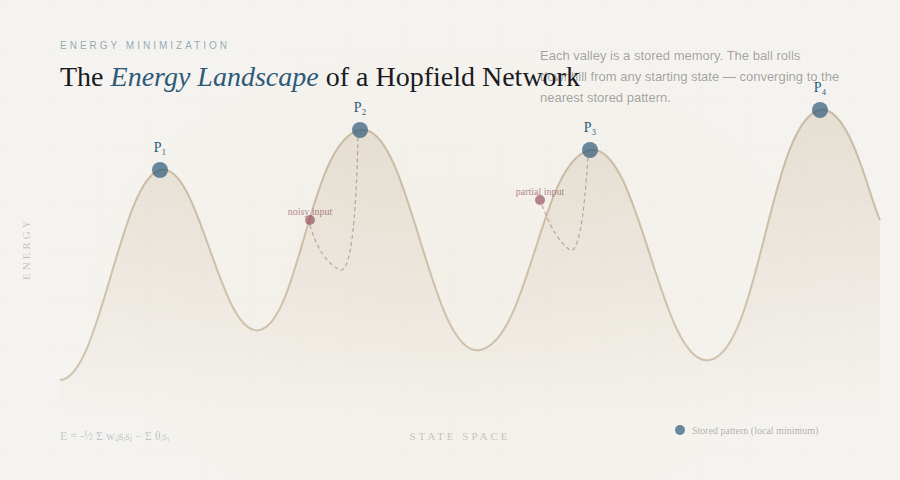
ホップフィールド・ネットワークのエネルギー地形。それぞれの谷(局所最小値)が、記憶された1つのパターンに対応します。どんな初期状態から始めても、ネットワークのダイナミクスは「坂の下」へと転がり、いちばん近いアトラクタに落ち着いて、部分的な入力やノイズの混じった入力から完全なパターンを復元します。
これが内容アドレス方式の連想記憶、つまり断片的な手がかりから完全な記憶を呼び起こす能力です。生物の脳は難なくこなしますが、トランスフォーマーは高価な計算を重ねてようやく近似できるにすぎません。
物理学とのつながりは深いものです。ホップフィールド・ネットワークは数学的にイジング模型と等価で、統計力学で磁性を記述するのと同じ枠組みです。1975年に発表されたスピングラスのシェリントン=カークパトリック模型は、本質的にはランダムな重みを持つホップフィールド・ネットワークです。ホップフィールドの洞察は、この性質をあえて利用し、それぞれの極小値が有用な記憶パターンに対応するようにエネルギー地形を設計したことにありました。
ヘッブ学習:ともに発火するニューロンは、ともに結びつく
ホップフィールド・ネットワークを機能させる学習則のルーツは、さらにさかのぼってドナルド・ヘッブが1949年に著した『行動の機構』にあります。この本は、今日では神経学習理論の基本原理とされる考え方を提唱しました。
ヘッブの洞察は、一見ごく単純でした。シナプス前細胞がシナプス後細胞の発火に繰り返し持続的に関与すると、両者のあいだのシナプス結合が強まるというものです。「ともに発火するニューロンは、ともに結びつく」と言われますが、ヘッブ自身はもっと厳密で、細胞Aは単に同時に発火するのではなく、細胞Bの発火を引き起こすことに関与しなければならないと強調していました。この時間的な因果関係は、のちに実験で確かめられたスパイクタイミング依存可塑性(STDP)の先駆けとなりました。エリック・カンデルによるウミウシアメフラシ(Aplysia californica).
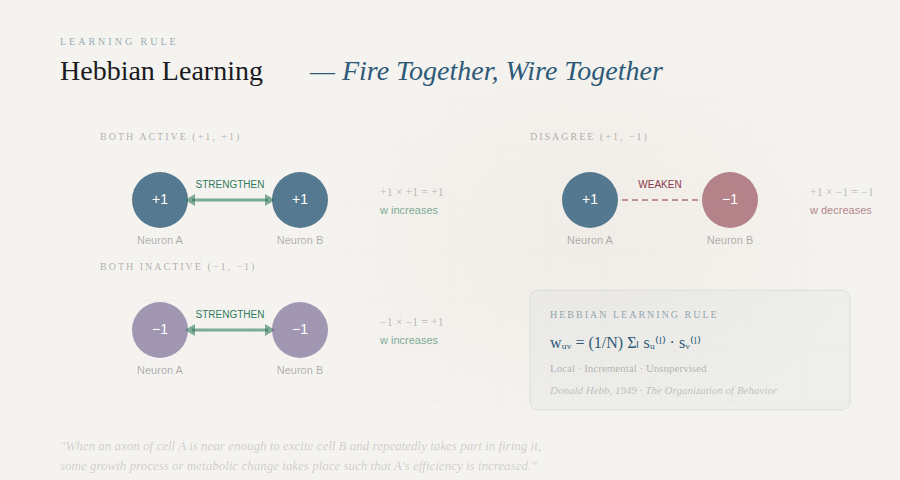
ヘッブ学習:結合した2つのニューロンが繰り返し同時に活動すると、その間のシナプスは強化されます。「同時に発火するニューロン同士は結びつく」というこの原理は、ホップフィールド・ネットワークがパターンを記憶する仕組みの生物学的な土台です。
ホップフィールド・ネットワークでは、ヘッブ学習は次のように実装されます:
wᵤᵥ = (1/N) Σₗ sᵤ(l) · sᵥ(l) 記憶させるすべてのパターン l について。ただし u ≠ v
あるパターンの中で2つのニューロンが同じ状態(ともに +1、またはともに −1)であれば、その積は正になり、興奮性の結合が強まります。状態が食い違えば積は負になり、抑制性の結合が生まれます。この積み重ねによって、記憶された各パターンの位置に谷をもつエネルギー地形が形づくられていきます。
ヘッブの法則は局所的(各重みの更新に使うのは、結合した2つのニューロンが持つ情報だけ)であり、かつ漸進的(古いパターンを再処理しなくても新しいパターンを記憶できる)です。注目すべきことに、ヘッブ学習は入力データに対する教師なしの主成分分析(PCA)を数学的に行っていることが示せます。つまりネットワークは、環境から統計的にもっとも重要な特徴を自然に抽出するのです。
1997年、エイモス・ストーキー(Amos Storkey)は、各ニューロンの局所場を考慮に入れた改良版の学習則を発表し、標準的なヘッブ学習より大きな記憶容量を実現しました。これは、同じアーキテクチャの中でさえ、学習アルゴリズムの選び方が深く影響することを示しています。ニューラルネットワーク研究全体から得られる教訓とも響き合う原理です。
転機:「Hopfield Networks is All You Need」
2020年、リンツ・ヨハネス・ケプラー大学のフーベルト・ラムザウアー(Hubert Ramsauer)率いるチームが、トランスフォーマーの誕生を告げた論文を思わせる、挑発的なタイトルの論文を発表しました。「Hopfield Networks is All You Need」です。彼らの貢献は、多くの人が予感していたことの数学的な証明でした。トランスフォーマーのセルフアテンション機構は、現代的な連続ホップフィールド・ネットワークの更新則とまったく同じだというのです。
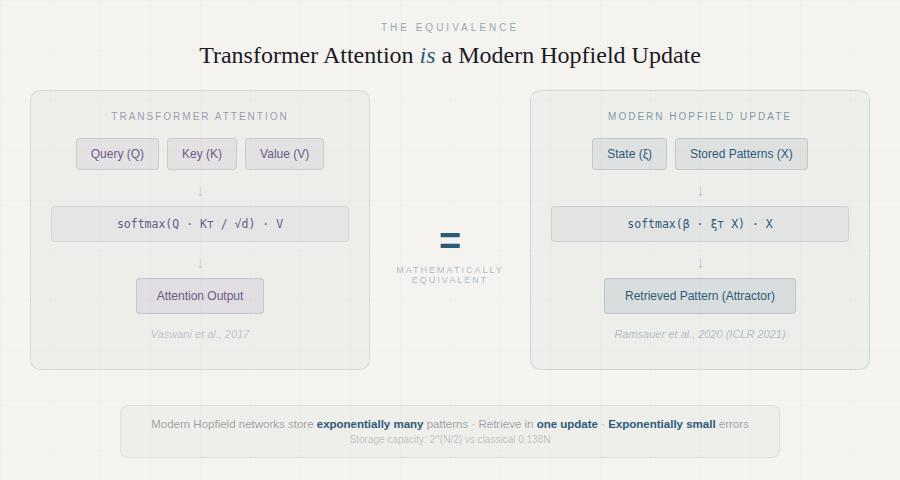
現代のホップフィールド・ネットワークとトランスフォーマーのアテンションの関係。トランスフォーマーのソフトマックスに基づくアテンション機構は、指数型エネルギー関数をもつ連続ホップフィールド・ネットワークの1回の更新ステップと数学的に等価です。画像:Ramsauer et al.「Hopfield Networks is All You Need」より。
これは単なる類推ではありませんでした。チームは、古典的なホップフィールドのエネルギー関数を連続状態へと一般化し、指数型の相互作用項を用いることで、更新則が次の形になることを示しました:
Z = softmax(β · R Wq Wk⊤ Y⊤) Y Wk Wv
これはまさにトランスフォーマーのアテンションの式です。現代的なホップフィールド・ネットワークは、連想空間の次元に対して指数関数的な数のパターンを記憶でき、1回の更新でそれらを検索でき、検索誤差も指数関数的に小さくなります。
この論文は、現代的な枠組みにおける3種類のエネルギー極小を特定しました:(1) 記憶されたすべてのパターンを平均化する大域的な固定点、(2) パターンの部分集合を平均化する準安定状態、そして(3) 単一のパターンを記憶する固定点です。トランスフォーマーの下位層のヘッドは大域的な平均化の領域で動作する傾向があり、上位層のヘッドは準安定状態を使って情報を集め、処理します。この発見は、トランスフォーマーがなぜそのように機能するのかを深く理解する手がかりになります。
実用面での意味はすぐに現れました。チームはHopfield layersで、プーリング層、GRU/LSTM層、標準的なアテンション層を置き換えられるドロップイン式のPyTorchモジュールとして提供しました。ベンチマークでは、これらのHopfield層は、免疫レパートリー分類(1サンプルあたり数十万のインスタンス)、多重インスタンス学習の問題、そして従来のディープラーニング手法が苦戦しがちなUCI分類ベンチマークで、最先端の結果を達成しました。
2025年12月には、MasumuraとTakiによるNeurIPS論文がさらに踏み込み、「断熱近似」を超えることで、Hopfieldとトランスフォーマーの対応関係に潜む隠れ状態が明らかになることを示しました。この隠れ状態は、深いトランスフォーマーを悩ませるランク崩壊とトークンの均一化の問題を解決でき、学習パラメータを一切増やさずに精度を向上させます。
広がるコンセンサス:ほかに誰が同じことを語っているのか?
Hopfieldネットワークがトランスフォーマーの次のパラダイムになるという主張は、憶測ではありません。主要な研究機関が積極的に取り組んでおり、その裏付けは急速に積み上がっています。同じ結論に向かって収束している主要な声と論文を紹介します。
IBM ResearchとDmitry Krotov
2025年1月、IBM ResearchはDmitry Krotovへの長編インタビューを公開しました。KrotovはHopfieldの長年の共同研究者であり、Dense Associative Memory(高密度連想記憶)の設計者の一人です。彼ははっきりと主張しました。Hopfieldネットワークは脳の再帰的なフィードバックループを映し出しており、現在のAIモデルの90%が採用するフィードフォワード型のアーキテクチャとは異なるため、「今日のフィードフォワードネットワークに代わる有望な選択肢」になる、というのです。トランスフォーマーは情報を一方向にしか処理せず、コンテキストウィンドウが長くなるにつれて計算の複雑さが急激に増大すると、彼は指摘しました。対照的に脳は、再帰的なフィードバックループを使って過去の情報を要約し、記憶に蓄えています。Hopfieldネットワークも同じ仕組みで動きます。
KrotovはさらにEnergy Transformer(NeurIPS 2023)についても語りました。これはIBM ResearchとGeorgia Techの共同研究で、既存のトランスフォーマーにHopfieldの知見を重ねるだけではありません。フィードフォワード型のトランスフォーマーブロックの連なり全体を、単一の大規模な連想記憶モデルに置き換えるものです。Energy Transformerのアテンション機構は、従来のアテンションとは明確に異なります。フィードフォワードのパイプラインに後付けしたものではなく、エネルギー最小化という第一原理から導かれているのです。
🔗 IBM Research「Searching for brain-inspired AI algorithms」(2025年1月)
🔗 Energy Transformer arXiv:2302.07253(NeurIPS 2023)
ヨハネス・ケプラー大学 - Hochreiter研究室
LSTMの共同考案者であるSepp Hochreiterは、「Hopfield Networks is All You Need」を発表したチームを率いました。彼らのHopfield層リポジトリは、トランスフォーマーのアテンション層、プーリング層、再帰層のドロップイン代替として使える、実運用レベルのPyTorchモジュールを提供しています。付属のブログ記事では、ソフトマックス・アテンションの式が現代的なHopfield更新則の特殊なケースであることを数学的に導き、さらにHopfield層には、静的な学習済みプロトタイプや柔軟な連想記憶の構成など、標準的なアテンションにはない追加機能があることを解説しています。
🔗 Hopfield Networks is All You Need - ICLR 2021
NeurIPS 2025: Hopfield Attention Improves GPT and Vision Transformers
最も新しい裏付けは、MasumuraとTakiによる2025年12月のNeurIPS論文です。彼らは次のことを示しました。現代ホップフィールド・アテンション(MHA)は、完全な(非断熱的でない)ホップフィールド動力学から導かれる隠れ状態を加えることで、GPT-2とLLaMAの言語モデル、さらにVision Transformerのいずれも体系的に改善します。しかも、学習パラメータの追加は一切ありません。さらに重要なのは、MHAがランク崩壊(深いTransformerでアテンション行列が退化し、すべてのトークンが似通った表現に収束してしまう現象)という、Transformerのスケーリングを長く悩ませてきた根本的な病理を解消できると分かったことです。著者らはこう結論づけています。「この研究が、ホップフィールド・ネットワークを用いたTransformerアーキテクチャの体系的な設計に、新たな可能性を開くことを願っています。」
🔗 On the Role of Hidden States of Modern Hopfield Network in Transformer arXiv:2511.20698(NeurIPS 2025)
Nature Communications:生物学的に妥当なオンライン学習
2024年5月、Nature Communicationsに、疎量子化ホップフィールド・ネットワーク(Sparse Quantized Hopfield Network)に関する研究が掲載されました。これは、オンライン連続学習の場面で、まさに生物の脳と同じように局所的な学習則で学習するモデルです。非局所的なバックプロパゲーションと、厳選されたデータセットでのオフライン学習を必要とするTransformerの根本的な限界に応える成果です。この論文は、ホップフィールド型アーキテクチャを、人工ニューラルネットワークとニューロモーフィック・コンピューティング用ハードウェアをつなぐ自然な架け橋として位置づけています。
🔗 A Sparse Quantized Hopfield Network for Online-Continual Memory Nature Communications (2024)
大規模基盤モデル向けの外れ値効率的ホップフィールド層
2024年のある論文は、大規模Transformerモデルの実用上の問題、つまり区切り文字や句読点のような情報量の乏しいトークンにアテンションを割り当ててしまう傾向、いわゆる「no-op外れ値」問題に取り組みました。その解決策が外れ値効率的ホップフィールド・エネルギー関数です。これはそうしたトークンを分類してゼロエネルギーの点に振り分け、有用なアテンションが薄まるのを防ぎます。得られたモデルはSoftmax₁アテンションを特殊な場合として含み、BERT、OPT、Vision Transformerで有効性が検証されました。ホップフィールド理論が、現実のTransformer工学の問題を解決した例と言えます。
🔗 Outlier-Efficient Hopfield Layers for Large Transformer-Based Models (2024)
エネルギー最小化器としてのTransformer(2026年1月)
2026年1月に発表された最新の理論研究は、Transformerのフォワードパス全体を本質的なエネルギー最小化として捉えています。そもそもなぜTransformerが機能するのかを説明する枠組みとして、ホップフィールドの視点を全面的に採用したものです。この論文は、疎な現代ホップフィールド・モデルをアテンションの変種(softmax、sparsemax、α-entmax)のファミリー全体に結びつけ、それらがすべてエネルギーベースの想起動力学の特殊な場合であることを示しています。
🔗 Transformers as Intrinsic Optimizers: Forward Inference through the Energy Principle(2026年1月)
レビュー論文とコミュニティの資料
より広い研究コミュニティも、この収束を軸に動き始めています。
- "Energy-Based Learning and the Evolution of Hopfield Networks"(TechRxiv、2025年4月)ホップフィールド(1982年)からボルツマンマシンを経て、Transformerのアテンションを現代ホップフィールド動力学として捉え直すまでの全体像をたどった、包括的なレビューです。→ 論文を読む
- "An Energy-Based Perspective on Attention Mechanisms in Transformers"ホップフィールドのエネルギーという視点からTransformerを理解すれば、「スケーリングや計算量の削減だけに頼るのでは得られない、質的に異なる改善につながるかもしれない」と論じる、技術的に踏み込んだブログ記事です。→ ブログを読む
- Awesome Modern Hopfield Networks アセットアロケーション、変化検出、創造的思考の再構成、分布外検出、免疫レパートリー分類など、さまざまな分野にわたる50本以上のモダン・ホップフィールド・ネットワーク関連論文をまとめたGitHubリポジトリ。 → コレクションを見る
- 「Is Hopfield Networks All You Need?」(Analytics India Magazine、2024年12月)ホップフィールド・ネットワークが「最先端のトランスフォーマーモデルと互換性がある」ことをホッホライターのチームがどのように示したかを、実務者の視点で取り上げた記事。 → 記事を読む
- 「New Research in Hopfield Networks: A Short Intro」(Medium、2024年7月)指数型活性化関数によって記憶容量が0.138Nから2^(N/2)にまで拡大したことを紹介する、わかりやすい概説。 → Mediumで読む
進む方向は明らかです。これは、ひとつの研究所の提案でも、ひとつの論文の推測でもありません。IBM Research、ヨハネス・ケプラー大学リンツ、MIT、NeurIPS、Nature Communications、そして機械学習コミュニティ全体が、それぞれ異なる方向から同じ結論にたどり着きつつあります。ホップフィールドが確立したエネルギーベースの連想記憶というパラダイムは、トランスフォーマーが知らず知らずのうちにその上に築かれてきた土台であるだけでなく、トランスフォーマー単体では到達できない先へAIを導く枠組みになる、という結論です。
いま重要な理由:乗り換えるべき根拠
安全が最優先されるシステムのための収束保証
トランスフォーマーは出力を生成しますが、その安定性を数学的に保証するものはありません。ホップフィールド・ネットワークは、エネルギー関数が単調に減少することから、証明によって安定状態へ収束します。ロボティクス、自動運転車、医療機器など、信頼性が譲れないあらゆるシステムにとって、これはトランスフォーマーには満たせない要件です。
中核機能としての連想記憶
状態 (1, −1, 1, −1, 1) がエネルギー最小点になるようにホップフィールド・ネットワークを訓練し、そこに破損した入力 (1, −1, −1, −1, 1) を与えると、ネットワークは正しく記憶されたパターンへ収束します。推測も補間もしません。エネルギーの地形を最も近いアトラクタへと転がり落ちていくのです。センサーが遮られるロボティクス、ノイズの多いデータを扱う組み込みシステム、部分的な入力からパターンを補完する必要のあるあらゆる用途にとって、これは革新的です。
万能の最適化エンジン
ホップフィールドとデイヴィッド・タンクは1985年、ホップフィールド・ネットワークで巡回セールスマン問題を解けることを示しました。コスト関数をホップフィールドのエネルギーの形で書き表せるなら、ネットワークの平衡点こそが解になります。それ以来、このアーキテクチャはジョブショップ・スケジューリング、無線ネットワークのチャネル割り当て、画像復元、アナログ・デジタル変換、モバイル・ルーティング、組合せ最適化などに応用されてきました。2024年のNature Communications誌の論文では、スパース量子化ホップフィールド・ネットワークが紹介されました。これは、生物の脳と同じように局所的なルールでオンライン連続記憶学習を行うもので、トランスフォーマーには根本的に欠けている能力です。
ソフトウェアなしで考えるハードウェア
対称な重みの制約(wᵢⱼ = wⱼᵢ)は、アナログ電子回路にそのまま対応します。抵抗による接続は本質的に対称だからです。ホップフィールド・ネットワークはASICやFPGAとして製造でき、ナノ秒単位の推論が可能です。2025年のNature誌のニューロモーフィック・コンピューティング特集も、この方向性を裏づけています。ニューラルダイナミクスを実装するエネルギー効率の高いアナログハードウェアがエッジで動き、GPUもCPUもソフトウェアスタックも要らない内容アドレス指定メモリを備えるのです。
ニューロモルフィックおよびアナログAIチップは、ニューラルネットワークのダイナミクスをハードウェア上で直接実装します。ホップフィールド・ネットワークの対称でエネルギーベースの構造は抵抗回路にごく自然に対応するため、従来のソフトウェアスタックを介さず、ナノ秒単位のAI推論が可能になります。
バイナリにも連続値にも対応できる柔軟性
古典的なホップフィールド・ネットワークはバイナリのニューロン(+1 または −1)を使います。連続型の変種ではシグモイド活性化関数と微分方程式を用います。更新方式は、非同期(ニューロンを1つずつ更新し、収束を保証する)にも、同期(全ニューロンを一斉に更新し、並列処理を可能にする)にもできます。同じアーキテクチャが、数キロバイトのRAMしかないマイコンから大規模並列のFPGAまで対応でき、現代のホップフィールド層の登場により、今ではGPUで高速化されたディープラーニングのパイプラインにも適応します。
記憶容量:正直な制約
古典的な限界ははっきりしています。N個のニューロンからなるネットワークが確実に記憶できるパターンは約0.138N個までで、それを超えると擬似状態が検索精度を下げ始めます。これは現実の制約ですが、正直な制約でもあります。トランスフォーマーには、幻覚(ハルシネーション)を起こし始める時点を示す明快な数学的上限がありません。
さらに、現代のホップフィールド・ネットワーク(Krotov & Hopfield, 2016、Demircigil et al., 2017)は、高次の相互作用項によって指数関数的な記憶容量を実現します。研究は今もこの限界を押し広げ続けています。スパースで構造化されたホップフィールド・ネットワーク、長いシーケンスのためのホップフィールド記憶、資産配分のためのホップフィールド・ネットワークなどはいずれも活発な開発分野で、論文は急速に増えています。
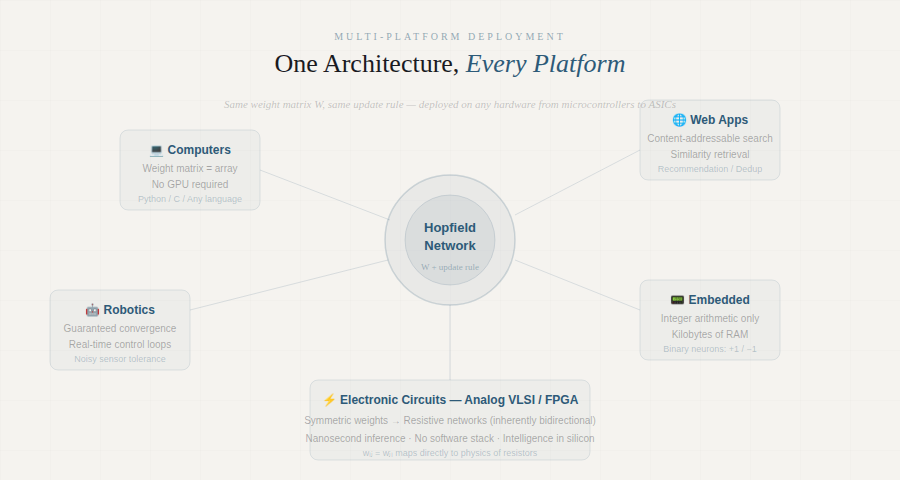
実用的な展開:PCから回路まで
初期のニューラルネットワーク研究者が描いた構想は明快でした。一度記述すれば、どこにでも展開できるフレームワークです。ホップフィールドのアーキテクチャは、それを実現します。
コンピューターアプリケーション重み行列と更新ルールだけ。GPUは不要です。
インターネットアプリケーション類似検索、レコメンデーション、重複排除のための連想記憶(内容アドレス指定メモリ)。
ロボティクスリアルタイム制御ループに対して収束が保証されます。モーターパターンはアトラクターとして保存され、ノイズの多いセンサー入力からでも想起できます。
組み込みシステムバイナリのホップフィールド・ネットワークは、整数演算だけでマイコン上で動作します。
電子回路対称な重みは抵抗ネットワークにそのまま対応します。知能をシリコン上に直接作り込めます。
これからの道
トランスフォーマーの時代は、並外れた言語マシンを私たちにもたらしました。しかしフロンティアは今、物理世界へと広がっています。ロボット、センサー、アクチュエーター、そしてリアルタイムの意思決定です。このフロンティアが求めるのは、安定していて、効率的で、解釈しやすく、エッジに実在するハードウェアに展開できるアーキテクチャです。
2020年に示された、トランスフォーマーのアテンションが現代のホップフィールドの更新ルールそのものであるという証明は、単なる数学的な好奇心にとどまりませんでした。私たちはずっとホップフィールド・ネットワークを使ってきたのに、その本質が見えにくい枠組みに包まれていただけだ、ということを明らかにしたのです。2025年のNeurIPSでは、ホップフィールドの隠れ状態がランク崩壊などのトランスフォーマーの病理を解消することが示されました。ここから見えてくる次の一歩は、ホップフィールドの知見でトランスフォーマーを継ぎはぎすることではなく、ホップフィールドのパラダイムそのものの上に直接構築することです。
ジョン・ホップフィールドは1982年に道を示しました。ドナルド・ヘッブは1949年に生物学的な土台を築きました。研究コミュニティは今、そこへ収束しつつあります。
切り替える時が来ました。
参考文献
- Hopfield, J.J. (1982). "Neural networks and physical systems with emergent collective computational abilities." PNAS, 79(8), 2554–2558.
- Hebb, D.O. (1949). The Organization of Behavior。Wiley。
- Ramsauer, H. et al. (2020). 「Hopfield Networks is All You Need.」 ICLR 2021. arXiv:2008.02217
- Krotov, D. & Hopfield, J.J. (2016). 「Dense Associative Memory for Pattern Recognition.」 NeurIPS.
- Storkey, A. (1997). 「Increasing the capacity of a Hopfield network without sacrificing functionality.」 ICANN.
- Hoover, B., Krotov, D. et al. (2023). 「Energy Transformer.」 NeurIPS 2023. arXiv:2302.07253
- Masumura, T. & Taki, M. (2025). 「On the Role of Hidden States of Modern Hopfield Network in Transformer.」 NeurIPS 2025. arXiv:2511.20698
- Alonso, N. & Krichmar, J. (2024). 「A sparse quantized Hopfield network for online-continual memory.」 Nature Communications, 15, 3722. nature.com
- Hu, J.Y. et al. (2024). 「Outlier-Efficient Hopfield Layers for Large Transformer-Based Models.」 arXiv:2404.03828
- Hu, J.Y. et al. (2026). 「Transformers as Intrinsic Optimizers: Forward Inference through the Energy Principle.」 arXiv:2511.00907
- Hopfield, J.J. & Tank, D.W. (1985). 「'Neural' Computation of Decisions in Optimization Problems.」 Biological Cybernetics, 52, 141–152.
- Bruck, J. (1990). 「On the convergence properties of the Hopfield model.」 Proceedings of the IEEE.
- Krotov, D. (2025). 「Searching for brain-inspired AI algorithms.」 IBM Research Blog. research.ibm.com
- 「Energy-Based Learning and the Evolution of Hopfield Networks.」 TechRxiv、2025年4月。 techrxiv.org

