
Aprendizado Hebbiano encontra as Redes de Hopfield: a arquitetura que sempre foi mais inteligente que os Transformers
Durante a última década, os transformers e seus mecanismos de atenção dominaram o cenário da IA. Do GPT ao BERT e aos Vision Transformers, o mantra "atenção é tudo de que você precisa" mudou a forma como pensamos o aprendizado de máquina. Os sistemas tradutores, pipelines codificador-decodificador que convertem dados entre representações, tornaram-se a espinha dorsal de tudo, do processamento de linguagem à geração de imagens. Eram revolucionários. Eram poderosos.
E agora, eles estão batendo em um muro.
A ironia é que a solução existe desde 1982. Naquele ano, John Hopfield publicou um artigo nos Proceedings of the National Academy of Sciences que apresentava uma rede neural recorrente com uma propriedade que os transformers nunca alcançaram de fato: a convergência garantida para estados estáveis por meio da minimização de energia. A rede de Hopfield não apenas aprendia padrões, ela os armazenava como atratores físicos em uma paisagem de energia, recuperáveis até mesmo a partir de entradas ruidosas ou incompletas.
A comunidade de IA só agora começa a absorver o que as comunidades de física e neurociência sabem há décadas: a abordagem associativa, baseada em energia, da computação neural não é uma curiosidade histórica, é um paradigma fundamental sobre o qual a era dos transformers apenas construiu, sem entendê-lo por completo.
O teto dos Transformers
Os transformers funcionam calculando, por meio da autoatenção, as relações entre todos os elementos de uma sequência ao mesmo tempo. Isso é brilhante para a linguagem. É brilhante para dados estruturados com padrões sequenciais claros. Mas o mundo real, o mundo da robótica, dos circuitos embarcados, das decisões guiadas por sensores e da computação de borda, não se organiza em sequências arrumadinhas esperando para receber atenção.
A arquitetura transformer pressupõe abundância: computação abundante, memória abundante, energia abundante. A autoatenção cresce de forma quadrática com o tamanho da sequência. As camadas feed-forward crescem de forma linear, mas em escala massiva. Quando você implanta um sistema baseado em transformers em um robô móvel que circula por um armazém, ou o embarca em um circuito eletrônico que controla um braço de fábrica, essas premissas desmoronam.
O paradigma do tradutor traz sua própria limitação: ele trata a inteligência, antes de tudo, como um problema de conversão entre representações fixas. Codifique a entrada. Decodifique a saída. Mas a inteligência de verdade não se limita a traduzir: ela lembra, ela associa e converge para interpretações estáveis mesmo quando a entrada está degradada ou ambígua.
Temos remendado esses problemas com quantização, destilação, poda e uma centena de outros truques de otimização. Levantamentos de IA de borda em 2025 confirmam que implantar aprendizado profundo em hardware embarcado continua "limitado por restrições severas de memória, computação e energia". Mas otimizar uma arquitetura fundamentalmente inadequada só adia o acerto de contas. O que precisamos é de uma arquitetura que trate memória, estabilidade e eficiência energética como princípios de partida, e não como remendos de última hora.
Entra em cena a Rede Neural de Hopfield
Uma rede de Hopfield é uma rede neural recorrente formada por uma única camada de neurônios, na qual cada neurônio está conectado a todos os outros, exceto a si mesmo. A rede forma um grafo não direcionado completo: cada par de neurônios compartilha um peso de conexão simétrico, ou seja, a força do neurônio i para o neurônio j é idêntica à força de j para i. Não há autoconexões (wᵢᵢ = 0). Nenhuma hierarquia em camadas. Nenhum pipeline de processamento sequencial. Em vez disso, a rede inteira funciona como um único sistema dinâmico interconectado, que evolui ao longo do tempo rumo a estados de equilíbrio estáveis.
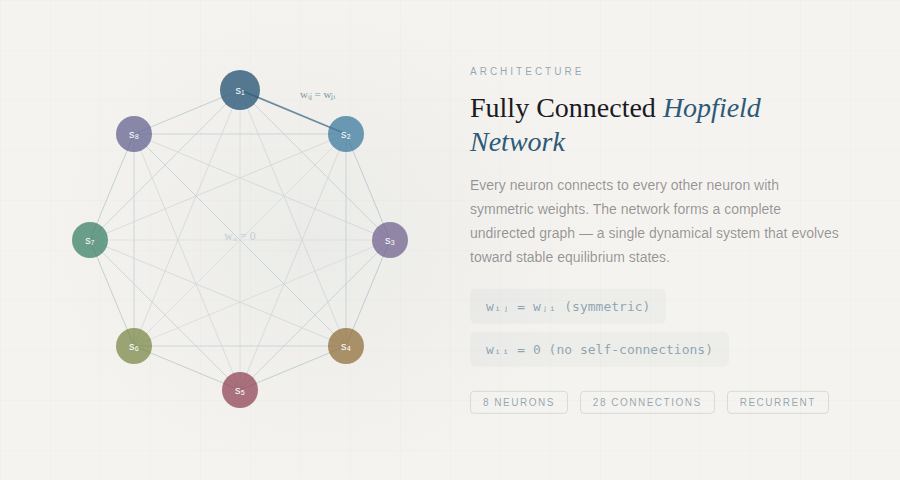
Uma rede de Hopfield com neurônios totalmente conectados. Cada nó se conecta a todos os outros por pesos simétricos (wᵢⱼ = wⱼᵢ), formando um grafo não direcionado completo. Não existem autoconexões.
A elegância dessa arquitetura está na sua função de energia. Hopfield provou que a sua rede possui uma função de energia de Lyapunov associada:
E = −½ Σᵢ Σⱼ wᵢⱼ sᵢ sⱼ − Σᵢ θᵢ sᵢ
Essa energia, garantidamente, diminui (ou permanece constante) a cada atualização de neurônio. A rede sempre converge: nunca oscila indefinidamente, nunca diverge, nunca fica presa em laços infinitos de computação. Ela se estabiliza. Bruck provou em 1990 que esse comportamento de estabilização está ligado a cortes no grafo associado: a rede executa, na prática, um algoritmo guloso para o problema do corte máximo (max-cut) a cada passo de atualização.
E é no ponto onde a rede se estabiliza que mora a inteligência. Os padrões armazenados correspondem a mínimos locais da função de energia, os vales da paisagem de energia. Quando você apresenta à rede uma versão corrompida, ruidosa ou incompleta de um padrão armazenado, a dinâmica faz o estado da rede rolar ladeira abaixo até cair no vale mais próximo: o padrão armazenado que melhor corresponde à entrada.
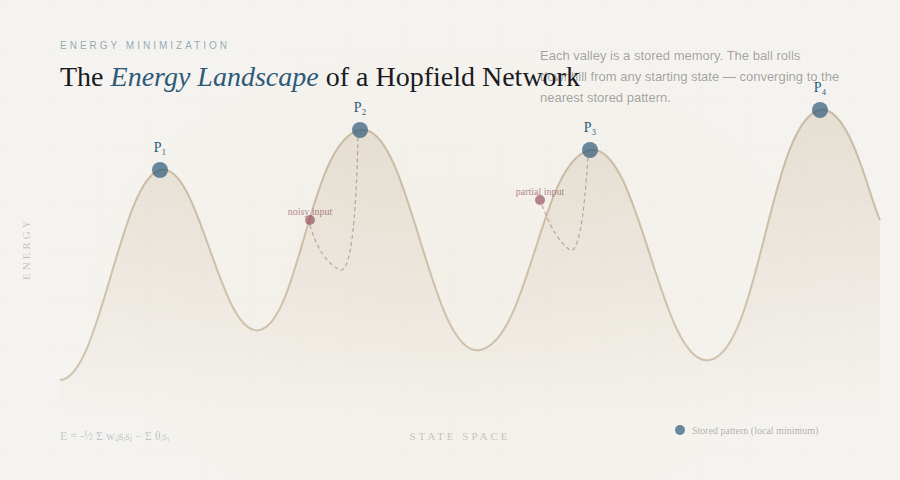
A paisagem de energia de uma rede de Hopfield. Cada vale (mínimo local) corresponde a um padrão de memória armazenado. A partir de qualquer estado inicial, a dinâmica da rede rola "ladeira abaixo" até se assentar no atrator mais próximo, recuperando o padrão completo a partir de uma entrada parcial ou ruidosa.
Isto é memória associativa endereçável por conteúdo a capacidade de recordar memórias completas a partir de pistas parciais, algo que os cérebros biológicos fazem sem esforço, mas que os transformers só conseguem aproximar por meio de computação cara.
A ligação com a física é profunda. A rede de Hopfield é matematicamente equivalente a um modelo de Ising, o mesmo arcabouço usado para descrever o magnetismo na mecânica estatística. O modelo de vidro de spin de Sherrington-Kirkpatrick, publicado em 1975, é essencialmente uma rede de Hopfield com pesos aleatórios. A sacada de Hopfield foi explorar essa propriedade de propósito, projetando a paisagem de energia de modo que cada mínimo corresponda a um padrão armazenado útil.
Aprendizado hebbiano: neurônios que disparam juntos se conectam juntos
A regra de aprendizado que faz as redes de Hopfield funcionarem tem raízes ainda mais antigas, no livro de Donald Hebb de 1949, The Organization of Behavior, que propôs o que hoje é considerado o princípio fundador da teoria do aprendizado neural.
A sacada de Hebb era enganosamente simples: quando uma célula pré-sináptica participa de forma repetida e persistente do disparo de uma célula pós-sináptica, a conexão sináptica entre elas se fortalece. "Neurônios que disparam juntos se conectam juntos", embora o próprio Hebb tenha sido mais preciso, ao enfatizar que a célula A precisa ter um papel em causar o disparo da célula B, e não apenas disparar ao mesmo tempo. Essa causalidade temporal antecipava o que hoje se conhece como plasticidade dependente do tempo dos disparos (STDP), confirmada experimentalmente décadas depois, incluindo a pesquisa pioneira de Eric Kandel com a lesma-do-mar Aplysia californica.
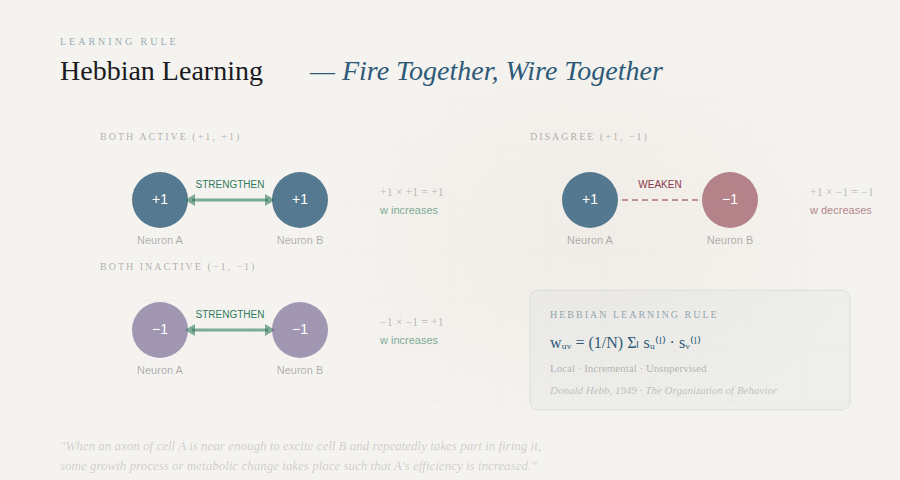
Aprendizado hebbiano: quando dois neurônios conectados estão repetidamente ativos ao mesmo tempo, a sinapse entre eles se fortalece. Esse princípio, "neurônios que disparam juntos se conectam juntos", é a base biológica de como as redes de Hopfield armazenam padrões.
Na rede de Hopfield, o aprendizado hebbiano é implementado assim:
wᵤᵥ = (1/N) Σₗ sᵤ(l) · sᵥ(l) para todos os padrões armazenados l, onde u ≠ v
Quando dois neurônios têm o mesmo estado em um determinado padrão (ambos +1 ou ambos −1), o produto deles é positivo, o que reforça a conexão excitatória. Quando divergem, o produto é negativo e cria uma conexão inibitória. O efeito acumulado esculpe uma paisagem de energia com um vale em cada padrão armazenado.
A regra hebbiana é local (cada atualização de peso usa apenas a informação disponível aos dois neurônios conectados) e incremental (novos padrões podem ser armazenados sem reprocessar os antigos). Curiosamente, é possível mostrar matematicamente que o aprendizado hebbiano realiza, sem supervisão, uma análise de componentes principais (PCA) dos dados de entrada: a rede extrai naturalmente as características estatisticamente mais significativas do seu ambiente.
Em 1997, Amos Storkey apresentou uma regra de aprendizado aprimorada que leva em conta o campo local em cada neurônio e alcança uma capacidade de armazenamento maior do que o aprendizado hebbiano padrão. Isso mostra que, mesmo dentro da mesma arquitetura, a escolha do algoritmo de aprendizado faz muita diferença, um princípio que ecoa a lição mais ampla da pesquisa em redes neurais.
A virada: "Hopfield Networks is All You Need"
Em 2020, uma equipe liderada por Hubert Ramsauer, da Universidade Johannes Kepler de Linz, publicou um artigo com um título provocador, que lembra a história de origem do transformer: "Hopfield Networks is All You Need." A contribuição deles foi a prova matemática de algo que muita gente suspeitava: o mecanismo de autoatenção dos transformers é exatamente a regra de atualização de uma rede de Hopfield contínua moderna.
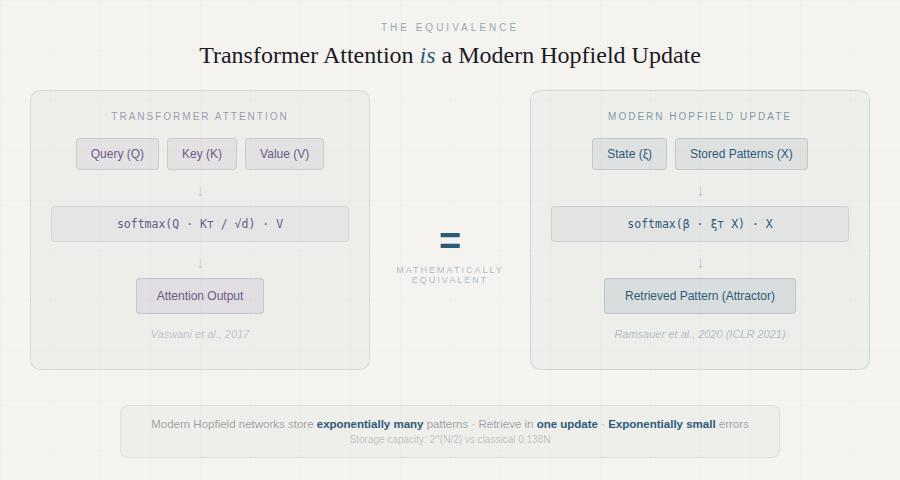
A conexão entre as redes de Hopfield modernas e a atenção do transformer. O mecanismo de atenção baseado em softmax nos transformers é matematicamente equivalente a um passo de atualização de uma rede de Hopfield contínua com função de energia exponencial. Imagem de Ramsauer et al., "Hopfield Networks is All You Need."
Não era apenas uma analogia. A equipe mostrou que, ao generalizar a função de energia clássica de Hopfield para estados contínuos e usar um termo de interação exponencial, a regra de atualização resultante passa a ser:
Z = softmax(β · R Wq Wk⊤ Y⊤) Y Wk Wv
que é precisamente a fórmula de atenção do transformer. A rede de Hopfield moderna consegue armazenar um número exponencial de padrões (em função da dimensão do espaço associativo), recuperá-los em uma única atualização e tem erros de recuperação exponencialmente pequenos.
O artigo identificou três tipos de mínimos de energia nesse arcabouço moderno: (1) um ponto fixo global que faz a média de todos os padrões armazenados, (2) estados metaestáveis que fazem a média de subconjuntos de padrões e (3) pontos fixos que armazenam padrões individuais. As cabeças de transformer das camadas inferiores tendem a operar no regime de média global, enquanto as das camadas superiores usam estados metaestáveis para reunir e processar informações, uma descoberta que oferece uma compreensão profunda de por que os transformers funcionam como funcionam.
A implicação prática foi imediata: a equipe lançou as camadas de Hopfield como módulos PyTorch plug-and-play capazes de substituir camadas de pooling, camadas GRU/LSTM e camadas de atenção padrão. Nos benchmarks, essas camadas Hopfield alcançaram resultados de ponta na classificação de repertórios imunológicos (com várias centenas de milhares de instâncias por amostra), em problemas de aprendizado de múltiplas instâncias e em benchmarks de classificação da UCI, onde os métodos tradicionais de deep learning costumam ter dificuldade.
Em dezembro de 2025, um artigo da NeurIPS de Masumura e Taki foi além e mostrou que ir para além da "aproximação adiabática" revela estados ocultos na correspondência entre Hopfield e transformers, capazes de resolver os problemas de colapso de posto (rank collapse) e de uniformidade de tokens que afetam os transformers profundos, melhorando a acurácia sem adicionar nenhum parâmetro de treinamento.
O consenso crescente: quem mais está dizendo isso?
O argumento de que as redes de Hopfield representam o próximo paradigma depois dos transformers não é especulação. Grandes instituições de pesquisa estão seguindo esse caminho ativamente, e as evidências se acumulam rápido. Aqui estão as principais vozes e os artigos que convergem para a mesma conclusão.
IBM Research e Dmitry Krotov
Em janeiro de 2025, a IBM Research publicou uma extensa entrevista com Dmitry Krotov, colaborador de longa data de Hopfield e um dos arquitetos da Dense Associative Memory. Krotov defendeu a tese de forma direta: como as redes de Hopfield espelham os circuitos de retroalimentação recorrente do cérebro, ao contrário da arquitetura feedforward de 90% dos modelos de IA atuais, elas representam "uma alternativa promissora às redes feedforward de hoje". Ele ressaltou que os transformers processam a informação em uma só direção e que, à medida que as janelas de contexto crescem, a complexidade computacional aumenta rapidamente. O cérebro, em contrapartida, usa circuitos de retroalimentação recorrente para resumir e armazenar na memória as informações passadas. As redes de Hopfield funcionam do mesmo jeito.
Krotov também descreveu o Energy Transformer (NeurIPS 2023), uma colaboração entre a IBM Research e o Georgia Tech que não se limita a aplicar as ideias de Hopfield em camadas sobre os transformers existentes: ele substitui toda a sequência de blocos transformer feedforward por um único grande modelo de Memória Associativa. O mecanismo de atenção do Energy Transformer é explicitamente diferente da atenção convencional: ele deriva de princípios fundamentais de minimização de energia, e não é um remendo colado a um pipeline feedforward.
🔗 IBM Research "Searching for brain-inspired AI algorithms" (jan. de 2025)
🔗 Energy Transformer arXiv:2302.07253 (NeurIPS 2023)
Johannes Kepler University - Grupo de Hochreiter
Sepp Hochreiter, coinventor da LSTM, liderou a equipe que publicou "Hopfield Networks is All You Need". O repositório de camadas Hopfield deles oferece módulos PyTorch prontos para produção, que servem como substitutos diretos das camadas de atenção dos transformers, das camadas de pooling e das camadas recorrentes. O post complementar no blog percorre a dedução matemática que mostra que a fórmula de atenção softmax é um caso particular da regra de atualização de Hopfield moderna e que as camadas Hopfield oferecem funcionalidades adicionais que a atenção padrão não consegue oferecer, como protótipos estáticos aprendidos e configurações flexíveis de memória associativa.
🔗 Hopfield Networks is All You Need - ICLR 2021
NeurIPS 2025: Hopfield Attention Improves GPT and Vision Transformers
A evidência mais recente vem do artigo de Masumura e Taki na NeurIPS, de dezembro de 2025. Eles mostraram que Atenção Hopfield Moderna (MHA) que adiciona estados ocultos derivados da dinâmica completa (não adiabática) de Hopfield, melhora de forma sistemática tanto os modelos de linguagem GPT-2 e LLaMA quanto os Vision Transformers. As melhorias vieram sem nenhum parâmetro adicional de treinamento. Mais importante ainda: descobriu-se que a MHA resolve o problema do colapso de posto (em que as matrizes de atenção de transformers profundos degeneram e fazem todos os tokens convergirem para representações parecidas), uma patologia fundamental que atrapalha há muito tempo os esforços de escalar transformers. Os autores concluíram: "Esperamos que esta pesquisa abra novas possibilidades para o projeto sistemático de arquiteturas Transformer usando redes de Hopfield."
🔗 On the Role of Hidden States of Modern Hopfield Network in Transformer arXiv:2511.20698 (NeurIPS 2025)
Nature Communications: aprendizado online biologicamente plausível
Em maio de 2024, a Nature Communications publicou um trabalho sobre a Sparse Quantized Hopfield Network, um modelo que aprende com regras de aprendizado locais em cenários online e contínuos, exatamente como os cérebros biológicos. Isso enfrenta uma limitação fundamental dos transformers, que exigem retropropagação não local e treinamento offline em conjuntos de dados curados. O artigo coloca as arquiteturas baseadas em Hopfield como a ponte natural entre as redes neurais artificiais e o hardware de computação neuromórfica.
🔗 A Sparse Quantized Hopfield Network for Online-Continual Memory Nature Communications (2024)
Outlier-Efficient Hopfield Layers for Large Foundation Models
Um artigo de 2024 atacou um problema prático dos grandes modelos transformer: a tendência de dar atenção a tokens pouco informativos (delimitadores, sinais de pontuação), o chamado problema dos "outliers no-op". A solução deles foi uma função de energia de Hopfield eficiente contra outliers que classifica esses tokens e os encaminha para um ponto de energia zero, impedindo que diluam a atenção útil. O modelo resultante engloba a atenção Softmax₁ como caso particular e foi validado em BERT, OPT e Vision Transformers. É a teoria de Hopfield resolvendo problemas reais de engenharia de transformers.
🔗 Outlier-Efficient Hopfield Layers for Large Transformer-Based Models (2024)
Transformers como minimizadores de energia (janeiro de 2026)
O trabalho teórico mais recente, publicado em janeiro de 2026, descreve toda a passagem direta (forward pass) do transformer como minimização intrínseca de energia, adotando por completo a perspectiva de Hopfield como o quadro explicativo de por que os transformers funcionam. O artigo liga os modelos de Hopfield modernos esparsos a toda a família de variantes de atenção (softmax, sparsemax, α-entmax) e mostra que todas são casos particulares de uma dinâmica de recuperação baseada em energia.
🔗 Transformers as Intrinsic Optimizers: Forward Inference through the Energy Principle (jan. de 2026)
Artigos de revisão e recursos da comunidade
A comunidade de pesquisa em geral está se organizando em torno dessa convergência:
- "Energy-Based Learning and the Evolution of Hopfield Networks" (TechRxiv, abril de 2025) Uma revisão abrangente que traça todo o percurso, de Hopfield (1982) às Máquinas de Boltzmann, até a reinterpretação da atenção dos transformers como dinâmica de Hopfield moderna. → Leia o artigo
- "An Energy-Based Perspective on Attention Mechanisms in Transformers" Um blog técnico aprofundado que defende que entender os transformers pela lente da energia de Hopfield "pode levar a melhorias qualitativamente diferentes, além do que é possível apenas escalando e reduzindo a complexidade computacional." → Ler o blog
- Awesome Modern Hopfield Networks Um repositório curado no GitHub que reúne mais de 50 artigos sobre redes de Hopfield modernas em diversas áreas: alocação de ativos, detecção de mudanças, reconstrução de pensamento criativo, detecção de dados fora da distribuição, classificação de repertório imunológico e muito mais. → Explorar a coleção
- "Is Hopfield Networks All You Need?" (Analytics India Magazine, dez. de 2024) Uma cobertura voltada a profissionais sobre como a equipe de Hochreiter mostrou que as redes de Hopfield são "intercambiáveis com os modelos transformer de ponta". → Ler o artigo
- "New Research in Hopfield Networks: A Short Intro" (Medium, jul. de 2024) Uma visão geral acessível que destaca como a capacidade de armazenamento passou de 0,138N para 2^(N/2) graças às funções de ativação exponenciais. → Ler no Medium
A trajetória é clara. Não se trata da proposta de um único laboratório nem da especulação de um único artigo. IBM Research, Johannes Kepler University, MIT, NeurIPS, Nature Communications e toda a comunidade de aprendizado de máquina estão convergindo para a mesma conclusão, vindos de direções diferentes: o paradigma de memória associativa baseado em energia, estabelecido por Hopfield, não é apenas a base sobre a qual os transformers foram construídos sem que se soubesse; é o arcabouço que levará a IA além do que os transformers sozinhos conseguem alcançar.
Por que isso importa agora: o argumento a favor da mudança
Convergência garantida para sistemas críticos de segurança
Os transformers produzem saídas, mas não há nenhuma garantia matemática de estabilidade. As redes de Hopfield convergem para estados estáveis por demonstração a função de energia diminui de forma monotônica. Para robótica, veículos autônomos, dispositivos médicos e qualquer sistema em que a confiabilidade seja inegociável, esse é um requisito que os transformers não conseguem oferecer.
Memória associativa como capacidade central
Se você treina uma rede de Hopfield de modo que o estado (1, −1, 1, −1, 1) seja um mínimo de energia e apresenta a entrada corrompida (1, −1, −1, −1, 1), a rede converge para o padrão correto armazenado. Ela não adivinha nem interpola ela desce a ladeira na paisagem de energia até o atrator mais próximo. Para robótica com sensores obstruídos, sistemas embarcados com dados ruidosos e qualquer aplicação que exija completar padrões a partir de uma entrada parcial, isso é transformador.
Um mecanismo universal de otimização
Hopfield e David Tank demonstraram em 1985 que as redes de Hopfield são capazes de resolver o problema do caixeiro-viajante. Se uma função de custo puder ser escrita na forma da energia de Hopfield, então os pontos de equilíbrio da rede são as soluções. Desde então, a arquitetura foi aplicada ao escalonamento de job shop, à alocação de canais em redes sem fio, à restauração de imagens, à conversão analógico-digital, ao roteamento móvel e à otimização combinatória. Um artigo de 2024 na Nature Communications apresentou uma Sparse Quantized Hopfield Network para aprendizado de memória online e contínuo com regras locais, do mesmo modo que os cérebros biológicos, uma capacidade que falta fundamentalmente aos transformers.
Hardware que pensa sem software
A restrição de pesos simétricos (wᵢⱼ = wⱼᵢ) se traduz diretamente em circuitos eletrônicos analógicos uma conexão resistiva é, por natureza, simétrica. As redes de Hopfield podem ser fabricadas como ASICs ou FPGAs, com inferência em escalas de tempo de nanossegundos. A coletânea de 2025 da Nature sobre computação neuromórfica confirma esse rumo: hardware analógico energeticamente eficiente que implementa dinâmicas neurais na borda, com memória endereçável por conteúdo que dispensa GPU, CPU e qualquer pilha de software.
Chips de IA neuromórficos e analógicos que implementam a dinâmica das redes neurais diretamente no hardware. A estrutura simétrica e baseada em energia das redes de Hopfield se encaixa naturalmente em circuitos resistivos, permitindo inferência de IA em escalas de nanossegundos, sem as pilhas de software tradicionais.
Flexibilidade binária e contínua
As redes de Hopfield clássicas usam neurônios binários (+1 ou −1); as variantes contínuas usam ativação sigmoide e equações diferenciais. As atualizações podem ser assíncronas (um neurônio por vez, o que garante a convergência) ou síncronas (todos de uma vez, o que permite paralelismo). A mesma arquitetura se adapta desde um microcontrolador com quilobytes de RAM até uma FPGA massivamente paralela e, agora, com as camadas de Hopfield modernas, até pipelines de deep learning acelerados por GPU.
Capacidade de armazenamento: a limitação honesta
A limitação clássica é clara: uma rede de N neurônios armazena de forma confiável cerca de 0,138N padrões antes que os estados espúrios comecem a prejudicar a recuperação. É uma restrição real, mas é uma restrição honesta. Os transformers não têm um limite matemático claro para o momento em que começarão a alucinar.
Além disso, as redes de Hopfield modernas (Krotov & Hopfield, 2016; Demircigil et al., 2017) alcançam capacidade de armazenamento exponencial por meio de termos de interação de ordem superior. A pesquisa continua ampliando esses limites: redes de Hopfield esparsas e estruturadas, memória de Hopfield para sequências longas e redes de Hopfield para alocação de ativos são todas áreas ativas de desenvolvimento, com artigos se acumulando em ritmo acelerado.
Implantação prática: de PCs a circuitos
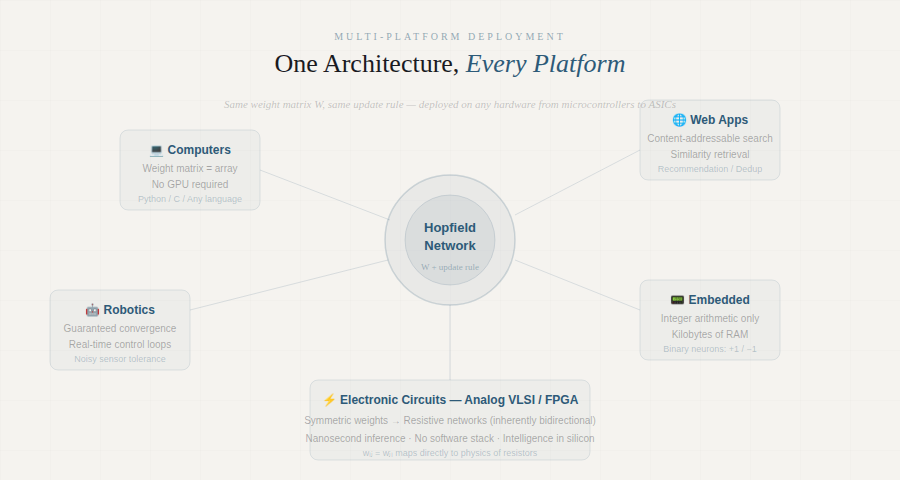
A visão original dos primeiros pesquisadores de redes neurais era clara: um framework que pudesse ser descrito uma única vez e implantado em qualquer lugar. A arquitetura de Hopfield torna isso realidade:
Aplicações de computador Uma matriz de pesos e uma regra de atualização. Sem necessidade de GPU.
Aplicações para a internet Memória endereçável por conteúdo para busca por similaridade, recomendação e deduplicação.
Robótica Convergência garantida para laços de controle em tempo real. Padrões de movimento armazenados como atratores, recuperados mesmo a partir de entradas ruidosas de sensores.
Sistemas embarcados As redes de Hopfield binárias rodam em microcontroladores usando apenas aritmética de inteiros.
Circuitos eletrônicos Pesos simétricos se traduzem em redes resistivas. Inteligência fabricada diretamente no silício.
O caminho adiante
A era dos transformers nos deu máquinas de linguagem extraordinárias. Mas a fronteira está se expandindo para o mundo físico: robôs, sensores, atuadores e decisões em tempo real. Essa fronteira exige arquiteturas estáveis, eficientes, interpretáveis e implantáveis em hardware que realmente exista na borda (edge).
A prova de 2020 de que a atenção dos transformers é uma regra de atualização de Hopfield moderna não foi apenas uma curiosidade matemática: ela revelou que usamos redes de Hopfield o tempo todo, envolvidas num framework que escondia sua verdadeira natureza. O trabalho da NeurIPS de 2025, que mostra que os estados ocultos de Hopfield resolvem patologias dos transformers, como o colapso de posto (rank collapse), sugere o próximo passo: em vez de remendar os transformers com ideias de Hopfield, construir diretamente sobre o próprio paradigma de Hopfield.
John Hopfield nos mostrou o caminho em 1982. Donald Hebb lançou as bases biológicas em 1949. A comunidade de pesquisa está convergindo para isso agora.
É hora de mudar.
Referências
- Hopfield, J.J. (1982). "Neural networks and physical systems with emergent collective computational abilities." PNAS, 79(8), 2554–2558.
- Hebb, D.O. (1949). The Organization of Behavior. Wiley.
- Ramsauer, H. et al. (2020). "Hopfield Networks is All You Need." ICLR 2021. arXiv:2008.02217
- Krotov, D. & Hopfield, J.J. (2016). "Dense Associative Memory for Pattern Recognition." NeurIPS.
- Storkey, A. (1997). "Increasing the capacity of a Hopfield network without sacrificing functionality." ICANN.
- Hoover, B., Krotov, D. et al. (2023). "Energy Transformer." NeurIPS 2023. arXiv:2302.07253
- Masumura, T. & Taki, M. (2025). "On the Role of Hidden States of Modern Hopfield Network in Transformer." NeurIPS 2025. arXiv:2511.20698
- Alonso, N. & Krichmar, J. (2024). "A sparse quantized Hopfield network for online-continual memory." Nature Communications, 15, 3722. nature.com
- Hu, J.Y. et al. (2024). "Outlier-Efficient Hopfield Layers for Large Transformer-Based Models." arXiv:2404.03828
- Hu, J.Y. et al. (2026). "Transformers as Intrinsic Optimizers: Forward Inference through the Energy Principle." arXiv:2511.00907
- Hopfield, J.J. & Tank, D.W. (1985). "'Neural' Computation of Decisions in Optimization Problems." Biological Cybernetics, 52, 141–152.
- Bruck, J. (1990). "On the convergence properties of the Hopfield model." Proceedings of the IEEE.
- Krotov, D. (2025). "Searching for brain-inspired AI algorithms." IBM Research Blog. research.ibm.com
- "Energy-Based Learning and the Evolution of Hopfield Networks." TechRxiv, abril de 2025. techrxiv.org

