
Învățarea hebbiană întâlnește rețelele Hopfield: arhitectura care a fost dintotdeauna mai inteligentă decât transformerele
În ultimul deceniu, transformerele și mecanismele lor de atenție au dominat peisajul IA. De la GPT la BERT și la Vision Transformers, mantra „attention is all you need” a schimbat felul în care gândim învățarea automată. Sistemele de tip translator, adică fluxurile encoder-decoder care convertesc datele dintr-o reprezentare în alta, au devenit coloana vertebrală a tot ce înseamnă procesare a limbajului sau generare de imagini. Au fost revoluționare. Au fost puternice.
Iar acum se lovesc de un zid.
Ironia este că soluția există încă din 1982. În acel an, John Hopfield a publicat în Proceedings of the National Academy of Sciences o lucrare care introducea o rețea neuronală recurentă cu o proprietate pe care transformerele nu au atins-o cu adevărat niciodată: convergența garantată către stări stabile prin minimizarea energiei. Rețeaua Hopfield nu doar învăța tipare, ci le stoca drept atractori fizici într-un peisaj energetic, de unde puteau fi regăsite chiar și pornind de la date zgomotoase sau incomplete.
Comunitatea IA abia acum începe să înțeleagă ceea ce comunitățile de fizică și neuroștiințe știu de zeci de ani: abordarea asociativă, bazată pe energie, a calculului neuronal nu este o curiozitate istorică, ci o paradigmă fundamentală, pe care epoca transformerelor doar a construit-o mai departe, fără să o înțeleagă pe deplin.
Plafonul transformerelor
Transformerele funcționează calculând simultan relațiile dintre fiecare element al unei secvențe, prin auto-atenție. Pentru limbaj, este genial. Este genial și pentru datele structurate, cu tipare secvențiale clare. Dar lumea reală, cea a roboticii, a circuitelor integrate, a deciziilor bazate pe senzori și a calculului la margine (edge computing), nu se organizează în secvențe ordonate care așteaptă să fie „atenționate”.
Arhitectura transformer presupune abundență: putere de calcul din belșug, memorie din belșug, energie din belșug. Auto-atenția scalează pătratic cu lungimea secvenței. Straturile feed-forward cresc liniar, dar masiv. Când implementezi un sistem bazat pe transformer pe un robot mobil care se mișcă printr-un depozit sau îl integrezi într-un circuit electronic care comandă un braț de fabricație, aceste presupuneri se prăbușesc.
Paradigma translatorului vine și cu propria limită: tratează inteligența mai ales ca pe o problemă de conversie între reprezentări fixe. Codifici intrarea. Decodifici ieșirea. Dar inteligența adevărată nu doar traduce: ea își amintește, asociază și converge către interpretări stabile chiar și atunci când intrarea este degradată sau ambiguă.
Am tot petecit aceste probleme cu cuantizare, distilare, tăiere (pruning) și încă o sută de alte trucuri de optimizare. Studiile despre IA la margine din 2025 confirmă că implementarea învățării profunde pe hardware încorporat rămâne „limitată de constrângeri stricte de memorie, calcul și energie”. Dar optimizarea unei arhitecturi fundamental nepotrivite doar amână ziua socotelilor. Avem nevoie de o arhitectură care tratează memoria, stabilitatea și eficiența energetică drept principii de bază, nu drept gânduri de după.
Intră în scenă rețeaua neuronală Hopfield
O rețea Hopfield este o rețea neuronală recurentă formată dintr-un singur strat de neuroni, în care fiecare neuron este conectat cu toți ceilalți, mai puțin cu el însuși. Rețeaua formează un graf neorientat complet: fiecare pereche de neuroni împarte o pondere de conexiune simetrică, ceea ce înseamnă că intensitatea de la neuronul i la neuronul j este identică cu intensitatea de la j la i. Nu există auto-conexiuni (wᵢᵢ = 0). Nu există o ierarhie pe straturi. Nu există o conductă de procesare secvențială. În schimb, întreaga rețea funcționează ca un singur sistem dinamic interconectat, care evoluează în timp spre stări de echilibru stabile.
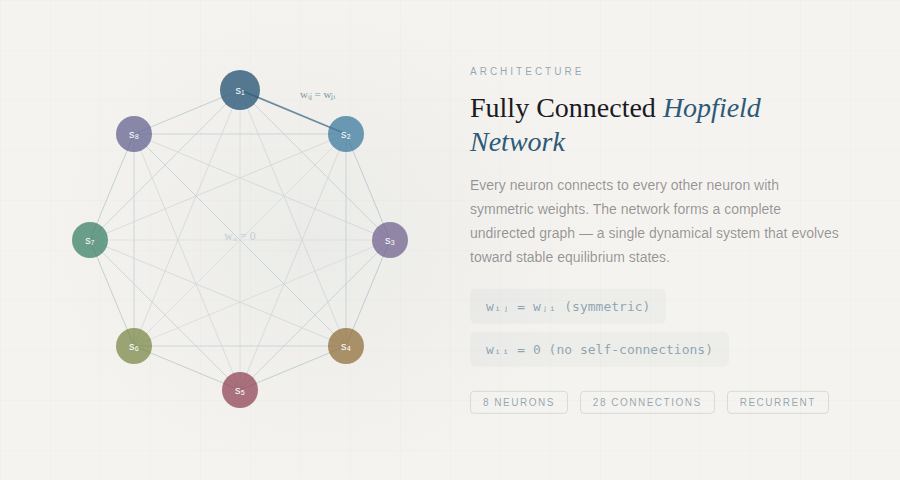
O rețea Hopfield cu neuroni complet conectați. Fiecare nod se leagă de toate celelalte prin ponderi simetrice (wᵢⱼ = wⱼᵢ), formând un graf neorientat complet. Nu există auto-conexiuni.
Eleganța acestei arhitecturi stă în funcția de energie. Hopfield a demonstrat că rețeaua sa are asociată o funcție de energie Lyapunov:
E = −½ Σᵢ Σⱼ wᵢⱼ sᵢ sⱼ − Σᵢ θᵢ sᵢ
Energia este garantat să scadă (sau să rămână constantă) la fiecare actualizare a unui neuron. Rețeaua converge întotdeauna: nu oscilează la nesfârșit, nu diverge, nu rămâne prinsă în bucle de calcul infinite. Se așază. Bruck a demonstrat în 1990 că acest comportament de stabilizare este legat de tăieturile din graful asociat: la fiecare pas de actualizare, rețeaua execută în esență un algoritm greedy pentru problema tăieturii maxime (max-cut).
Iar inteligența se află chiar acolo unde se așază rețeaua. Tiparele memorate corespund unor minime locale ale funcției de energie, adică văilor din peisajul energetic. Când îi prezinți rețelei o versiune alterată, zgomotoasă sau incompletă a unui tipar memorat, dinamica rostogolește starea rețelei la vale, până când aceasta cade în cea mai apropiată vale: tiparul memorat care se potrivește cel mai bine cu intrarea.
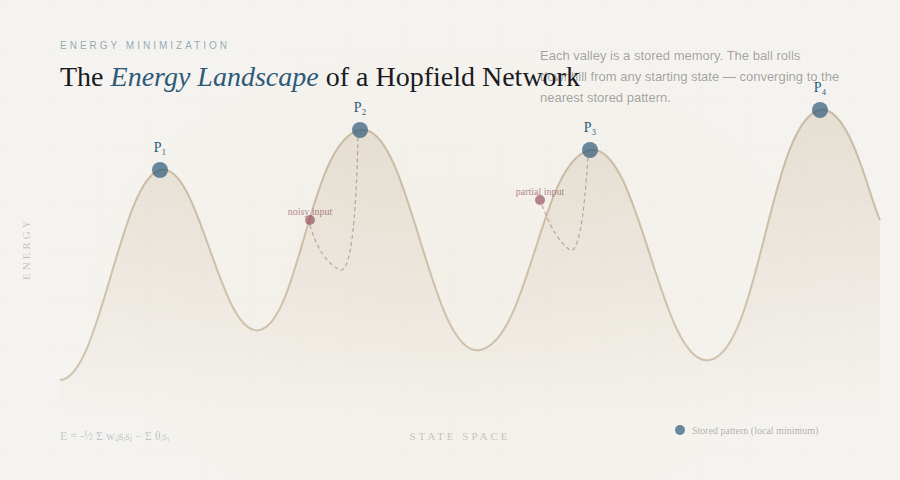
Peisajul energetic al unei rețele Hopfield. Fiecare vale (minim local) corespunde unui tipar de memorie stocat. Pornind din orice stare inițială, dinamica rețelei se rostogolește „la vale” până se așază în cel mai apropiat atractor, recuperând tiparul complet din date parțiale sau afectate de zgomot.
Aceasta este memoria asociativă adresabilă prin conținut capacitatea de a readuce amintiri întregi pornind de la indicii parțiale, ceva ce creierele biologice fac fără efort, dar pe care transformerele îl pot doar aproxima printr-un calcul costisitor.
Legătura cu fizica merge adânc. Rețeaua Hopfield este echivalentă matematic cu un model Ising, același cadru folosit pentru a descrie magnetismul în mecanica statistică. Modelul Sherrington-Kirkpatrick de sticlă de spin, publicat în 1975, este în esență o rețea Hopfield cu ponderi aleatorii. Intuiția lui Hopfield a fost să exploateze această proprietate în mod deliberat, modelând peisajul energetic astfel încât fiecare minim să corespundă unui tipar util stocat.
Învățarea hebbiană: neuronii care se activează împreună se conectează împreună
Regula de învățare care face ca rețelele Hopfield să funcționeze are rădăcini și mai vechi, în cartea lui Donald Hebb din 1949, The Organization of Behavior, care a formulat ceea ce este considerat astăzi principiul fondator al teoriei învățării neuronale.
Ideea lui Hebb era înșelător de simplă: atunci când o celulă presinaptică participă în mod repetat și persistent la activarea unei celule postsinaptice, conexiunea sinaptică dintre ele se întărește. „Neuronii care se activează împreună se conectează împreună”, deși Hebb însuși a fost mai precis, subliniind că celula A trebuie să participe la provocarea activării celulei B, nu doar să se activeze în același timp. Această cauzalitate temporală anunța ceea ce numim astăzi plasticitate dependentă de momentul impulsurilor (STDP), confirmată experimental decenii mai târziu, inclusiv prin cercetările revoluționare ale lui Eric Kandel asupra melcului de mare Aplysia californica.
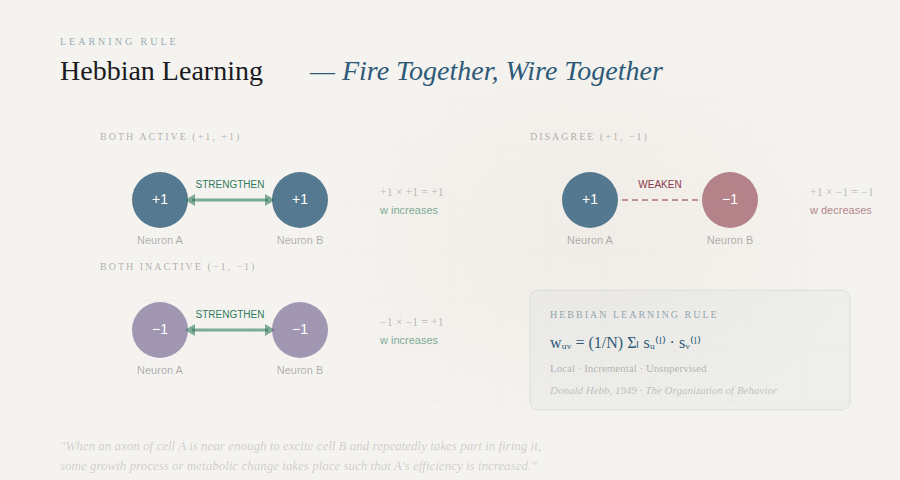
Învățarea hebbiană: atunci când doi neuroni conectați sunt activi împreună în mod repetat, sinapsa dintre ei se întărește. Acest principiu, „neuronii care se activează împreună se conectează împreună”, este temelia biologică a modului în care rețelele Hopfield stochează tiparele.
În rețeaua Hopfield, învățarea hebbiană se implementează astfel:
wᵤᵥ = (1/N) Σₗ sᵤ(l) · sᵥ(l) pentru toate tiparele stocate l, unde u ≠ v
Când doi neuroni au aceeași stare într-un anumit tipar (amândoi +1 sau amândoi −1), produsul lor este pozitiv și întărește conexiunea excitatoare. Când nu sunt de acord, produsul este negativ și creează o conexiune inhibitoare. Efectul cumulat modelează un peisaj energetic cu o vale în dreptul fiecărui tipar stocat.
Regula hebbiană este locală (fiecare actualizare a unei ponderi folosește doar informația disponibilă celor doi neuroni conectați) și incrementală (tipare noi pot fi stocate fără a le reprocesa pe cele vechi). În mod remarcabil, se poate demonstra matematic că învățarea hebbiană realizează o analiză a componentelor principale (PCA) nesupervizată a datelor de intrare: rețeaua extrage în mod firesc cele mai semnificative trăsături statistice din mediul ei.
În 1997, Amos Storkey a introdus o regulă de învățare îmbunătățită, care ia în calcul câmpul local de la fiecare neuron și atinge o capacitate de stocare mai mare decât învățarea hebbiană standard. Aceasta arată că, chiar și în aceeași arhitectură, alegerea algoritmului de învățare contează profund, un principiu care se potrivește cu lecția mai largă a cercetării în domeniul rețelelor neuronale.
Descoperirea: „Hopfield Networks is All You Need”
În 2020, o echipă condusă de Hubert Ramsauer la Universitatea Johannes Kepler din Linz a publicat o lucrare cu un titlu provocator, ecou al poveștii de origine a transformerului: „Hopfield Networks is All You Need”. Contribuția lor a fost demonstrația matematică a ceea ce mulți bănuiau: mecanismul de autoatenție din transformere este exact regula de actualizare a unei rețele Hopfield continue moderne.
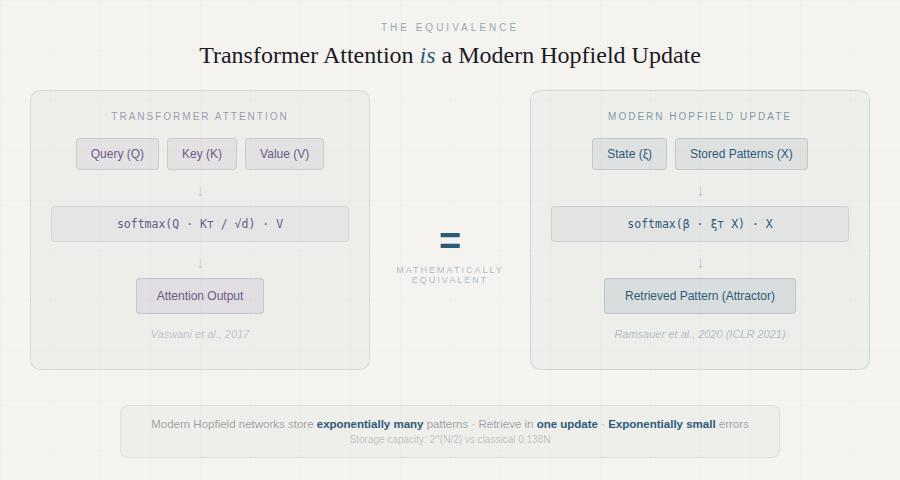
Legătura dintre rețelele Hopfield moderne și atenția din transformere. Mecanismul de atenție bazat pe softmax din transformere este matematic echivalent cu un pas de actualizare al unei rețele Hopfield continue cu funcție de energie exponențială. Imagine din Ramsauer et al., „Hopfield Networks is All You Need”.
Nu a fost doar o analogie. Echipa a arătat că, prin generalizarea funcției de energie Hopfield clasice la stări continue și folosind un termen de interacțiune exponențial, regula de actualizare rezultată devine:
Z = softmax(β · R Wq Wk⊤ Y⊤) Y Wk Wv
adică exact formula atenției din transformere. Rețeaua Hopfield modernă poate stoca un număr exponențial de tipare (în funcție de dimensiunea spațiului asociativ), le regăsește dintr-un singur pas de actualizare și are erori de regăsire exponențial de mici.
Lucrarea a identificat trei tipuri de minime de energie în acest cadru modern: (1) un punct fix global, care face media tuturor tiparelor stocate, (2) stări metastabile, care fac media unor submulțimi de tipare, și (3) puncte fixe care stochează câte un singur tipar. Capetele transformerului din straturile inferioare tind să funcționeze în regimul de mediere globală, în timp ce capetele din straturile superioare folosesc stări metastabile pentru a aduna și a procesa informația, o constatare care oferă o perspectivă profundă asupra motivului pentru care transformerele funcționează așa cum funcționează.
Implicația practică a fost imediată: echipa a lansat straturile Hopfieldca module PyTorch drop-in care pot înlocui straturile de pooling, straturile GRU/LSTM și straturile standard de atenție. În benchmark-uri, aceste straturi Hopfield au obținut rezultate de ultimă generație la clasificarea repertoriului imunitar (cu câteva sute de mii de instanțe pe eșantion), la problemele de multiple instance learning și la benchmark-urile de clasificare UCI, unde metodele clasice de deep learning se chinuie de obicei.
Până în decembrie 2025, o lucrare NeurIPS semnată de Masumura și Taki a mers mai departe, arătând că dacă depășim „aproximația adiabatică”, apar stări ascunse în corespondența dintre rețelele Hopfield și transformere, care pot rezolva problemele de colaps al rangului și de uniformitate a token-urilor ce afectează transformerele profunde, îmbunătățind acuratețea fără a adăuga niciun parametru de antrenare.
Consensul tot mai larg: cine mai spune asta?
Ideea că rețelele Hopfield sunt următoarea paradigmă după transformere nu este o speculație. Instituții de cercetare importante o urmăresc activ, iar dovezile se strâng rapid. Iată vocile și lucrările cheie care ajung la aceeași concluzie.
IBM Research și Dmitry Krotov
În ianuarie 2025, IBM Research a publicat un interviu amplu cu Dmitry Krotov, colaboratorul de multă vreme al lui Hopfield și unul dintre arhitecții Dense Associative Memory. Krotov a spus-o direct: întrucât rețelele Hopfield reproduc buclele de feedback recurent ale creierului, spre deosebire de arhitectura feedforward a 90% dintre modelele AI actuale, ele reprezintă „o alternativă promițătoare la rețelele feedforward de astăzi”. El a subliniat că transformerele procesează informația într-o singură direcție, iar pe măsură ce ferestrele de context cresc, complexitatea computațională crește rapid. Creierul, în schimb, folosește bucle de feedback recurent pentru a rezuma și a stoca în memorie informațiile trecute. Rețelele Hopfield funcționează la fel.
Krotov a descris și Energy Transformer (NeurIPS 2023), o colaborare între IBM Research și Georgia Tech care nu se limitează să adauge idei Hopfield peste transformerele existente, ci înlocuiește întreaga succesiune de blocuri transformer feedforward cu un singur model mare de memorie asociativă. Mecanismul de atenție din Energy Transformer este explicit diferit de atenția convențională: derivă din principiile de bază ale minimizării energiei, nu este lipit peste o conductă feedforward.
🔗 IBM Research „Searching for brain-inspired AI algorithms” (ian. 2025)
🔗 Energy Transformer arXiv:2302.07253 (NeurIPS 2023)
Johannes Kepler University - grupul lui Hochreiter
Sepp Hochreiter, coinventator al LSTM, a condus echipa care a publicat „Hopfield Networks is All You Need”. Depozitul Hopfield layers oferă module PyTorch gata de producție, care pot înlocui direct straturile de atenție ale transformerelor, straturile de pooling și straturile recurente. Articolul de blog însoțitor parcurge derivarea matematică ce arată că formula atenției softmax este un caz particular al regulii moderne de actualizare Hopfield și că straturile Hopfield oferă funcționalități suplimentare pe care atenția standard nu le poate oferi, inclusiv prototipuri statice învățate și configurații flexibile de memorie asociativă.
🔗 Hopfield Networks is All You Need - ICLR 2021
NeurIPS 2025: Hopfield Attention Improves GPT and Vision Transformers
Cea mai recentă dovadă vine din lucrarea NeurIPS din decembrie 2025 a lui Masumura și Taki. Ei au arătat că Modern Hopfield Attention (MHA) care adaugă stări ascunse derivate din dinamica Hopfield completă (non-adiabatică), îmbunătățește sistematic atât modelele de limbaj GPT-2 și LLaMA, cât și Vision Transformers. Îmbunătățirile au venit fără niciun parametru suplimentar de antrenare. Mai important, s-a constatat că MHA rezolvă problema colapsului rangului (în care matricele de atenție din transformerele adânci degenerează, iar toate tokenurile converg către reprezentări similare), o patologie fundamentală care a încurcat constant eforturile de scalare a transformerelor. Autorii au concluzionat: „Sperăm că această cercetare va deschide noi posibilități pentru proiectarea sistematică a arhitecturilor Transformer folosind rețele Hopfield.”
🔗 On the Role of Hidden States of Modern Hopfield Network in Transformer arXiv:2511.20698 (NeurIPS 2025)
Nature Communications: învățare online plauzibilă biologic
În mai 2024, Nature Communications a publicat o lucrare despre Sparse Quantized Hopfield Network, un model care învață folosind reguli de învățare locale în scenarii online-continue, exact așa cum fac creierele biologice. Aceasta abordează o limitare fundamentală a transformerelor, care necesită backpropagation non-local și antrenare offline pe seturi de date atent selectate. Lucrarea prezintă arhitecturile bazate pe Hopfield drept puntea firească dintre rețelele neuronale artificiale și hardware-ul de calcul neuromorfic.
🔗 A Sparse Quantized Hopfield Network for Online-Continual Memory Nature Communications (2024)
Straturi Hopfield eficiente în fața valorilor aberante pentru modele de fundație mari
O lucrare din 2024 a abordat o problemă practică a modelelor transformer mari: tendința de a aloca atenție unor tokenuri lipsite de informație (delimitatori, semne de punctuație), așa-numita problemă a valorilor aberante „no-op”. Soluția lor a fost o funcție de energie Hopfield eficientă în fața valorilor aberante care clasifică aceste tokenuri și le direcționează către un punct de energie zero, împiedicându-le să dilueze atenția utilă. Modelul rezultat include atenția Softmax₁ ca un caz particular și a fost validat pe BERT, OPT și Vision Transformers. Este teoria Hopfield care rezolvă probleme reale de inginerie a transformerelor.
🔗 Outlier-Efficient Hopfield Layers for Large Transformer-Based Models (2024)
Transformerele ca minimizatori de energie (ianuarie 2026)
Cea mai recentă lucrare teoretică, publicată în ianuarie 2026, descrie întregul pas înainte al unui transformer ca minimizare intrinsecă a energiei, adoptând pe deplin perspectiva Hopfield drept cadru explicativ pentru motivul pentru care transformerele funcționează. Lucrarea leagă modelele Hopfield moderne rare de întreaga familie de variante de atenție (softmax, sparsemax, α-entmax), arătând că toate sunt cazuri particulare ale dinamicii de regăsire bazate pe energie.
🔗 Transformers as Intrinsic Optimizers: Forward Inference through the Energy Principle (ian. 2026)
Lucrări de sinteză și resurse comunitare
Comunitatea de cercetare mai largă se organizează în jurul acestei convergențe:
- „Energy-Based Learning and the Evolution of Hopfield Networks” (TechRxiv, aprilie 2025) O sinteză cuprinzătoare care urmărește întreg parcursul, de la Hopfield (1982) prin mașinile Boltzmann până la reinterpretarea atenției din transformere ca dinamică Hopfield modernă. → Citește lucrarea
- „An Energy-Based Perspective on Attention Mechanisms in Transformers” Un blog tehnic aprofundat, care susține că înțelegerea transformerelor prin prisma energiei Hopfield „ar putea duce la îmbunătățiri calitativ diferite, dincolo de ceea ce este posibil bazându-ne doar pe scalare și pe reducerea complexității de calcul.” → Citește blogul
- Awesome Modern Hopfield Networks Un depozit GitHub atent selecționat, care urmărește peste 50 de lucrări despre rețelele Hopfield moderne din domenii variate: alocarea activelor, detectarea schimbărilor, reconstrucția gândirii creative, detectarea datelor în afara distribuției, clasificarea repertoriului imunitar și multe altele. → Răsfoiește colecția
- „Is Hopfield Networks All You Need?” (Analytics India Magazine, dec. 2024) O prezentare orientată spre practicieni a felului în care echipa lui Hochreiter a arătat că rețelele Hopfield sunt „interschimbabile cu modelele transformer de ultimă generație”. → Citește articolul
- „New Research in Hopfield Networks: A Short Intro” (Medium, iulie 2024) O privire de ansamblu accesibilă, care arată că'capacitatea de stocare a crescut de la 0,138N la 2^(N/2) datorită funcțiilor de activare exponențiale. → Citește pe Medium
Direcția este limpede. Nu e propunerea unui singur laborator și nici speculația unei singure lucrări. IBM Research, Universitatea Johannes Kepler, MIT, NeurIPS, Nature Communications și comunitatea mai largă de machine learning ajung, din direcții diferite, la aceeași concluzie: paradigma memoriei asociative, bazată pe energie, pe care a stabilit-o Hopfield, nu este doar temelia pe care transformerele au fost construite fără ca cineva să știe, ci și cadrul care va duce AI-ul dincolo de ceea ce pot realiza singure transformerele.
De ce contează acum: argumentele pentru schimbare
Convergență garantată pentru sistemele critice pentru siguranță
Transformerele produc rezultate, dar nu există nicio garanție matematică de stabilitate. Rețelele Hopfield converg spre stări stabile, iar aceasta este demonstrată funcția de energie scade monoton. Pentru robotică, vehicule autonome, dispozitive medicale și orice sistem în care fiabilitatea nu se negociază, aceasta este o cerință pe care transformerele nu o pot îndeplini.
Memoria asociativă, capacitatea de bază
Dacă antrenezi o rețea Hopfield astfel încât starea (1, −1, 1, −1, 1) să fie un minim de energie și îi prezinți intrarea coruptă (1, −1, −1, −1, 1), rețeaua converge spre modelul corect memorat. Nu ghicește și nu interpolează, ci se rostogolește la vale pe peisajul energetic, spre cel mai apropiat atractor. Pentru robotica cu senzori obturați, sistemele embedded cu date zgomotoase și orice aplicație care cere completarea unui tipar pornind de la o intrare parțială, este o schimbare radicală.
Un motor universal de optimizare
În 1985, Hopfield și David Tank au demonstrat că rețelele Hopfield pot rezolva problema comis-voiajorului. Dacă o funcție de cost poate fi scrisă sub forma energiei Hopfield, atunci punctele de echilibru ale rețelei sunt soluțiile. De atunci, arhitectura a fost aplicată în planificarea producției de tip job-shop, alocarea canalelor în rețelele wireless, restaurarea imaginilor, conversia analog-digitală, rutarea mobilă și optimizarea combinatorie. O lucrare din 2024 din Nature Communications a introdus o Sparse Quantized Hopfield Network pentru învățarea online-continuă a memoriei, cu reguli locale, în același fel ca creierele biologice, o capacitate care le lipsește fundamental transformerelor.
Hardware care gândește fără software
Constrângerea simetriei ponderilor (wᵢⱼ = wⱼᵢ) se transpune direct în circuite electronice analogice, deoarece o conexiune rezistivă este simetrică prin natura ei. Rețelele Hopfield pot fi fabricate ca ASIC-uri sau FPGA-uri, cu inferență la scară de nanosecunde. Colecția Nature din 2025 despre calculul neuromorfic confirmă această direcție: hardware analogic eficient energetic, care implementează dinamici neuronale la margine (edge), cu memorie adresabilă prin conținut, fără GPU, fără CPU și fără stivă software.
Cipuri AI neuromorfice și analogice care implementează dinamica rețelelor neuronale direct în hardware. Structura simetrică, bazată pe energie, a rețelelor Hopfield se potrivește firesc circuitelor rezistive și permite inferență AI la scări de timp de nanosecunde, fără stive software tradiționale.
Flexibilitate binară și continuă
Rețelele Hopfield clasice folosesc neuroni binari (+1 sau −1); variantele continue folosesc activare sigmoidală și ecuații diferențiale. Actualizările pot fi asincrone (un neuron pe rând, ceea ce garantează convergența) sau sincrone (toți odată, ceea ce permite paralelismul). Aceeași arhitectură se adaptează de la un microcontroler cu câțiva kiloocteți de RAM până la un FPGA masiv paralel și, acum, cu straturile Hopfield moderne, până la fluxurile de deep learning accelerate pe GPU.
Capacitatea de stocare: limita sinceră
Limitarea clasică este clară: o rețea de N neuroni stochează fiabil aproximativ 0.138N tipare înainte ca stările false să degradeze regăsirea. Este o limită reală, dar una sinceră. Transformerele nu au o limită matematică clară care să arate când vor începe să halucineze.
Mai mult, rețelele Hopfield moderne (Krotov & Hopfield, 2016; Demircigil et al., 2017) ating o capacitate de stocare exponențială prin termeni de interacțiune de ordin superior. Cercetarea continuă să extindă aceste granițe: rețelele Hopfield rare și structurate, memoria Hopfield pentru secvențe lungi și rețelele Hopfield pentru alocarea activelor sunt toate domenii active de dezvoltare, cu lucrări care se acumulează rapid.
Implementare practică: de la PC-uri la circuite
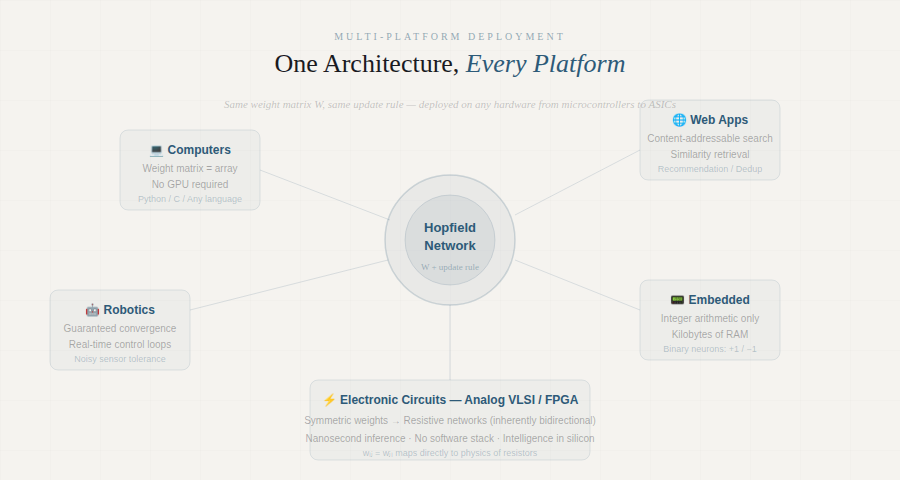
Viziunea inițială a primilor cercetători în domeniul rețelelor neuronale era clară: un cadru care poate fi descris o singură dată și implementat oriunde. Arhitectura lui Hopfield face asta realitate:
Aplicații pentru computer O matrice de ponderi și o regulă de actualizare. Fără GPU.
Aplicații web Memorie adresabilă prin conținut pentru căutare de similaritate, recomandări și deduplicare.
Robotică Convergență garantată pentru buclele de control în timp real. Tiparele de mișcare sunt stocate ca atractori și regăsite chiar și din semnale zgomotoase ale senzorilor.
Sisteme embedded Rețelele Hopfield binare rulează pe microcontrolere doar cu aritmetică pe numere întregi.
Circuite electronice Ponderile simetrice se traduc în rețele rezistive. Inteligență construită direct în siliciu.
Drumul înainte
Era transformerelor ne-a dat mașini de limbaj extraordinare. Dar frontiera se extinde spre lumea fizică: roboți, senzori, actuatori și decizii în timp real. Această frontieră cere arhitecturi stabile, eficiente, interpretabile și care pot fi implementate pe hardware-ul care există de fapt la margine (edge).
Demonstrația din 2020 că atenția din transformere este o regulă modernă de actualizare Hopfield nu a fost doar o curiozitate matematică. A arătat că am folosit rețele Hopfield de la bun început, învelite într-un cadru care le ascundea adevărata natură. Lucrarea NeurIPS din 2025, care arată că stările ascunse Hopfield rezolvă patologii ale transformerelor precum colapsul rangului, sugerează următorul pas: nu să peticim transformerele cu idei din Hopfield, ci să construim direct pe paradigma Hopfield însăși.
John Hopfield ne-a arătat drumul în 1982. Donald Hebb a pus bazele biologice în 1949. Comunitatea de cercetare converge acum spre el.
A venit momentul să facem trecerea.
Referințe
- Hopfield, J.J. (1982). "Neural networks and physical systems with emergent collective computational abilities." PNAS, 79(8), 2554–2558.
- Hebb, D.O. (1949). The Organization of Behavior․ Wiley.
- Ramsauer, H. et al. (2020). "Hopfield Networks is All You Need." ICLR 2021. arXiv:2008.02217
- Krotov, D. & Hopfield, J.J. (2016). "Dense Associative Memory for Pattern Recognition." NeurIPS.
- Storkey, A. (1997). "Increasing the capacity of a Hopfield network without sacrificing functionality." ICANN.
- Hoover, B., Krotov, D. et al. (2023). "Energy Transformer." NeurIPS 2023. arXiv:2302.07253
- Masumura, T. & Taki, M. (2025). "On the Role of Hidden States of Modern Hopfield Network in Transformer." NeurIPS 2025. arXiv:2511.20698
- Alonso, N. & Krichmar, J. (2024). "A sparse quantized Hopfield network for online-continual memory." Nature Communications, 15, 3722. nature.com
- Hu, J.Y. et al. (2024). "Outlier-Efficient Hopfield Layers for Large Transformer-Based Models." arXiv:2404.03828
- Hu, J.Y. et al. (2026). "Transformers as Intrinsic Optimizers: Forward Inference through the Energy Principle." arXiv:2511.00907
- Hopfield, J.J. & Tank, D.W. (1985). "'Neural' Computation of Decisions in Optimization Problems." Biological Cybernetics, 52, 141–152.
- Bruck, J. (1990). "On the convergence properties of the Hopfield model." Proceedings of the IEEE.
- Krotov, D. (2025). "Searching for brain-inspired AI algorithms." IBM Research Blog. research.ibm.com
- "Energy-Based Learning and the Evolution of Hopfield Networks." TechRxiv, aprilie 2025. techrxiv.org

