
Mafunzo ya Hebbian Yakutana na Mitandao ya Hopfield: Usanifu Ambao Siku Zote Ulikuwa Mahiri Kuliko Transformers
Kwa muongo mmoja uliopita, transformers na mifumo yake ya usikivu (attention) vimetawala ulimwengu wa AI. Kuanzia GPT hadi BERT hadi Vision Transformers, kauli mbiu ya "attention is all you need" ilibadilisha namna tunavyofikiri kuhusu ujifunzaji wa mashine. Mifumo ya tafsiri, yaani mifumo ya kisimbaji na kisimbuaji inayogeuza data kati ya uwakilishi mbalimbali, ikawa uti wa mgongo wa kila kitu, kuanzia usindikaji wa lugha hadi uzalishaji wa picha. Ilikuwa ya kimapinduzi. Ilikuwa na nguvu.
Na sasa, inagonga ukuta.
Kinachoshangaza ni kwamba suluhisho limekuwepo tangu mwaka 1982. Mwaka huo, John Hopfield alichapisha makala katika Proceedings of the National Academy of Sciences iliyoleta mtandao wa neva unaojirudia wenye sifa ambayo transformers hazijawahi kuifikia kikweli: uhakika wa kufikia hali tulivu kupitia upunguzaji wa nishati. Mtandao wa Hopfield haukujifunza mifumo tu; uliihifadhi kama vivutio vya kimwili katika mandhari ya nishati, vinavyoweza kurejeshwa hata kutoka kwa pembejeo zenye kelele au zisizokamilika.
Jumuiya ya AI ndiyo kwanza inaanza kuelewa kwa kina kile ambacho jumuiya za fizikia na sayansi ya neva zimekijua kwa miongo kadhaa: mtazamo wa kuhusisha na unaotegemea nishati katika ukokotoaji wa neva si udadisi wa kihistoria tu; ni dhana ya msingi ambayo enzi ya transformers imejengea juu yake bila kuielewa kikamilifu.
Kikomo cha Transformers
Transformers hufanya kazi kwa kukokotoa mahusiano kati ya kila kipengele katika mfuatano kwa wakati mmoja kupitia usikivu binafsi (self-attention). Hii ni bora kwa lugha. Ni bora kwa data iliyopangwa yenye mifumo dhahiri ya mfuatano. Lakini ulimwengu halisi, ulimwengu wa roboti, saketi zilizopachikwa, maamuzi yanayoendeshwa na vihisi, na ukokotoaji wa pembezoni (edge computing), haujipangi katika mfuatano nadhifu unaosubiri kusikilizwa.
Usanifu wa transformer unadhania wingi: wingi wa nguvu za ukokotoaji, wingi wa kumbukumbu, wingi wa umeme. Usikivu binafsi hukua kwa kiwango cha pili cha urefu wa mfuatano. Tabaka za feed-forward hukua kwa mstari lakini kwa ukubwa mkubwa. Unapoweka mfumo unaotegemea transformer kwenye roboti ya mkononi inayopita ghalani, au kuupachika kwenye saketi ya kielektroniki inayodhibiti mkono wa kiwandani, dhana hizo huporomoka.
Mtazamo wa mfumo wa tafsiri nao una kikomo chake: unachukulia akili kuwa hasa tatizo la kugeuza kati ya uwakilishi usiobadilika. Simba pembejeo. Simbua matokeo. Lakini akili halisi haitafsiri tu; hukumbuka, huhusisha, na hufikia tafsiri tulivu hata pale pembejeo inapoharibika au kuwa na utata.
Tumekuwa tukiziba matatizo haya kwa quantization, distillation, pruning, na mbinu mamia ya uboreshaji mwingine. Tafiti za Edge AI za mwaka 2025 zinathibitisha kwamba kuweka ujifunzaji wa kina kwenye vifaa vilivyopachikwa bado "kunabanwa na vikwazo vikali vya kumbukumbu, ukokotoaji na nishati." Lakini kuboresha usanifu usioendana kimsingi kunachelewesha tu siku ya hesabu. Tunachohitaji ni usanifu unaochukulia kumbukumbu, utulivu na ufanisi wa nishati kama kanuni za kwanza, si mawazo ya baadaye.
Mtandao wa Neva wa Hopfield Waingia
Mtandao wa Hopfield ni mtandao wa neva unaojirudia, unaojumuisha tabaka moja la nyuroni, ambapo kila nyuroni imeunganishwa na kila nyuroni nyingine isipokuwa yenyewe. Mtandao huu huunda grafu kamili isiyo na mwelekeo: kila jozi ya nyuroni hushiriki uzito wa muunganisho wenye ulinganifu, yaani nguvu kutoka nyuroni i hadi nyuroni j ni sawa na nguvu kutoka jkwa i. Hakuna miunganisho ya neuroni kwa yenyewe (wᵢᵢ = 0). Hakuna madaraja ya tabaka. Hakuna mnyororo wa usindikaji wa hatua kwa hatua. Badala yake, mtandao mzima hufanya kazi kama mfumo mmoja wa kidinamiki uliounganishwa, unaobadilika kadri muda unavyopita kuelekea hali thabiti za usawa.
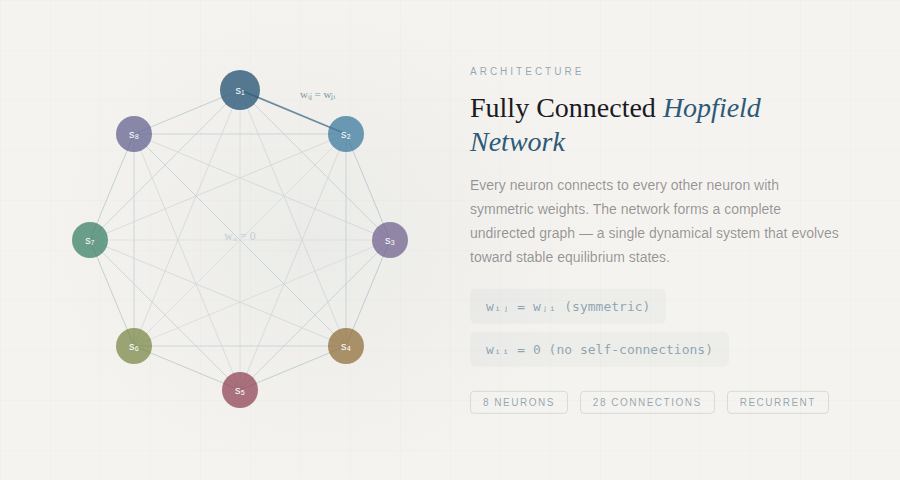
Mtandao wa Hopfield wenye neuroni zilizounganishwa kikamilifu. Kila nodi inaungana na kila nodi nyingine kwa uzito linganifu (wᵢⱼ = wⱼᵢ), na hivyo kuunda grafu kamili isiyo na mwelekeo. Hakuna neuroni inayounganishwa na yenyewe.
Uzuri wa usanifu huu upo katika kazi ya nishati. Hopfield alithibitisha kwamba mtandao wake una kazi ya nishati ya Lyapunov inayohusiana nao:
E = −½ Σᵢ Σⱼ wᵢⱼ sᵢ sⱼ − Σᵢ θᵢ sᵢ
Nishati hii imehakikishwa kupungua (au kubaki sawa) kwa kila sasisho la neuroni. Mtandao daima hufikia muunganiko: haozungukii bila kikomo, haupotei kusikojulikana, wala hauanguki kwenye mizunguko isiyoisha ya kokotoo. Unatulia. Bruck alithibitisha mwaka 1990 kwamba tabia hii ya kutulia inahusiana na mikato katika grafu inayohusiana, yaani mtandao kimsingi hutekeleza algoriti ya kitamaa (greedy) ya tatizo la max-cut katika kila hatua ya sasisho.
Na pale mtandao unapotulia ndipo akili inapokaa. Ruwaza zilizohifadhiwa zinalingana na viwango vya chini vya mahali vya kazi ya nishati, yaani mabonde katika mandhari ya nishati. Unapoupa mtandao toleo lililoharibika, lenye kelele, au pungufu la ruwaza iliyohifadhiwa, mienendo yake huiteremsha hali ya mtandao kuelekea chini hadi inapoanguka kwenye bonde la karibu zaidi: ruwaza iliyohifadhiwa inayolingana zaidi na ingizo.
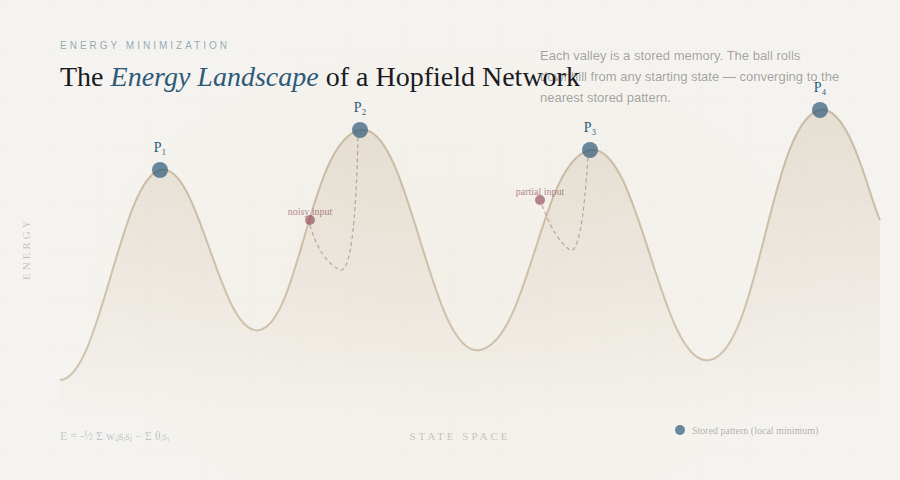
Mandhari ya nishati ya mtandao wa Hopfield. Kila bonde (kiwango cha chini cha mahali) linalingana na ruwaza moja ya kumbukumbu iliyohifadhiwa. Kuanzia hali yoyote ya awali, mienendo ya mtandao huteremka "kuelekea chini" hadi kutulia kwenye kivutio cha karibu zaidi, na kurejesha ruwaza kamili kutoka kwenye ingizo pungufu au lenye kelele.
Hii ni kumbukumbu shirikishi inayoelekezwa kwa maudhui uwezo wa kukumbuka kumbukumbu kamili kutoka kwa viashiria vichache, jambo ambalo ubongo wa kibiolojia hufanya bila juhudi, lakini transformer zinaweza kulikaribia tu kupitia kokotoo ghali.
Uhusiano na fizikia ni wa kina. Kihisabati, mtandao wa Hopfield ni sawa na modeli ya Ising, mfumo uleule unaotumika kuelezea sumaku katika mekanika ya takwimu. Modeli ya Sherrington-Kirkpatrick ya spin glass, iliyochapishwa mwaka 1975, kimsingi ni mtandao wa Hopfield wenye uzito wa nasibu. Ufahamu wa Hopfield ulikuwa kutumia sifa hii kwa makusudi, akiunda mandhari ya nishati ili kila kiwango cha chini kilingane na ruwaza muhimu iliyohifadhiwa.
Ujifunzaji wa Hebb: Neuroni Zinazowaka Pamoja Huunganika Pamoja
Kanuni ya ujifunzaji inayofanya mitandao ya Hopfield ifanye kazi ina mizizi inayorudi nyuma zaidi, hadi kitabu cha Donald Hebb cha mwaka 1949, The Organization of Behavior, kilichopendekeza kile ambacho sasa kinahesabiwa kuwa kanuni ya msingi ya nadharia ya ujifunzaji wa neva.
Ufahamu wa Hebb ulikuwa rahisi kwa udanganyifu: seli ya presinapsi inaposhiriki mara kwa mara na kwa kudumu katika kuchochea seli ya postsinapsi, muunganiko wa sinapsi kati yao huimarika. "Neuroni zinazowaka pamoja, huunganika pamoja", ingawa Hebb mwenyewe alikuwa mahususi zaidi, akisisitiza kwamba seli A inahitaji kushiriki katika kusababisha seli B iwake, si kuwaka tu kwa wakati mmoja. Usababishi huu wa kimuda ulitangulia kile kinachojulikana sasa kama unamu unaotegemea muda wa mwiba (STDP), kilichothibitishwa kwa majaribio miongo kadhaa baadaye, ikiwemo utafiti wa kuvunja ardhi wa Eric Kandel kuhusu koa wa baharini Aplysia californica.
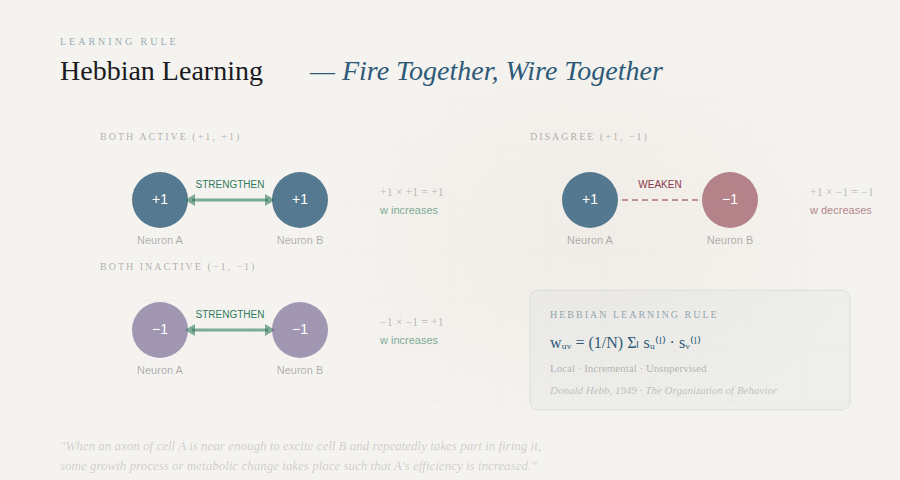
Ujifunzaji wa Hebb (Hebbian learning): nyuroni mbili zilizounganishwa zinapokuwa hai pamoja mara kwa mara, sinapsi iliyo kati yao huimarika. Kanuni hii, "nyuroni zinazowaka pamoja huungana pamoja", ndiyo msingi wa kibiolojia wa jinsi mitandao ya Hopfield inavyohifadhi mifumo.
Katika mtandao wa Hopfield, ujifunzaji wa Hebb hutekelezwa hivi:
wᵤᵥ = (1/N) Σₗ sᵤ(l) · sᵥ(l) kwa mifumo yote iliyohifadhiwa l, ambapo u ≠ v
Nyuroni mbili zinapokuwa na hali ileile katika mfumo fulani (zote +1 au zote −1), zidisho lake huwa chanya, na hilo huimarisha muunganisho wa kusisimua. Zinapotofautiana, zidisho huwa hasi, na hivyo huundwa muunganisho wa kuzuia. Athari ya jumla huchonga mandhari ya nishati yenye bonde katika kila mfumo uliohifadhiwa.
Kanuni ya Hebb ni ya ndani (kila usasishaji wa uzito hutumia taarifa zilizopo kwa nyuroni hizo mbili zilizounganishwa tu) na ya hatua kwa hatua (mifumo mipya inaweza kuhifadhiwa bila kuchakata upya ile ya zamani). Cha kustaajabisha ni kwamba, kihisabati inaweza kuonyeshwa kuwa ujifunzaji wa Hebb hufanya uchanganuzi wa vijenzi vikuu (PCA) bila usimamizi wa data ya ingizo: mtandao hutoa yenyewe sifa muhimu zaidi kitakwimu kutoka katika mazingira yake.
Mwaka 1997, Amos Storkey alianzisha kanuni bora zaidi ya ujifunzaji inayozingatia uga wa ndani wa kila nyuroni, na kufikia uwezo mkubwa zaidi wa kuhifadhi kuliko ujifunzaji wa kawaida wa Hebb. Hili linaonyesha kwamba hata ndani ya usanifu uleule, uchaguzi wa algoriti ya ujifunzaji ni muhimu sana, kanuni inayoendana na funzo pana la utafiti wa mitandao ya neva.
Mafanikio Makubwa: "Hopfield Networks is All You Need"
Mwaka 2020, timu iliyoongozwa na Hubert Ramsauer katika Chuo Kikuu cha Johannes Kepler Linz ilichapisha makala yenye kichwa cha kuchokoza, mwangwi wa hadithi ya chimbuko la transformer: "Hopfield Networks is All You Need." Mchango wao ulikuwa uthibitisho wa kihisabati wa jambo ambalo wengi walilihisi: utaratibu wa kujizingatia (self-attention) katika transformer ni hasa kanuni ya usasishaji ya mtandao wa kisasa wa Hopfield endelevu.
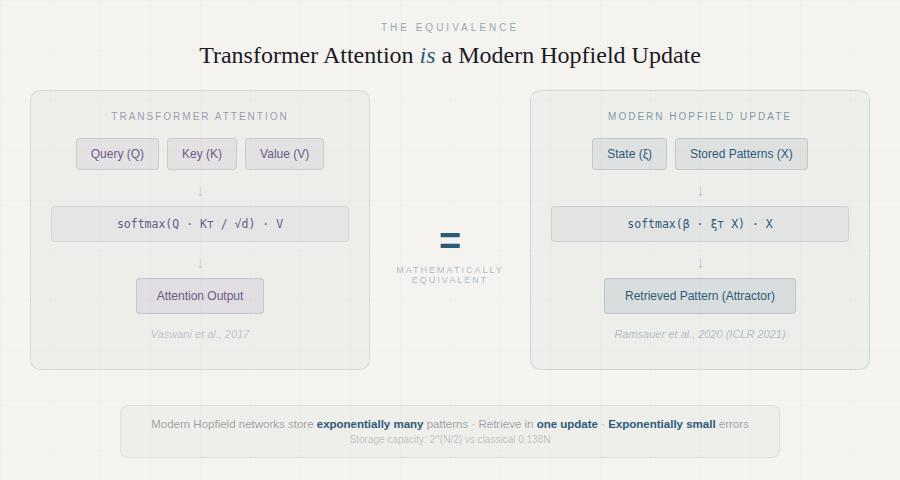
Uhusiano kati ya mitandao ya kisasa ya Hopfield na umakini (attention) wa transformer. Utaratibu wa umakini unaotegemea softmax katika transformer ni sawa kihisabati na hatua moja ya usasishaji ya mtandao wa Hopfield endelevu wenye kitendakazi cha nishati cha kielelezo. Picha kutoka Ramsauer na wenzake, "Hopfield Networks is All You Need."
Hii haikuwa tu mlinganisho. Timu ilionyesha kwamba kwa kupanua kitendakazi cha kawaida cha nishati cha Hopfield hadi hali endelevu na kutumia neno la mwingiliano la kielelezo, kanuni ya usasishaji inayopatikana inakuwa:
Z = softmax(β · R Wq Wk⊤ Y⊤) Y Wk Wv
ambayo ndiyo fomula ya umakini ya transformer hasa. Mtandao wa kisasa wa Hopfield unaweza kuhifadhi mifumo mingi kwa kasi ya kielelezo (kulingana na kipimo cha nafasi shirikishi), huirejesha kwa hatua moja ya usasishaji, na una makosa madogo sana ya kurejesha kwa kiwango cha kielelezo.
Makala hiyo ilitambua aina tatu za viwango vya chini vya nishati katika mfumo huu wa kisasa: (1) kituo thabiti cha jumla kinachochukua wastani wa mifumo yote iliyohifadhiwa, (2) hali zisizo thabiti kikamilifu zinazochukua wastani wa sehemu ndogo za mifumo, na (3) vituo thabiti vinavyohifadhi mifumo mmoja mmoja. Vichwa vya transformer katika tabaka za chini huelekea kufanya kazi katika hali ya wastani wa jumla, ilhali vichwa vya tabaka za juu hutumia hali zisizo thabiti kikamilifu kukusanya na kuchakata taarifa, ugunduzi unaotoa ufahamu wa kina kuhusu kwa nini transformer hufanya kazi kwa jinsi zinavyofanya.
Athari ya kivitendo ilikuwa ya papo hapo: timu ilitoa tabaka za Hopfieldkama moduli za PyTorch zinazoweza kuchukua nafasi ya tabaka za pooling, tabaka za GRU/LSTM, na tabaka za kawaida za attention. Katika majaribio ya vipimo (benchmarks), tabaka hizi za Hopfield zilipata matokeo ya kiwango cha juu kabisa katika uainishaji wa repertoire ya kinga mwilini (ikiwa na maelfu mamia ya visa kwa kila sampuli), matatizo ya kujifunza kwa visa vingi (multiple instance learning), na vipimo vya uainishaji vya UCI, ambako mbinu za jadi za kujifunza kwa kina (deep learning) kwa kawaida hupata ugumu.
Kufikia Desemba 2025, makala ya NeurIPS ya Masumura na Taki ilikwenda mbali zaidi, ikionyesha kwamba kuvuka "adiabatic approximation" hufichua hali fiche (hidden states) katika uhusiano kati ya Hopfield na transformer ambazo zinaweza kutatua matatizo ya kuporomoka kwa rank (rank collapse) na usawa wa tokeni (token uniformity) yanayosumbua transformer za kina, na hivyo kuboresha usahihi bila kuongeza kigezo chochote cha mafunzo.
Makubaliano Yanayokua: Nani Mwingine Anasema Hili?
Hoja hii kwamba mitandao ya Hopfield inawakilisha dhana mpya inayofuata baada ya transformer si dhana tupu. Inafuatiliwa kikamilifu na taasisi kuu za utafiti, na ushahidi unakusanyika kwa kasi. Hizi ndizo sauti na makala muhimu zinazofikia hitimisho moja.
IBM Research na Dmitry Krotov
Mnamo Januari 2025, IBM Research ilichapisha mahojiano marefu na Dmitry Krotov, mshirika wa muda mrefu wa Hopfield na mmoja wa wabunifu wa Dense Associative Memory. Krotov alitoa hoja moja kwa moja: kwa kuwa mitandao ya Hopfield huiga mizunguko ya mrejesho wa kujirudia ya ubongo tofauti na usanifu wa feedforward wa asilimia 90 ya mifumo ya AI ya sasa inawakilisha "mbadala wenye matumaini kwa mitandao ya feedforward ya leo." Alieleza kwamba transformer huchakata taarifa kuelekea upande mmoja tu, na madirisha ya muktadha (context windows) yanavyozidi kuwa marefu, ugumu wa ukokotoaji huongezeka kwa kasi. Ubongo, kwa upande mwingine, hutumia mizunguko ya mrejesho wa kujirudia kufupisha na kuhifadhi taarifa za zamani kwenye kumbukumbu. Mitandao ya Hopfield hufanya kazi kwa njia hiyo hiyo.
Krotov pia alieleza kuhusu Energy Transformer (NeurIPS 2023), ushirikiano kati ya IBM Research na Georgia Tech ambao hauishii kuweka mawazo ya Hopfield juu ya transformer zilizopo bali unachukua nafasi ya mfuatano mzima wa vizuizi vya transformer vya feedforward kwa modeli moja kubwa ya Associative Memory. Utaratibu wa attention katika Energy Transformer ni tofauti waziwazi na attention ya kawaida: umetokana na kanuni za msingi za kupunguza nishati, haukubandikwa juu ya mfumo wa feedforward.
🔗 IBM Research "Searching for brain-inspired AI algorithms" (Jan 2025)
🔗 Energy Transformer arXiv:2302.07253 (NeurIPS 2023)
Chuo Kikuu cha Johannes Kepler - Kikundi cha Hochreiter
Sepp Hochreiter, mvumbuzi mwenza wa LSTM, aliongoza timu iliyochapisha "Hopfield Networks is All You Need." Hazina yao ya Hopfield layers inatoa moduli za PyTorch tayari kwa matumizi halisi, zinazoweza kuchukua nafasi ya tabaka za attention za transformer, tabaka za pooling, na tabaka za kujirudia. Chapisho la blogu la kuambatana nalo linaonyesha hatua kwa hatua uchambuzi wa kihisabati unaothibitisha kwamba fomula ya softmax attention ni kisa maalum cha kanuni ya kisasa ya usasishaji ya Hopfield, na kwamba tabaka za Hopfield hutoa uwezo wa ziada ambao attention ya kawaida haiwezi kutoa, ukiwemo prototypes tuli zilizojifunzwa na mipangilio inayobadilika ya kumbukumbu shirikishi.
🔗 Hopfield Networks is All You Need - ICLR 2021
NeurIPS 2025: Hopfield Attention Improves GPT and Vision Transformers
Ushahidi wa hivi karibuni zaidi unatoka kwenye makala ya NeurIPS ya Desemba 2025 ya Masumura na Taki. Walionyesha kwamba Modern Hopfield Attention (MHA) ambayo huongeza hali fiche (hidden states) zinazotokana na mienendo kamili ya Hopfield (isiyo ya adiabatiki), inaboresha kwa utaratibu miundo ya lugha ya GPT-2 na LLaMA, pamoja na Vision Transformers. Maboresho haya yalipatikana bila kuongeza kigezo chochote cha mafunzo. Muhimu zaidi, MHA iligundulika kutatua tatizo la rank collapse (ambapo matriki za umakini katika transfoma za kina hudhoofika, na kusababisha tokeni zote kuungana kwenye uwakilishi unaofanana), ugonjwa wa msingi ambao umekuwa kikwazo kwa juhudi za kupanua transfoma. Waandishi walihitimisha: "Tunatumaini utafiti huu utafungua fursa mpya za usanifu wa kimfumo wa miundo ya Transformer kwa kutumia mitandao ya Hopfield."
🔗 On the Role of Hidden States of Modern Hopfield Network in Transformer arXiv:2511.20698 (NeurIPS 2025)
Nature Communications: Kujifunza Mtandaoni Kunakoendana na Biolojia
Mnamo Mei 2024, Nature Communications ilichapisha kazi kuhusu Sparse Quantized Hopfield Network, modeli inayojifunza kwa kutumia kanuni za kujifunza za ndani, katika mazingira ya mtandaoni yanayoendelea, kwa njia ileile ambayo akili za viumbe hai hufanya. Hili linashughulikia kikwazo cha msingi cha transfoma, zinazohitaji backpropagation isiyo ya ndani na mafunzo ya nje ya mtandao kwenye seti za data zilizoratibiwa. Karatasi hiyo inaweka miundo inayotegemea Hopfield kama daraja la asili kati ya mitandao bandia ya neva na maunzi ya neuromorphic.
🔗 A Sparse Quantized Hopfield Network for Online-Continual Memory Nature Communications (2024)
Outlier-Efficient Hopfield Layers for Large Foundation Models
Karatasi ya mwaka 2024 ilishughulikia tatizo la kiutendaji katika modeli kubwa za transfoma: mwelekeo wa kugawa umakini kwa tokeni zisizo na taarifa muhimu (vitenganishi, alama za uandishi), tatizo la "no-op outlier". Suluhisho lao lilikuwa outlier-efficient Hopfield energy function inayoainisha tokeni hizi na kuzielekeza kwenye kiini cha nishati sifuri, hivyo kuzuia zisipunguze nguvu ya umakini wenye manufaa. Modeli iliyopatikana inajumuisha umakini wa Softmax₁ kama hali maalum, na ilithibitishwa kwenye BERT, OPT, na Vision Transformers. Hii ni nadharia ya Hopfield ikitatua matatizo halisi ya uhandisi wa transfoma.
🔗 Outlier-Efficient Hopfield Layers for Large Transformer-Based Models (2024)
Transfoma kama Vipunguzaji vya Nishati (Januari 2026)
Kazi ya nadharia ya hivi karibuni zaidi, iliyochapishwa Januari 2026, inaeleza mchakato mzima wa uendeshaji wa mbele wa transfoma kama upunguzaji wa nishati wa ndani, ikikubali kikamilifu mtazamo wa Hopfield kama mfumo wa kueleza kwa nini transfoma zinafanya kazi kabisa. Karatasi hiyo inaunganisha miundo ya kisasa ya Hopfield isiyojaa (sparse) na familia nzima ya aina za umakini (softmax, sparsemax, α-entmax), ikionyesha kwamba zote ni hali maalum za mienendo ya urejeshaji inayotegemea nishati.
🔗 Transformers as Intrinsic Optimizers: Forward Inference through the Energy Principle (Jan 2026)
Karatasi za Mapitio na Rasilimali za Jamii
Jamii pana ya watafiti inajipanga kuzunguka muunganiko huu:
- "Energy-Based Learning and the Evolution of Hopfield Networks" (TechRxiv, Aprili 2025) Mapitio ya kina yanayofuatilia safari nzima kuanzia Hopfield (1982) kupitia Boltzmann Machines hadi kutafsiri upya umakini wa transfoma kama mienendo ya kisasa ya Hopfield. → Soma karatasi
- "An Energy-Based Perspective on Attention Mechanisms in Transformers" Blogu ya kina ya kiufundi inayosema kwamba kuelewa transfoma kupitia lenzi ya nishati ya Hopfield "huenda ikaleta maboresho tofauti kimsingi, zaidi ya yale yanayowezekana kwa kutegemea kupanua ukubwa na kupunguza ugumu wa ukokotoaji pekee." → Soma blogu
- Awesome Modern Hopfield Networks Hazina ya GitHub iliyochaguliwa kwa uangalifu inayofuatilia karatasi za utafiti zaidi ya 50 kuhusu mitandao ya kisasa ya Hopfield katika nyanja mbalimbali: ugawaji wa mali, utambuzi wa mabadiliko, urejeshaji wa mawazo ya kibunifu, utambuzi wa data zilizo nje ya usambazaji, uainishaji wa kingamwili, na mengineyo. → Pitia mkusanyiko
- "Je, Mitandao ya Hopfield Ndiyo Tu Tunayohitaji?" (Analytics India Magazine, Des 2024) Habari zinazowalenga wataalamu wa vitendo kuhusu jinsi timu ya Hochreiter ilivyoonyesha kuwa mitandao ya Hopfield "inaweza kubadilishwa na miundo ya kisasa kabisa ya transformer." → Soma makala
- "Utafiti Mpya kuhusu Mitandao ya Hopfield: Utangulizi Mfupi" (Medium, Julai 2024) Muhtasari rahisi kueleweka unaobainisha kuwa uwezo wa kuhifadhi umeongezeka kutoka 0.138N hadi 2^(N/2) kupitia vitendakazi vya uamilishaji vya kielelezo. → Soma kwenye Medium
Mwelekeo uko wazi. Hili si pendekezo la maabara moja wala dhana ya karatasi moja ya utafiti. IBM Research, Chuo Kikuu cha Johannes Kepler, MIT, NeurIPS, Nature Communications, na jumuiya pana ya ujifunzaji wa mashine zinakubaliana na hitimisho lilelile kutoka pande tofauti: dhana ya kumbukumbu shirikishi inayotegemea nishati, ambayo Hopfield aliiweka msingi, si tu msingi ambao transformers zilijengwa juu yake bila kujua, bali ni mfumo utakaoipeleka AI mbali zaidi ya yale ambayo transformers pekee zinaweza kufikia.
Kwa Nini Hili Ni Muhimu Sasa: Hoja ya Kubadili
Muunganiko Unaohakikishwa kwa Mifumo Inayohusu Usalama
Transformers hutoa matokeo, lakini hakuna dhamana ya kihisabati ya uthabiti. Mitandao ya Hopfield huungana kuelekea hali thabiti kwa uthibitisho kitendakazi cha nishati hupungua mfululizo. Kwa roboti, magari yanayojiendesha, vifaa vya matibabu, na mfumo wowote ambao kutegemewa si jambo la kujadiliwa, hii ni sharti ambalo transformers haziwezi kulitimiza.
Kumbukumbu Shirikishi kama Uwezo wa Msingi
Ukifundisha mtandao wa Hopfield ili hali (1, −1, 1, −1, 1) iwe kiwango cha chini cha nishati, kisha ukauwasilishia ingizo lililoharibika (1, −1, −1, −1, 1), mtandao huungana kuelekea mchoro sahihi uliohifadhiwa. Haubashiri wala haukadirii kati ya thamani huteremka kuelekea chini katika mandhari ya nishati hadi kwenye kivutio kilicho karibu zaidi. Kwa roboti zenye vihisi vilivyozibwa, mifumo iliyopachikwa yenye data yenye kelele, na matumizi yoyote yanayohitaji kukamilisha mchoro kutoka ingizo la sehemu tu, hili ni badiliko kubwa.
Injini ya Uboreshaji kwa Matumizi Yote
Hopfield na David Tank walionyesha mwaka 1985 kwamba mitandao ya Hopfield inaweza kutatua tatizo la muuzaji anayesafiri. Ikiwa kitendakazi cha gharama kinaweza kuandikwa katika umbo la nishati ya Hopfield, basi pointi za usawa za mtandao ni suluhisho. Tangu hapo, usanifu huu umetumika katika upangaji wa kazi za kiwandani, ugawaji wa chaneli katika mitandao isiyotumia waya, urejeshaji wa picha, ubadilishaji wa analogi kuwa dijitali, uelekezaji wa simu za mkononi, na uboreshaji wa kimchanganyiko. Karatasi ya Nature Communications ya mwaka 2024 ilianzisha Sparse Quantized Hopfield Network kwa ajili ya ujifunzaji wa kumbukumbu mtandaoni na endelevu kwa kanuni za ndani kwa njia ileile ambayo akili za kibiolojia hufanya, uwezo ambao transformers kimsingi hazina.
Maunzi Yanayofikiri Bila Programu
Kizuizi cha uzito linganifu (wᵢⱼ = wⱼᵢ) kinalingana moja kwa moja na saketi za kielektroniki za analogi muunganisho wa kipingamizi ni linganifu kwa asili yake. Mitandao ya Hopfield inaweza kutengenezwa kama ASIC au FPGA yenye uhitimishaji katika vipimo vya nanosekunde. Mkusanyiko wa Nature wa mwaka 2025 kuhusu kompyuta ya neuromorphic unathibitisha mwelekeo huu: maunzi ya analogi yanayotumia nishati kwa ufanisi na yanayotekeleza mienendo ya neva pembezoni mwa mtandao, yenye kumbukumbu inayoelekezwa kwa maudhui isiyohitaji GPU, CPU, wala safu ya programu.
Chipu za AI za neuromorphic na analogi zinazotekeleza mienendo ya mitandao ya neva moja kwa moja kwenye maunzi. Muundo linganifu unaotegemea nishati wa mitandao ya Hopfield unaendana kwa kawaida na saketi za kipingamizi, hivyo kuwezesha uelekezaji wa AI (AI inference) kwa vipimo vya nanosekunde bila safu za kawaida za programu.
Unyumbufu wa Binary na Endelevu
Mitandao ya kawaida ya Hopfield hutumia neva za binary (+1 au −1); matoleo endelevu hutumia kiwezesha cha sigmoidal na milinganyo tofauti. Masasisho yanaweza kufanyika kwa kutofuatana kwa wakati (asynchronous) (neva moja kwa wakati mmoja, jambo linalohakikisha muunganiko) au kwa wakati mmoja (synchronous) (zote kwa pamoja, jambo linaloruhusu uchakataji sambamba). Muundo huohuo hubadilika kutoka kwenye microcontroller yenye kilobaiti chache za RAM hadi FPGA yenye uchakataji sambamba mkubwa, na sasa, kupitia tabaka za kisasa za Hopfield, hadi mifumo ya kujifunza kwa kina inayoharakishwa na GPU.
Uwezo wa Kuhifadhi: Kikwazo cha Kweli
Kikwazo cha kawaida kiko wazi: mtandao wa neva N huhifadhi kwa uhakika takriban mifumo 0.138N kabla hali potofu hazijaharibu urejeshaji. Hiki ni kikwazo halisi, lakini ni kikwazo cha kweli. Transformers hazina mpaka safi wa kihisabati unaoonyesha ni lini zitaanza kubuni mambo yasiyo ya kweli (hallucinate).
Zaidi ya hayo, mitandao ya kisasa ya Hopfield (Krotov & Hopfield, 2016; Demircigil et al., 2017) hufikia uwezo wa kuhifadhi wa kielelezo (exponential) kupitia vipengele vya mwingiliano vya daraja la juu. Utafiti unaendelea kupanua mipaka hii: mitandao ya Hopfield iliyotawanyika na yenye muundo, kumbukumbu ya Hopfield ya mfuatano mrefu, na mitandao ya Hopfield kwa ugawaji wa mali, yote ni maeneo yanayoendelea kukua kikamilifu, huku machapisho yakiongezeka kwa kasi.
Utekelezaji wa Vitendo: Kutoka Kompyuta hadi Saketi
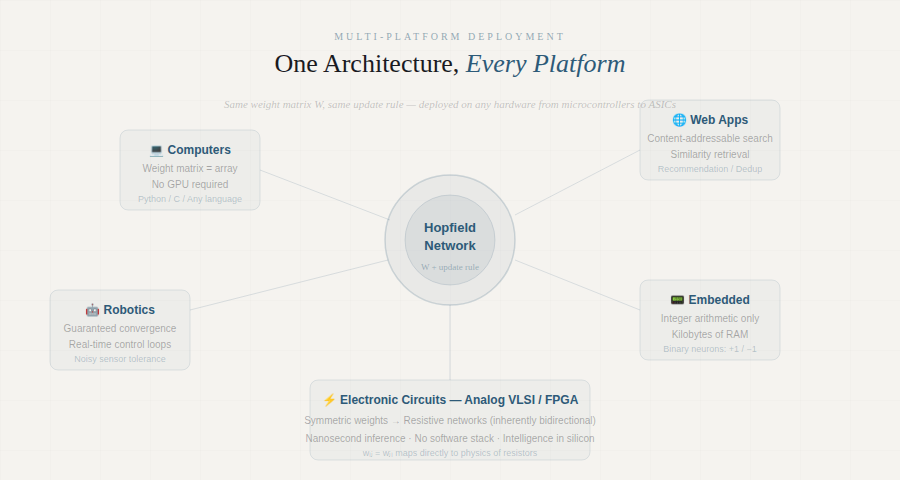
Maono ya awali ya watafiti wa mapema wa mitandao ya neva yalikuwa wazi: mfumo ambao unaweza kuelezwa mara moja na kutumika kila mahali. Muundo wa Hopfield unatimiza hilo:
Programu za kompyuta Matrix ya uzito na kanuni ya kusasisha. Hakuna GPU inayohitajika.
Programu za mtandao wa intaneti Kumbukumbu inayofikiwa kwa maudhui kwa ajili ya utafutaji wa mfanano, mapendekezo, na kuondoa nakala rudufu.
Roboti Muunganiko unaohakikishwa kwa ajili ya mizunguko ya udhibiti wa wakati halisi. Mifumo ya mwendo huhifadhiwa kama vivutio (attractors) na kukumbukwa hata kutoka kwa data ya vihisi yenye kelele.
Mifumo iliyopachikwa Mitandao ya binary ya Hopfield huendeshwa kwenye microcontroller kwa kutumia hesabu za namba kamili pekee.
Saketi za kielektroniki Uzito linganifu huendana na mitandao ya vipingamizi. Akili inayotengenezwa moja kwa moja ndani ya silikoni.
Njia ya Mbele
Enzi ya transformer ilitupa mashine za lugha za ajabu. Lakini mipaka mipya inapanuka kuelekea ulimwengu halisi: roboti, vihisi, viendeshi, na maamuzi ya wakati halisi. Mipaka hiyo inahitaji miundo iliyo thabiti, yenye ufanisi, inayoweza kufasirika, na inayoweza kutumika kwenye maunzi yaliyopo kweli pembezoni (edge).
Uthibitisho wa mwaka 2020 kwamba usikivu (attention) wa transformer ni kanuni ya kisasa ya kusasisha ya Hopfield haukuwa udadisi wa kihisabati tu, ulifichua kwamba tumekuwa tukitumia mitandao ya Hopfield muda wote, ikiwa imefunikwa ndani ya mfumo uliofifisha asili yake halisi. Kazi ya NeurIPS ya 2025 inayoonyesha kwamba hali fiche za Hopfield hutatua matatizo ya transformer kama kuporomoka kwa rank inaashiria hatua inayofuata: si kurekebisha transformers kwa maarifa ya Hopfield, bali kujenga moja kwa moja juu ya mfumo wa Hopfield wenyewe.
John Hopfield alituonyesha njia mwaka 1982. Donald Hebb aliweka misingi ya kibiolojia mwaka 1949. Jumuiya ya watafiti sasa inaelekea huko.
Ni wakati wa kubadili.
Marejeo
- Hopfield, J.J. (1982). "Neural networks and physical systems with emergent collective computational abilities." PNAS, 79(8), 2554–2558.
- Hebb, D.O. (1949). The Organization of BehaviorWiley.
- Ramsauer, H. na wenzake (2020). "Hopfield Networks is All You Need." ICLR 2021. arXiv:2008.02217
- Krotov, D. & Hopfield, J.J. (2016). "Dense Associative Memory for Pattern Recognition." NeurIPS.
- Storkey, A. (1997). "Increasing the capacity of a Hopfield network without sacrificing functionality." ICANN.
- Hoover, B., Krotov, D. na wenzake (2023). "Energy Transformer." NeurIPS 2023. arXiv:2302.07253
- Masumura, T. & Taki, M. (2025). "On the Role of Hidden States of Modern Hopfield Network in Transformer." NeurIPS 2025. arXiv:2511.20698
- Alonso, N. & Krichmar, J. (2024). "A sparse quantized Hopfield network for online-continual memory." Nature Communications, 15, 3722. nature.com
- Hu, J.Y. na wenzake (2024). "Outlier-Efficient Hopfield Layers for Large Transformer-Based Models." arXiv:2404.03828
- Hu, J.Y. na wenzake (2026). "Transformers as Intrinsic Optimizers: Forward Inference through the Energy Principle." arXiv:2511.00907
- Hopfield, J.J. & Tank, D.W. (1985). "'Neural' Computation of Decisions in Optimization Problems." Biological Cybernetics, 52, 141–152.
- Bruck, J. (1990). "On the convergence properties of the Hopfield model." Proceedings of the IEEE.
- Krotov, D. (2025). "Searching for brain-inspired AI algorithms." IBM Research Blog. research.ibm.com
- "Energy-Based Learning and the Evolution of Hopfield Networks." TechRxiv, Aprili 2025. techrxiv.org

