
การเรียนรู้แบบเฮบเบียนพบกับเครือข่ายฮอปฟิลด์: สถาปัตยกรรมที่ฉลาดกว่าทรานส์ฟอร์เมอร์มาโดยตลอด
ตลอดทศวรรษที่ผ่านมา ทรานส์ฟอร์เมอร์และกลไกความสนใจ (attention) ครองโลกของ AI มาตลอด ตั้งแต่ GPT, BERT ไปจนถึง Vision Transformers คติ "attention is all you need" เปลี่ยนวิธีคิดของเราเกี่ยวกับแมชชีนเลิร์นนิงไปทั้งหมด ระบบแปล (translator) หรือสายพานเอนโค้ดเดอร์-ดีโค้ดเดอร์ที่แปลงข้อมูลระหว่างรูปแบบการแทนค่าต่าง ๆ กลายเป็นกระดูกสันหลังของทุกอย่าง ตั้งแต่การประมวลผลภาษาไปจนถึงการสร้างภาพ พวกมันปฏิวัติวงการ พวกมันทรงพลัง
แต่ตอนนี้ พวกมันกำลังชนกำแพง
น่าขันตรงที่ทางออกมีอยู่มาตั้งแต่ปี 1982 ในปีนั้น จอห์น ฮอปฟิลด์ (John Hopfield) ตีพิมพ์บทความใน Proceedings of the National Academy of Sciences เสนอโครงข่ายประสาทเทียมแบบวนกลับที่มีคุณสมบัติซึ่งทรานส์ฟอร์เมอร์ไม่เคยทำได้จริง นั่นคือการรับประกันว่าจะลู่เข้าสู่สถานะเสถียรผ่านการทำให้พลังงานต่ำที่สุด เครือข่ายฮอปฟิลด์ไม่ได้แค่เรียนรู้รูปแบบ แต่เก็บรูปแบบเหล่านั้นไว้เป็นตัวดึงดูด (attractor) ทางกายภาพในภูมิทัศน์พลังงาน ซึ่งเรียกคืนได้แม้จากอินพุตที่มีสัญญาณรบกวนหรือไม่ครบถ้วน
ชุมชน AI เพิ่งจะเริ่มซึมซับสิ่งที่ชุมชนฟิสิกส์และประสาทวิทยาศาสตร์รู้กันมานานหลายสิบปี นั่นคือแนวทางแบบอิงพลังงานและแบบสัมพันธ์ (associative) ต่อการคำนวณของโครงข่ายประสาทไม่ใช่แค่เรื่องแปลกในประวัติศาสตร์ แต่เป็นกระบวนทัศน์รากฐานที่ยุคทรานส์ฟอร์เมอร์เพียงต่อยอดขึ้นมาโดยไม่ได้เข้าใจอย่างถ่องแท้
เพดานของทรานส์ฟอร์เมอร์
ทรานส์ฟอร์เมอร์ทำงานโดยคำนวณความสัมพันธ์ระหว่างทุกองค์ประกอบในลำดับพร้อมกันผ่านกลไกเซลฟ์แอทเทนชัน (self-attention) ซึ่งยอดเยี่ยมมากสำหรับภาษา และยอดเยี่ยมสำหรับข้อมูลที่มีโครงสร้างและรูปแบบเชิงลำดับชัดเจน แต่โลกแห่งความเป็นจริง ทั้งงานหุ่นยนต์ วงจรฝังตัว การตัดสินใจที่ขับเคลื่อนด้วยเซนเซอร์ และเอดจ์คอมพิวติ้ง ไม่ได้จัดตัวเองเป็นลำดับเรียบร้อยรอให้ใครมาใส่ใจ
สถาปัตยกรรมทรานส์ฟอร์เมอร์ตั้งอยู่บนสมมติฐานว่าทรัพยากรมีเหลือเฟือ ทั้งพลังประมวลผล หน่วยความจำ และพลังงาน เซลฟ์แอทเทนชันขยายตัวแบบกำลังสองตามความยาวของลำดับ ส่วนชั้นฟีดฟอร์เวิร์ดโตแบบเชิงเส้นแต่ใหญ่มหาศาล เมื่อนำระบบที่ใช้ทรานส์ฟอร์เมอร์ไปติดตั้งบนหุ่นยนต์เคลื่อนที่ที่วิ่งในคลังสินค้า หรือฝังลงในวงจรอิเล็กทรอนิกส์ที่ควบคุมแขนกลในโรงงาน สมมติฐานเหล่านั้นก็พังทลายลง
กระบวนทัศน์แบบตัวแปล (translator) เองก็มีข้อจำกัด เพราะมองว่าความฉลาดคือปัญหาการแปลงระหว่างรูปแบบการแทนค่าที่ตายตัวเป็นหลัก เข้ารหัสอินพุต แล้วถอดรหัสเอาต์พุต แต่ความฉลาดที่แท้จริงไม่ได้แค่แปลง มันจดจำ มันเชื่อมโยง และมันลู่เข้าสู่การตีความที่เสถียร แม้อินพุตจะเสื่อมคุณภาพหรือคลุมเครือ
เรามัวแต่ปะแก้ปัญหาเหล่านี้ด้วยการควอนไทซ์ การกลั่นความรู้ (distillation) การตัดแต่ง (pruning) และกลเม็ดเพิ่มประสิทธิภาพอีกนับร้อย งานสำรวจ Edge AI ในปี 2025 ยืนยันว่าการนำดีปเลิร์นนิงไปใช้บนฮาร์ดแวร์ฝังตัวยังคง "ถูกจำกัดด้วยข้อจำกัดอันเข้มงวดด้านหน่วยความจำ การคำนวณ และพลังงาน" แต่การเพิ่มประสิทธิภาพให้สถาปัตยกรรมที่ไม่เข้ากันตั้งแต่รากฐานก็แค่ยื้อวันสิ้นสุดออกไป สิ่งที่เราต้องการคือสถาปัตยกรรมที่ถือว่าหน่วยความจำ เสถียรภาพ และประสิทธิภาพด้านพลังงานเป็นหลักการตั้งต้น ไม่ใช่เรื่องที่มาคิดทีหลัง
เครือข่ายประสาทเทียมฮอปฟิลด์เข้าสู่เวที
เครือข่ายฮอปฟิลด์คือโครงข่ายประสาทเทียมแบบวนกลับที่ประกอบด้วยนิวรอนชั้นเดียว โดยนิวรอนแต่ละตัวเชื่อมกับนิวรอนอื่นทุกตัวยกเว้นตัวมันเอง เครือข่ายนี้สร้างกราฟไม่มีทิศทางสมบูรณ์ นิวรอนทุกคู่ใช้น้ำหนักการเชื่อมต่อแบบสมมาตรร่วมกัน หมายความว่าความแรงจากนิวรอน i ไปยังนิวรอน j เท่ากับความแรงจาก jถึง i ไม่มีการเชื่อมต่อกับตัวเอง (wᵢᵢ = 0) ไม่มีลำดับชั้นเป็นชั้น ๆ ไม่มีสายพานประมวลผลแบบเรียงลำดับ แต่ทั้งเครือข่ายทำงานเป็นระบบพลวัตเดียวที่เชื่อมโยงถึงกันหมด และวิวัฒน์ไปตามกาลเวลาสู่สถานะสมดุลที่เสถียร
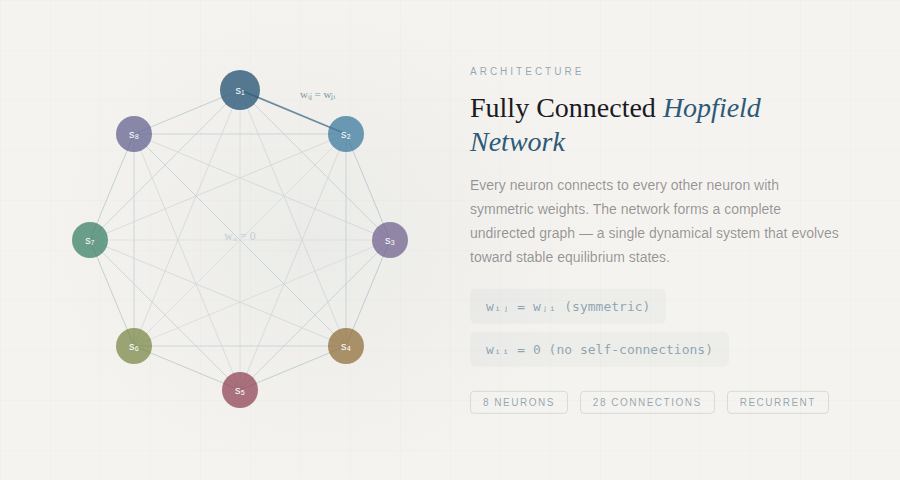
เครือข่ายฮอปฟิลด์ที่นิวรอนเชื่อมต่อกันครบทุกตัว ทุกโหนดเชื่อมกับโหนดอื่นทุกโหนดด้วยน้ำหนักแบบสมมาตร (wᵢⱼ = wⱼᵢ) เกิดเป็นกราฟไม่มีทิศทางสมบูรณ์ และไม่มีการเชื่อมต่อกับตัวเอง
ความงดงามของสถาปัตยกรรมนี้อยู่ที่ ฟังก์ชันพลังงาน ฮอปฟิลด์พิสูจน์ได้ว่าเครือข่ายของเขามีฟังก์ชันพลังงานแบบเลียปูนอฟที่เกี่ยวข้องอยู่ด้วย:
E = −½ Σᵢ Σⱼ wᵢⱼ sᵢ sⱼ − Σᵢ θᵢ sᵢ
พลังงานนี้รับประกันว่าจะลดลง (หรือคงที่) ทุกครั้งที่มีการอัปเดตนิวรอน เครือข่ายจึงลู่เข้าเสมอ ไม่แกว่งไปมาไม่รู้จบ ไม่ลู่ออก และไม่ติดอยู่ในวงวนการคำนวณอนันต์ แต่จะนิ่งลงในที่สุด บรัคพิสูจน์ในปี 1990 ว่าพฤติกรรมการนิ่งลงนี้เชื่อมโยงกับการตัด (cut) ในกราฟที่เกี่ยวข้อง กล่าวคือเครือข่ายทำงานเป็นอัลกอริทึมแบบโลภสำหรับปัญหา max-cut ในทุกขั้นตอนการอัปเดต
และจุดที่เครือข่ายนิ่งลงนั้นเองคือที่ซึ่งความฉลาดอยู่ รูปแบบที่จัดเก็บไว้สอดคล้องกับ ค่าต่ำสุดเฉพาะที่ ของฟังก์ชันพลังงาน นั่นคือหุบเขาในภูมิทัศน์พลังงาน เมื่อคุณป้อนรูปแบบที่จัดเก็บไว้ในเวอร์ชันที่ผิดเพี้ยน มีสัญญาณรบกวน หรือไม่สมบูรณ์ให้เครือข่าย พลวัตของมันจะกลิ้งสถานะของเครือข่ายลงเนินจนตกลงสู่หุบเขาที่ใกล้ที่สุด คือรูปแบบที่จัดเก็บไว้ซึ่งตรงกับอินพุตมากที่สุด
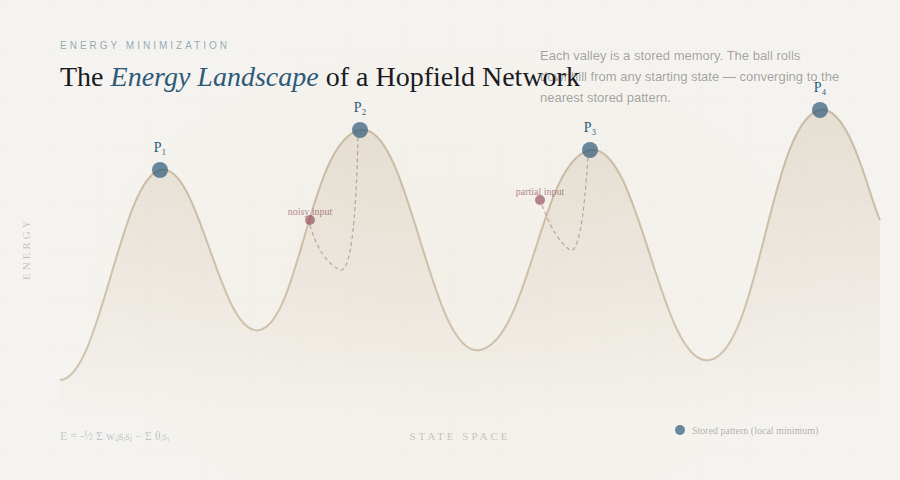
ภูมิทัศน์พลังงานของเครือข่ายฮอปฟิลด์ หุบเขาแต่ละแห่ง (ค่าต่ำสุดเฉพาะที่) สอดคล้องกับรูปแบบความทรงจำที่จัดเก็บไว้หนึ่งรูปแบบ เริ่มจากสถานะเริ่มต้นใดก็ตาม พลวัตของเครือข่ายจะกลิ้ง "ลงเนิน" จนนิ่งอยู่ที่แอททรักเตอร์ที่ใกล้ที่สุด และกู้รูปแบบฉบับสมบูรณ์กลับมาจากอินพุตที่ไม่ครบหรือมีสัญญาณรบกวน
นี่คือ หน่วยความจำแบบเชื่อมโยงที่เข้าถึงตามเนื้อหา คือความสามารถในการระลึกความทรงจำฉบับสมบูรณ์จากเงื่อนงำเพียงบางส่วน ซึ่งสมองทางชีววิทยาทำได้อย่างง่ายดาย แต่ทรานส์ฟอร์เมอร์ทำได้เพียงประมาณการด้วยการคำนวณที่สิ้นเปลือง
ความเชื่อมโยงกับฟิสิกส์นั้นลึกซึ้ง เครือข่ายฮอปฟิลด์เทียบเท่ากับแบบจำลองไอซิงในทางคณิตศาสตร์ ซึ่งเป็นกรอบเดียวกับที่ใช้อธิบายแม่เหล็กในกลศาสตร์สถิติ แบบจำลองสปินกลาสของเชอร์ริงตัน-เคิร์กแพทริก ซึ่งตีพิมพ์ในปี 1975 โดยเนื้อแท้แล้วก็คือเครือข่ายฮอปฟิลด์ที่มีน้ำหนักสุ่ม ความช่างคิดของฮอปฟิลด์คือการจงใจใช้ประโยชน์จากคุณสมบัตินี้ โดยออกแบบภูมิทัศน์พลังงานให้ค่าต่ำสุดแต่ละจุดสอดคล้องกับรูปแบบที่จัดเก็บไว้อย่างมีประโยชน์
การเรียนรู้แบบเฮบเบียน: นิวรอนที่ยิงสัญญาณพร้อมกันย่อมเชื่อมต่อกัน
กฎการเรียนรู้ที่ทำให้เครือข่ายฮอปฟิลด์ทำงานได้นั้นมีรากย้อนไปไกลกว่านั้นอีก ถึงหนังสือปี 1949 ของโดนัลด์ เฮบบ์ เรื่อง The Organization of Behavior ซึ่งเสนอสิ่งที่ปัจจุบันถือเป็นหลักการก่อตั้งของทฤษฎีการเรียนรู้ของระบบประสาท
ข้อคิดของเฮบบ์ดูเรียบง่ายอย่างหลอกตา: เมื่อเซลล์ก่อนไซแนปส์มีส่วนร่วมในการกระตุ้นเซลล์หลังไซแนปส์ซ้ำแล้วซ้ำอีกอย่างต่อเนื่อง การเชื่อมต่อไซแนปส์ระหว่างทั้งสองจะแข็งแรงขึ้น "นิวรอนที่ยิงสัญญาณพร้อมกันย่อมเชื่อมต่อกัน" แม้ว่าเฮบบ์เองจะแม่นยำกว่านั้น โดยเน้นว่าเซลล์ A ต้องมีส่วนร่วมในการทำให้ เซลล์ B ยิงสัญญาณ ไม่ใช่แค่ยิงพร้อมกันเท่านั้น ความเป็นเหตุเป็นผลเชิงเวลานี้เป็นการบุกเบิกสิ่งที่ปัจจุบันเรียกว่า สภาพพลาสติกที่ขึ้นกับจังหวะเวลาของสไปก์ (STDP) ซึ่งได้รับการยืนยันจากการทดลองในอีกหลายทศวรรษต่อมา รวมถึงงานวิจัยบุกเบิกของเอริก แคนเดลเกี่ยวกับทากทะเล Aplysia californica.
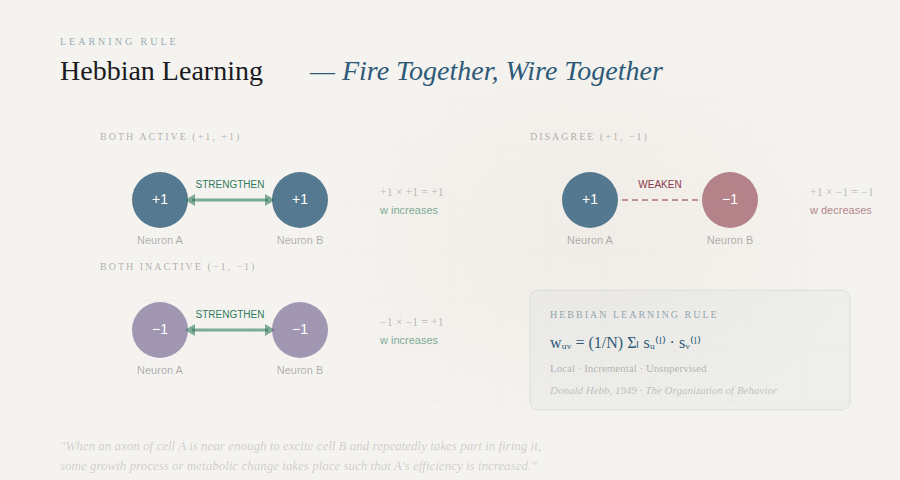
การเรียนรู้แบบเฮบเบียน (Hebbian learning): เมื่อเซลล์ประสาทสองตัวที่เชื่อมต่อกันทำงานพร้อมกันซ้ำ ๆ ไซแนปส์ระหว่างทั้งสองจะแข็งแรงขึ้น หลักการ "เซลล์ประสาทที่ทำงานด้วยกัน ย่อมเชื่อมต่อกัน" นี้คือรากฐานทางชีววิทยาของวิธีที่เครือข่ายฮอปฟิลด์ (Hopfield network) จัดเก็บรูปแบบข้อมูล
ในเครือข่ายฮอปฟิลด์ การเรียนรู้แบบเฮบเบียนถูกนำมาใช้ดังนี้:
wᵤᵥ = (1/N) Σₗ sᵤ(l) · sᵥ(l) สำหรับทุกรูปแบบที่จัดเก็บ l โดยที่ u ≠ v
เมื่อเซลล์ประสาทสองตัวมีสถานะเหมือนกันในรูปแบบหนึ่ง (ทั้งคู่เป็น +1 หรือทั้งคู่เป็น −1) ผลคูณของทั้งสองจะเป็นบวก ทำให้การเชื่อมต่อแบบกระตุ้นแข็งแรงขึ้น แต่เมื่อสถานะต่างกัน ผลคูณจะเป็นลบ เกิดเป็นการเชื่อมต่อแบบยับยั้ง ผลสะสมของกระบวนการนี้ปั้นภูมิทัศน์พลังงานให้มีหุบเขาอยู่ ณ ตำแหน่งของทุกรูปแบบที่จัดเก็บไว้
กฎของเฮบบ์เป็นแบบ เฉพาะที่ (การปรับน้ำหนักแต่ละครั้งใช้เพียงข้อมูลที่เซลล์ประสาททั้งสองตัวที่เชื่อมต่อกันมีอยู่) และเป็นแบบ เพิ่มทีละส่วน (จัดเก็บรูปแบบใหม่ได้โดยไม่ต้องประมวลผลรูปแบบเก่าซ้ำ) ที่น่าทึ่งคือ สามารถพิสูจน์ทางคณิตศาสตร์ได้ว่า การเรียนรู้แบบเฮบเบียนทำ การวิเคราะห์องค์ประกอบหลัก (PCA) แบบไม่มีผู้สอนกับข้อมูลนำเข้า กล่าวคือ เครือข่ายสกัดคุณลักษณะที่มีนัยสำคัญทางสถิติมากที่สุดจากสภาพแวดล้อมของมันได้เองตามธรรมชาติ
ในปี 1997 อามอส สตอร์คีย์ (Amos Storkey) เสนอกฎการเรียนรู้ที่ปรับปรุงขึ้น โดยคำนึงถึงสนามเฉพาะที่ของเซลล์ประสาทแต่ละตัว จึงได้ความจุในการจัดเก็บสูงกว่าการเรียนรู้แบบเฮบเบียนมาตรฐาน นี่แสดงให้เห็นว่าแม้อยู่ในสถาปัตยกรรมเดียวกัน การเลือกอัลกอริทึมการเรียนรู้ก็สำคัญอย่างยิ่ง ซึ่งสอดคล้องกับบทเรียนที่กว้างกว่าจากงานวิจัยเครือข่ายประสาทเทียม
จุดเปลี่ยน: "Hopfield Networks is All You Need"
ในปี 2020 ทีมที่นำโดยฮูเบิร์ต รัมซาวเออร์ (Hubert Ramsauer) แห่งมหาวิทยาลัยโยฮันเนส เคปเลอร์ ลินซ์ ตีพิมพ์งานวิจัยที่ตั้งชื่อได้ท้าทาย เป็นเสียงสะท้อนถึงจุดกำเนิดของทรานส์ฟอร์เมอร์: "Hopfield Networks is All You Need" ผลงานของพวกเขาคือการพิสูจน์ทางคณิตศาสตร์ในสิ่งที่หลายคนสงสัยมานาน นั่นคือ กลไกการใส่ใจตนเอง (self-attention) ในทรานส์ฟอร์เมอร์ คือ กฎการอัปเดตของเครือข่ายฮอปฟิลด์สมัยใหม่แบบต่อเนื่อง
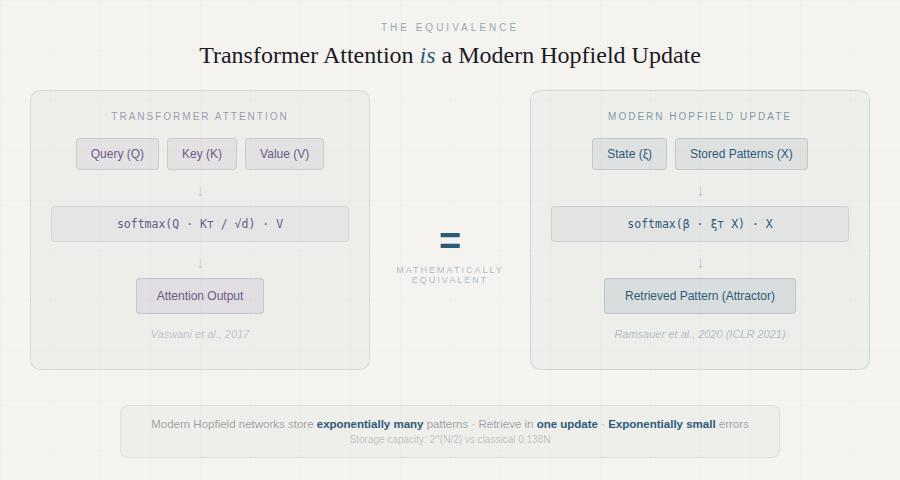
ความเชื่อมโยงระหว่างเครือข่ายฮอปฟิลด์สมัยใหม่กับกลไกการใส่ใจของทรานส์ฟอร์เมอร์ กลไกการใส่ใจที่อิงซอฟต์แมกซ์ (softmax) ในทรานส์ฟอร์เมอร์เทียบเท่ากับการอัปเดตหนึ่งขั้นของเครือข่ายฮอปฟิลด์แบบต่อเนื่องที่มีฟังก์ชันพลังงานเอกซ์โพเนนเชียลในทางคณิตศาสตร์ ภาพจาก Ramsauer et al., "Hopfield Networks is All You Need"
นี่ไม่ใช่เพียงการเปรียบเทียบ ทีมวิจัยแสดงให้เห็นว่า เมื่อขยายฟังก์ชันพลังงานของฮอปฟิลด์แบบดั้งเดิมให้รองรับสถานะต่อเนื่อง และใช้พจน์ปฏิสัมพันธ์แบบเอกซ์โพเนนเชียล กฎการอัปเดตที่ได้จะเป็น:
Z = softmax(β · R Wq Wk⊤ Y⊤) Y Wk Wv
ซึ่งก็คือสูตรการใส่ใจของทรานส์ฟอร์เมอร์นั่นเอง เครือข่ายฮอปฟิลด์สมัยใหม่สามารถจัดเก็บ รูปแบบได้จำนวนมหาศาลระดับเอกซ์โพเนนเชียล (ตามมิติของปริภูมิเชิงสัมพันธ์) ดึงรูปแบบกลับมาได้ในการอัปเดตเพียงครั้งเดียว และมีความคลาดเคลื่อนในการดึงกลับน้อยลงแบบเอกซ์โพเนนเชียล
งานวิจัยระบุจุดต่ำสุดของพลังงานสามประเภทในกรอบสมัยใหม่นี้: (1) จุดคงที่ระดับโลกที่เฉลี่ยรูปแบบที่จัดเก็บทั้งหมด (2) สถานะกึ่งเสถียรที่เฉลี่ยเฉพาะบางกลุ่มของรูปแบบ และ (3) จุดคงที่ที่จัดเก็บรูปแบบเดี่ยว หัวทรานส์ฟอร์เมอร์ในชั้นล่างมักทำงานในโหมดเฉลี่ยระดับโลก ขณะที่หัวในชั้นบนใช้สถานะกึ่งเสถียรเพื่อรวบรวมและประมวลผลข้อมูล ข้อค้นพบนี้ให้ความเข้าใจอย่างลึกซึ้งว่า ทำไม ทรานส์ฟอร์เมอร์จึงทำงานได้อย่างที่เป็น
ผลในทางปฏิบัติเกิดขึ้นทันที: ทีมวิจัยได้เปิดตัว เลเยอร์ฮอปฟิลด์ (Hopfield layers)เป็นโมดูล PyTorch แบบ drop-in ที่สามารถนำไปแทนที่เลเยอร์ pooling, เลเยอร์ GRU/LSTM และเลเยอร์ attention มาตรฐานได้ ในการทดสอบเปรียบเทียบ Hopfield layers เหล่านี้ทำผลลัพธ์ได้ล้ำสมัยที่สุดในการจำแนกประเภท immune repertoire (ที่มีตัวอย่างละหลายแสนอินสแตนซ์), ปัญหา multiple instance learning และชุดทดสอบการจำแนกประเภทของ UCI ซึ่งเป็นโจทย์ที่วิธี deep learning แบบดั้งเดิมมักทำได้ไม่ดีนัก
ภายในเดือนธันวาคม 2025 งานวิจัยของ Masumura และ Taki ที่ตีพิมพ์ใน NeurIPS ก็ก้าวไปไกลกว่านั้น โดยแสดงให้เห็นว่าการมองข้าม "การประมาณแบบอะเดียแบติก" (adiabatic approximation) ทำให้เห็น สถานะซ่อน ในความสอดคล้องระหว่าง Hopfield กับ transformer ซึ่งช่วยแก้ปัญหา rank collapse และความเหมือนกันของโทเคนที่รบกวน transformer แบบลึก ทำให้ความแม่นยำดีขึ้นโดยไม่ต้องเพิ่มพารามิเตอร์การฝึกเลย
เสียงที่เห็นพ้องกันมากขึ้นเรื่อยๆ: ยังมีใครพูดแบบเดียวกันอีกบ้าง?
ข้อโต้แย้งที่ว่าเครือข่าย Hopfield คือกระบวนทัศน์ถัดจาก transformer นี้ไม่ใช่เรื่องคาดเดา สถาบันวิจัยชั้นนำกำลังเดินหน้าศึกษาเรื่องนี้อย่างแข็งขัน และหลักฐานก็เพิ่มขึ้นอย่างรวดเร็ว ต่อไปนี้คือเสียงและงานวิจัยสำคัญที่มาบรรจบกันที่ข้อสรุปเดียวกัน
IBM Research และ Dmitry Krotov
ในเดือนมกราคม 2025 IBM Research ได้เผยแพร่บทสัมภาษณ์เชิงลึกกับ Dmitry Krotov ผู้ร่วมงานของ Hopfield มาอย่างยาวนาน และเป็นหนึ่งในสถาปนิกของ Dense Associative Memory Krotov อธิบายจุดยืนไว้อย่างตรงไปตรงมาว่า เครือข่าย Hopfield สะท้อนวงจรป้อนกลับแบบเวียนกลับ (recurrent) ของสมอง ต่างจากสถาปัตยกรรมแบบป้อนไปข้างหน้า (feedforward) ของโมเดล AI ในปัจจุบันถึง 90% จึงถือเป็น "ทางเลือกที่น่าสนใจแทนเครือข่ายแบบ feedforward ในปัจจุบัน" เขาชี้ว่า transformer ประมวลผลข้อมูลในทิศทางเดียวเท่านั้น และเมื่อหน้าต่างบริบท (context window) ยาวขึ้น ความซับซ้อนในการคำนวณก็เพิ่มขึ้นอย่างรวดเร็ว ส่วนสมองใช้วงจรป้อนกลับแบบเวียนกลับเพื่อสรุปและเก็บข้อมูลในอดีตไว้ในความจำ เครือข่าย Hopfield ก็ทำงานในแบบเดียวกัน
Krotov ยังกล่าวถึง Energy Transformer (NeurIPS 2023) ซึ่งเป็นความร่วมมือระหว่าง IBM Research กับ Georgia Tech ที่ไม่ได้แค่นำแนวคิดของ Hopfield ไปเสริมบน transformer ที่มีอยู่ แต่แทนที่บล็อก transformer แบบ feedforward ทั้งลำดับด้วยโมเดล Associative Memory ขนาดใหญ่เพียงโมเดลเดียว กลไก attention ใน Energy Transformer แตกต่างจาก attention แบบทั่วไปอย่างชัดเจน เพราะถูกสร้างขึ้นจากหลักการพื้นฐานของการลดพลังงานให้ต่ำที่สุด ไม่ได้ถูกแปะเพิ่มเข้าไปในสายพาน feedforward
🔗 IBM Research "Searching for brain-inspired AI algorithms" (ม.ค. 2025)
🔗 Energy Transformer arXiv:2302.07253 (NeurIPS 2023)
Johannes Kepler University - กลุ่มวิจัยของ Hochreiter
Sepp Hochreiter ผู้ร่วมประดิษฐ์ LSTM เป็นผู้นำทีมที่ตีพิมพ์ "Hopfield Networks is All You Need" คลังโค้ด Hopfield layers ของพวกเขามีโมดูล PyTorch พร้อมใช้งานจริง ซึ่งนำไปแทนที่เลเยอร์ attention ของ transformer, เลเยอร์ pooling และเลเยอร์ recurrent ได้ทันที ส่วน บทความประกอบ อธิบายที่มาทางคณิตศาสตร์ที่แสดงว่าสูตร softmax attention เป็นกรณีพิเศษของกฎการอัปเดต Hopfield สมัยใหม่ และ Hopfield layers ให้ความสามารถเพิ่มเติมที่ attention มาตรฐานทำไม่ได้ เช่น ต้นแบบที่เรียนรู้แบบคงที่ (static learned prototypes) และการตั้งค่าหน่วยความจำเชื่อมโยงที่ยืดหยุ่น
🔗 Hopfield Networks is All You Need - ICLR 2021
NeurIPS 2025: Hopfield Attention Improves GPT and Vision Transformers
หลักฐานล่าสุดมาจากงานวิจัย NeurIPS เดือนธันวาคม 2025 ของ Masumura และ Taki ซึ่งแสดงให้เห็นว่า การให้ความสนใจแบบ Modern Hopfield (Modern Hopfield Attention: MHA) ซึ่งเพิ่มสถานะซ่อนที่ได้จากพลวัตของ Hopfield แบบสมบูรณ์ (ไม่ใช้การประมาณแบบอะเดียแบติก) ช่วยปรับปรุงทั้งโมเดลภาษา GPT-2 และ LLaMA รวมถึง Vision Transformer ได้อย่างสม่ำเสมอ โดยไม่ต้องเพิ่มพารามิเตอร์สำหรับการฝึกเลยแม้แต่ตัวเดียว ที่สำคัญกว่านั้น MHA ยังแก้ปัญหา การยุบตัวของอันดับ (rank collapse) ได้ ซึ่งเป็นปัญหาที่เกิดขึ้นเมื่อเมทริกซ์ attention ในทรานส์ฟอร์เมอร์ที่ลึกมากเสื่อมสภาพลง ทำให้โทเค็นทั้งหมดบรรจบไปสู่การแทนค่าที่คล้ายกัน เป็นโรคพื้นฐานที่รบกวนความพยายามในการขยายขนาดทรานส์ฟอร์เมอร์มาโดยตลอด ผู้เขียนสรุปว่า "เราหวังว่างานวิจัยนี้จะเปิดความเป็นไปได้ใหม่ ๆ ในการออกแบบสถาปัตยกรรมทรานส์ฟอร์เมอร์อย่างเป็นระบบด้วยเครือข่าย Hopfield"
🔗 On the Role of Hidden States of Modern Hopfield Network in Transformer arXiv:2511.20698 (NeurIPS 2025)
Nature Communications: การเรียนรู้แบบออนไลน์ที่สอดคล้องกับหลักชีววิทยา
ในเดือนพฤษภาคม 2024 วารสาร Nature Communications ได้ตีพิมพ์งานเกี่ยวกับ Sparse Quantized Hopfield Network โมเดลที่เรียนรู้ด้วยกฎการเรียนรู้เฉพาะที่ในสถานการณ์แบบออนไลน์และต่อเนื่อง ซึ่งเป็นแบบเดียวกับที่สมองทางชีววิทยาทำงานจริง งานนี้จึงตอบข้อจำกัดพื้นฐานของทรานส์ฟอร์เมอร์ ซึ่งต้องใช้การแพร่ย้อนกลับ (backpropagation) แบบไม่เฉพาะที่ และต้องฝึกแบบออฟไลน์บนชุดข้อมูลที่คัดสรรไว้แล้ว บทความนี้วางสถาปัตยกรรมที่อิงเครือข่าย Hopfield ไว้เป็นสะพานเชื่อมตามธรรมชาติระหว่างโครงข่ายประสาทเทียมกับฮาร์ดแวร์นิวโรมอร์ฟิก
🔗 A Sparse Quantized Hopfield Network for Online-Continual Memory Nature Communications (2024)
Outlier-Efficient Hopfield Layers สำหรับโมเดลฐานขนาดใหญ่
งานวิจัยปี 2024 ชิ้นหนึ่งจัดการกับปัญหาเชิงปฏิบัติในโมเดลทรานส์ฟอร์เมอร์ขนาดใหญ่ คือแนวโน้มที่จะกระจาย attention ไปยังโทเค็นที่ไม่มีข้อมูลสำคัญ (ตัวคั่น เครื่องหมายวรรคตอน) หรือที่เรียกว่าปัญหา "no-op outlier" ทางออกของพวกเขาคือ ฟังก์ชันพลังงาน Hopfield แบบ outlier-efficient ที่จำแนกโทเค็นเหล่านี้แล้วส่งไปยังจุดพลังงานศูนย์ เพื่อไม่ให้มาเจือจาง attention ที่เป็นประโยชน์ โมเดลที่ได้ครอบคลุม Softmax₁ attention ไว้เป็นกรณีพิเศษ และผ่านการตรวจสอบบน BERT, OPT และ Vision Transformer นี่คือทฤษฎี Hopfield ที่แก้ปัญหาด้านวิศวกรรมทรานส์ฟอร์เมอร์ในโลกจริง
🔗 Outlier-Efficient Hopfield Layers for Large Transformer-Based Models (2024)
ทรานส์ฟอร์เมอร์ในฐานะตัวลดพลังงานให้ต่ำสุด (มกราคม 2026)
งานทฤษฎีล่าสุดซึ่งตีพิมพ์ในเดือนมกราคม 2026 มองการทำงานแบบ forward pass ทั้งหมดของทรานส์ฟอร์เมอร์เป็นการลดพลังงานในตัวเอง โดยรับมุมมองแบบ Hopfield เป็นกรอบอธิบายอย่างเต็มตัวว่าเหตุใดทรานส์ฟอร์เมอร์จึงใช้งานได้ บทความนี้เชื่อมโมเดล Hopfield สมัยใหม่แบบเบาบางเข้ากับตระกูลตัวแปรของ attention ทั้งหมด (softmax, sparsemax, α-entmax) และแสดงให้เห็นว่าทั้งหมดเป็นกรณีพิเศษของพลวัตการดึงข้อมูลแบบอิงพลังงาน
🔗 Transformers as Intrinsic Optimizers: Forward Inference through the Energy Principle (ม.ค. 2026)
บทความรีวิวและแหล่งข้อมูลจากชุมชน
ชุมชนวิจัยในวงกว้างกำลังรวมตัวกันรอบจุดบรรจบนี้:
- "Energy-Based Learning and the Evolution of Hopfield Networks" (TechRxiv เมษายน 2025) บทความรีวิวฉบับครอบคลุมที่ไล่เรียงเส้นทางทั้งหมด ตั้งแต่ Hopfield (1982) ผ่าน Boltzmann Machine ไปจนถึงการตีความ attention ของทรานส์ฟอร์เมอร์ใหม่ว่าเป็นพลวัตแบบ Hopfield สมัยใหม่ → อ่านบทความ
- "An Energy-Based Perspective on Attention Mechanisms in Transformers" บล็อกเชิงเทคนิคเชิงลึกที่โต้แย้งว่า การทำความเข้าใจทรานส์ฟอร์เมอร์ผ่านเลนส์พลังงานแบบ Hopfield "อาจนำไปสู่การปรับปรุงที่แตกต่างในเชิงคุณภาพ เกินกว่าที่จะทำได้เพียงอาศัยการขยายขนาดและลดความซับซ้อนในการคำนวณเท่านั้น" ← อ่านบล็อก
- Awesome Modern Hopfield Networks คลังข้อมูล GitHub ที่คัดสรรมาอย่างดี รวบรวมงานวิจัยกว่า 50 ชิ้นเกี่ยวกับโครงข่ายฮอปฟิลด์สมัยใหม่ (modern Hopfield networks) ในหลากหลายสาขา ไม่ว่าจะเป็นการจัดสรรสินทรัพย์ การตรวจจับการเปลี่ยนแปลง การสร้างความคิดสร้างสรรค์ขึ้นใหม่ การตรวจจับข้อมูลนอกการแจกแจง (out-of-distribution) การจำแนกภูมิคุ้มกันเรเพอร์ทัวร์ และอื่นๆ อีกมาก → เปิดดูคอลเลกชัน
- "Is Hopfield Networks All You Need?" (Analytics India Magazine, ธ.ค. 2024) บทความมุ่งผู้ปฏิบัติงานที่อธิบายว่าทีมของ Hochreiter แสดงให้เห็นอย่างไรว่าโครงข่ายฮอปฟิลด์ "ใช้แทนกันได้กับโมเดลทรานส์ฟอร์เมอร์ระดับแนวหน้า" → อ่านบทความ
- "New Research in Hopfield Networks: A Short Intro" (Medium, ก.ค. 2024) ภาพรวมที่อ่านเข้าใจง่าย ชี้ว่าความจุในการจัดเก็บเพิ่มขึ้นจาก 0.138N เป็น 2^(N/2) ด้วยฟังก์ชันกระตุ้นแบบเอกซ์โพเนนเชียล → อ่านบน Medium
ทิศทางนั้นชัดเจน นี่ไม่ใช่ข้อเสนอของห้องแล็บเดียวหรือการคาดเดาในงานวิจัยชิ้นเดียว IBM Research, มหาวิทยาลัยโยฮันเนส เคปเลอร์ (Johannes Kepler University), MIT, NeurIPS, Nature Communications และชุมชนแมชชีนเลิร์นนิงในวงกว้าง ต่างกำลังมุ่งสู่ข้อสรุปเดียวกันจากคนละทิศทาง นั่นคือกระบวนทัศน์หน่วยความจำแบบเชื่อมโยงที่อิงพลังงาน ซึ่งฮอปฟิลด์วางรากฐานไว้ ไม่ได้เป็นเพียงรากฐานที่ทรานส์ฟอร์เมอร์ถูกสร้างขึ้นมาโดยไม่รู้ตัวเท่านั้น แต่ยังเป็นกรอบแนวคิดที่จะพา AI ก้าวไปไกลเกินกว่าที่ทรานส์ฟอร์เมอร์เพียงลำพังจะทำได้
ทำไมเรื่องนี้จึงสำคัญในตอนนี้: เหตุผลที่ควรเปลี่ยน
การันตีการลู่เข้าสำหรับระบบที่เกี่ยวข้องกับความปลอดภัย
ทรานส์ฟอร์เมอร์ให้ผลลัพธ์ออกมาก็จริง แต่ไม่มีหลักประกันทางคณิตศาสตร์ว่าจะเสถียร ส่วนโครงข่ายฮอปฟิลด์ลู่เข้าสู่สถานะเสถียรได้ด้วยการพิสูจน์ ฟังก์ชันพลังงานลดลงอย่างต่อเนื่องเสมอ สำหรับหุ่นยนต์ ยานยนต์ไร้คนขับ อุปกรณ์การแพทย์ และระบบใดก็ตามที่ความน่าเชื่อถือเป็นเรื่องต่อรองไม่ได้ นี่คือข้อกำหนดที่ทรานส์ฟอร์เมอร์ให้ไม่ได้
หน่วยความจำแบบเชื่อมโยงในฐานะความสามารถหลัก
หากคุณฝึกโครงข่ายฮอปฟิลด์ให้สถานะ (1, −1, 1, −1, 1) เป็นจุดพลังงานต่ำสุด แล้วป้อนอินพุตที่เสียหาย (1, −1, −1, −1, 1) โครงข่ายจะลู่เข้าสู่แพตเทิร์นที่จัดเก็บไว้ได้อย่างถูกต้อง มันไม่ได้เดาหรือประมาณค่าเอา แต่ "กลิ้งลงเนิน" ในภูมิทัศน์พลังงานไปยังตัวดึงดูด (attractor) ที่ใกล้ที่สุด สำหรับหุ่นยนต์ที่เซนเซอร์ถูกบดบัง ระบบฝังตัวที่มีข้อมูลรบกวน และทุกงานที่ต้องเติมแพตเทิร์นให้สมบูรณ์จากอินพุตเพียงบางส่วน นี่คือการเปลี่ยนแปลงครั้งใหญ่
เครื่องมือเพิ่มประสิทธิภาพสากล
ฮอปฟิลด์และเดวิด แทงก์ (David Tank) แสดงให้เห็นในปี 1985 ว่าโครงข่ายฮอปฟิลด์แก้ปัญหาพนักงานขายเดินทาง (traveling salesman problem) ได้ หากเขียนฟังก์ชันต้นทุนให้อยู่ในรูปพลังงานแบบฮอปฟิลด์ได้ จุดสมดุลของโครงข่ายก็ คือ คำตอบนั่นเอง นับแต่นั้นมา สถาปัตยกรรมนี้ถูกนำไปใช้กับการจัดตารางงานแบบ job-shop การจัดสรรช่องสัญญาณในเครือข่ายไร้สาย การฟื้นฟูภาพ การแปลงสัญญาณอนาล็อกเป็นดิจิทัล การจัดเส้นทางบนอุปกรณ์เคลื่อนที่ และการหาค่าเหมาะที่สุดเชิงการจัดหมู่ งานวิจัยใน Nature Communications ปี 2024 ได้นำเสนอ Sparse Quantized Hopfield Network สำหรับการเรียนรู้หน่วยความจำแบบต่อเนื่องออนไลน์ด้วยกฎเฉพาะที่ เช่นเดียวกับที่สมองทางชีววิทยาทำ ซึ่งเป็นความสามารถที่ทรานส์ฟอร์เมอร์ไม่มีมาแต่พื้นฐาน
ฮาร์ดแวร์ที่คิดได้โดยไม่ต้องพึ่งซอฟต์แวร์
ข้อจำกัดเรื่องน้ำหนักสมมาตร (wᵢⱼ = wⱼᵢ) แมปลงบนวงจรอิเล็กทรอนิกส์แบบอนาล็อกได้โดยตรง เพราะการเชื่อมต่อแบบตัวต้านทานนั้นสมมาตรโดยธรรมชาติ โครงข่ายฮอปฟิลด์สามารถผลิตเป็น ASIC หรือ FPGA ที่อนุมานได้ในระดับนาโนวินาที ชุดบทความด้านการประมวลผลแบบนิวโรมอร์ฟิกของ Nature ปี 2025 ยืนยันทิศทางนี้ คือฮาร์ดแวร์อนาล็อกประหยัดพลังงานที่ใช้พลวัตแบบโครงข่ายประสาทที่ขอบเครือข่าย (edge) พร้อมหน่วยความจำแบบเข้าถึงตามเนื้อหา (content-addressable memory) ที่ไม่ต้องใช้ GPU ไม่ต้องใช้ CPU และไม่ต้องมีซอฟต์แวร์สแตก
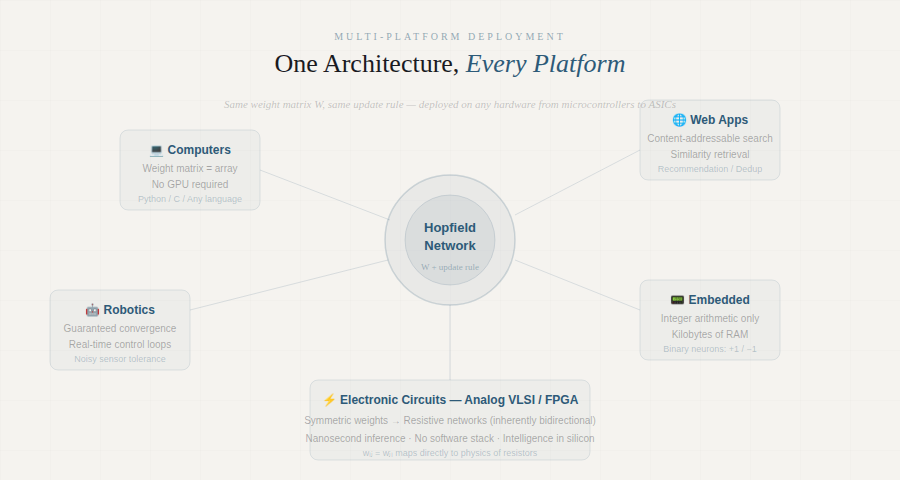
โครงข่าย Neuromorphic และชิป AI แบบอนาล็อกที่นำพลวัตของโครงข่ายประสาทเทียมมาสร้างไว้ในฮาร์ดแวร์โดยตรง โครงสร้างแบบสมมาตรที่อิงพลังงานของโครงข่าย Hopfield สอดคล้องกับวงจรตัวต้านทานอย่างเป็นธรรมชาติ ทำให้ประมวลผลอนุมานของ AI ได้ในระดับนาโนวินาทีโดยไม่ต้องพึ่งซอฟต์แวร์สแตกแบบดั้งเดิม
ยืดหยุ่นทั้งแบบไบนารีและแบบต่อเนื่อง
โครงข่าย Hopfield แบบดั้งเดิมใช้นิวรอนไบนารี (+1 หรือ −1) ส่วนรูปแบบต่อเนื่องใช้ฟังก์ชันกระตุ้นแบบซิกมอยด์และสมการเชิงอนุพันธ์ การอัปเดตทำได้ทั้งแบบอะซิงโครนัส (ทีละนิวรอน รับประกันการลู่เข้า) หรือแบบซิงโครนัส (พร้อมกันทั้งหมด เปิดทางให้ประมวลผลคู่ขนาน) สถาปัตยกรรมเดียวกันนี้ปรับใช้ได้ตั้งแต่ไมโครคอนโทรลเลอร์ที่มี RAM เพียงหลักกิโลไบต์ ไปจนถึง FPGA ที่ประมวลผลคู่ขนานขนาดมหาศาล และตอนนี้ด้วยเลเยอร์ Hopfield สมัยใหม่ ก็ยังต่อยอดไปถึงไปป์ไลน์ดีปเลิร์นนิงที่เร่งความเร็วด้วย GPU ได้ด้วย
ความจุในการจัดเก็บ: ข้อจำกัดที่ซื่อตรง
ข้อจำกัดของแบบดั้งเดิมนั้นชัดเจน: โครงข่ายที่มี N นิวรอนจะเก็บแพตเทิร์นได้อย่างเชื่อถือได้ราว 0.138N แพตเทิร์น ก่อนที่สถานะลวง (spurious states) จะทำให้การดึงข้อมูลกลับเพี้ยนไป นี่เป็นข้อจำกัดที่เป็นจริง แต่ก็เป็นข้อจำกัดที่ ซื่อตรง ส่วนทรานส์ฟอร์เมอร์ไม่มีขอบเขตทางคณิตศาสตร์ที่ชัดเจนว่าจะเริ่มหลอน (hallucinate) เมื่อไร
ยิ่งไปกว่านั้น โครงข่าย Hopfield สมัยใหม่ (Krotov & Hopfield, 2016; Demircigil et al., 2017) ยังมีความจุในการจัดเก็บแบบเอกซ์โพเนนเชียล ผ่านพจน์ปฏิสัมพันธ์อันดับสูง งานวิจัยยังขยายขอบเขตเหล่านี้ต่อเนื่อง ไม่ว่าจะเป็นโครงข่าย Hopfield แบบเบาบางและมีโครงสร้าง หน่วยความจำ Hopfield สำหรับลำดับยาว และโครงข่าย Hopfield สำหรับการจัดสรรสินทรัพย์ ล้วนเป็นสาขาที่กำลังพัฒนาอย่างคึกคัก มีบทความตีพิมพ์เพิ่มขึ้นอย่างรวดเร็ว
การใช้งานจริง: จากพีซีสู่วงจรอิเล็กทรอนิกส์
วิสัยทัศน์ดั้งเดิมของนักวิจัยโครงข่ายประสาทเทียมยุคแรกนั้นชัดเจน คือกรอบแนวคิดที่อธิบายได้เพียงครั้งเดียวแล้วนำไปใช้ได้ทุกที่ สถาปัตยกรรมของ Hopfield ทำให้สิ่งนี้เป็นจริง:
แอปพลิเคชันคอมพิวเตอร์ มีเพียงเมทริกซ์น้ำหนักและกฎการอัปเดต ไม่ต้องใช้ GPU
แอปพลิเคชันอินเทอร์เน็ต หน่วยความจำแบบเข้าถึงด้วยเนื้อหา (content-addressable memory) สำหรับการค้นหาความคล้ายคลึง การแนะนำ และการกำจัดข้อมูลซ้ำซ้อน
หุ่นยนต์ รับประกันการลู่เข้าสำหรับลูปควบคุมแบบเรียลไทม์ รูปแบบการเคลื่อนไหวของมอเตอร์ถูกเก็บเป็นแอทแทรกเตอร์ และเรียกคืนได้แม้อินพุตจากเซนเซอร์จะมีสัญญาณรบกวน
ระบบฝังตัว โครงข่าย Hopfield แบบไบนารีรันบนไมโครคอนโทรลเลอร์ได้ด้วยเลขคณิตจำนวนเต็มล้วน ๆ
วงจรอิเล็กทรอนิกส์ น้ำหนักแบบสมมาตรสอดคล้องกับโครงข่ายตัวต้านทาน ปัญญาที่ถูกสร้างลงบนซิลิคอนโดยตรง
เส้นทางข้างหน้า
ยุคทรานส์ฟอร์เมอร์มอบเครื่องจักรภาษาที่ยอดเยี่ยมให้เรา แต่พรมแดนกำลังขยายเข้าสู่โลกทางกายภาพ ทั้งหุ่นยนต์ เซนเซอร์ แอคชูเอเตอร์ และการตัดสินใจแบบเรียลไทม์ พรมแดนนี้ต้องการสถาปัตยกรรมที่เสถียร มีประสิทธิภาพ ตีความได้ และนำไปใช้บนฮาร์ดแวร์ที่มีอยู่จริงที่ชายขอบของเครือข่าย (edge) ได้
หลักฐานในปี 2020 ที่ว่าความใส่ใจ (attention) ของทรานส์ฟอร์เมอร์ คือ กฎการอัปเดตของ Hopfield สมัยใหม่ ไม่ได้เป็นเพียงความน่าสนใจทางคณิตศาสตร์ แต่เผยให้เห็นว่าเราใช้โครงข่าย Hopfield มาตลอด เพียงแต่ห่อไว้ในกรอบที่บดบังธรรมชาติที่แท้จริงของมัน งานวิจัยของ NeurIPS ปี 2025 ที่แสดงว่าสถานะซ่อนของ Hopfield แก้ปัญหาเชิงพยาธิสภาพของทรานส์ฟอร์เมอร์ เช่น rank collapse ชี้ว่าก้าวต่อไปไม่ใช่การปะทรานส์ฟอร์เมอร์ด้วยข้อค้นพบจาก Hopfield แต่คือการสร้างบนกระบวนทัศน์ของ Hopfield โดยตรง
John Hopfield ชี้ทางให้เราตั้งแต่ปี 1982 ส่วน Donald Hebb วางรากฐานทางชีววิทยาไว้ในปี 1949 ตอนนี้ชุมชนวิจัยกำลังมาบรรจบกันที่แนวทางนี้
ถึงเวลาเปลี่ยนแล้ว
เอกสารอ้างอิง
- Hopfield, J.J. (1982). "Neural networks and physical systems with emergent collective computational abilities." PNAS, 79(8), 2554–2558.
- Hebb, D.O. (1949). The Organization of Behaviorสำนักพิมพ์ Wiley
- Ramsauer, H. et al. (2020). "Hopfield Networks is All You Need." ICLR 2021. arXiv:2008.02217
- Krotov, D. & Hopfield, J.J. (2016). "Dense Associative Memory for Pattern Recognition." NeurIPS.
- Storkey, A. (1997). "Increasing the capacity of a Hopfield network without sacrificing functionality." ICANN.
- Hoover, B., Krotov, D. et al. (2023). "Energy Transformer." NeurIPS 2023. arXiv:2302.07253
- Masumura, T. & Taki, M. (2025). "On the Role of Hidden States of Modern Hopfield Network in Transformer." NeurIPS 2025. arXiv:2511.20698
- Alonso, N. & Krichmar, J. (2024). "A sparse quantized Hopfield network for online-continual memory." Nature Communications, 15, 3722. nature.com
- Hu, J.Y. et al. (2024). "Outlier-Efficient Hopfield Layers for Large Transformer-Based Models." arXiv:2404.03828
- Hu, J.Y. et al. (2026). "Transformers as Intrinsic Optimizers: Forward Inference through the Energy Principle." arXiv:2511.00907
- Hopfield, J.J. & Tank, D.W. (1985). "'Neural' Computation of Decisions in Optimization Problems." Biological Cybernetics, 52, 141–152.
- Bruck, J. (1990). "On the convergence properties of the Hopfield model." Proceedings of the IEEE.
- Krotov, D. (2025). "Searching for brain-inspired AI algorithms." IBM Research Blog. research.ibm.com
- "Energy-Based Learning and the Evolution of Hopfield Networks." TechRxiv, เมษายน 2025 techrxiv.org

