
Học Hebbian gặp mạng Hopfield: Kiến trúc vốn luôn thông minh hơn Transformer
Suốt một thập kỷ qua, transformer và cơ chế chú ý (attention) của chúng đã thống trị bức tranh AI. Từ GPT đến BERT rồi Vision Transformer, câu thần chú "attention is all you need" đã định hình lại cách chúng ta nghĩ về học máy. Các hệ thống dịch (translator), tức những đường ống bộ mã hóa–bộ giải mã chuyển đổi dữ liệu giữa các dạng biểu diễn, trở thành xương sống của mọi thứ, từ xử lý ngôn ngữ đến tạo ảnh. Chúng mang tính cách mạng. Chúng mạnh mẽ.
Và giờ đây, chúng đang chạm tới một bức tường.
Điều trớ trêu là lời giải đã có từ năm 1982. Năm đó, John Hopfield công bố một bài báo trên Proceedings of the National Academy of Sciences giới thiệu một mạng nơ-ron hồi quy sở hữu thứ mà transformer chưa bao giờ thực sự đạt được: đảm bảo hội tụ về các trạng thái ổn định thông qua việc cực tiểu hóa năng lượng. Mạng Hopfield không chỉ học các mẫu mà còn lưu chúng như những điểm hút vật lý trong một cảnh quan năng lượng, có thể truy xuất ngay cả từ đầu vào nhiễu hoặc không đầy đủ.
Cộng đồng AI đến giờ mới bắt đầu thấm thía điều mà giới vật lý và khoa học thần kinh đã biết từ nhiều thập kỷ: cách tiếp cận liên tưởng dựa trên năng lượng đối với tính toán thần kinh không phải là một món đồ cổ của lịch sử mà là một mô hình nền tảng, thứ mà kỷ nguyên transformer chỉ xây dựng lên trên đó mà chưa hiểu thấu đáo.
Trần kính của Transformer
Transformer hoạt động bằng cách tính toán mối quan hệ giữa mọi phần tử trong một chuỗi cùng lúc thông qua tự chú ý (self-attention). Điều này tuyệt vời với ngôn ngữ. Nó tuyệt vời với dữ liệu có cấu trúc và các mẫu tuần tự rõ ràng. Nhưng thế giới thực, thế giới của robot, mạch nhúng, ra quyết định dựa trên cảm biến và điện toán biên, không tự sắp xếp thành những chuỗi gọn gàng chờ được chú ý tới.
Kiến trúc transformer giả định mọi thứ đều dư dả: sức tính toán dồi dào, bộ nhớ dồi dào, năng lượng dồi dào. Tự chú ý tăng theo bình phương độ dài chuỗi. Các lớp truyền thẳng tăng tuyến tính nhưng với quy mô khổng lồ. Khi bạn triển khai một hệ thống dựa trên transformer lên robot di động đang di chuyển trong nhà kho, hay nhúng nó vào mạch điện tử điều khiển một cánh tay máy trong sản xuất, những giả định ấy sụp đổ.
Mô hình dịch cũng mang một giới hạn riêng: nó coi trí tuệ chủ yếu là bài toán chuyển đổi giữa các dạng biểu diễn cố định. Mã hóa đầu vào. Giải mã đầu ra. Nhưng trí tuệ thực sự không chỉ dịch, nó ghi nhớ, nó liên tưởng, và nó hội tụ về những cách diễn giải ổn định ngay cả khi đầu vào bị suy giảm hoặc mơ hồ.
Chúng ta đã vá những vấn đề này bằng lượng tử hóa, chưng cất, cắt tỉa và hàng trăm mẹo tối ưu hóa khác. Các khảo sát về Edge AI năm 2025 xác nhận rằng việc triển khai học sâu trên phần cứng nhúng vẫn "bị ràng buộc bởi những giới hạn nghiêm ngặt về bộ nhớ, tính toán và năng lượng". Nhưng tối ưu hóa một kiến trúc vốn không phù hợp từ gốc chỉ làm chậm lại giờ phán xét. Điều chúng ta cần là một kiến trúc coi bộ nhớ, tính ổn định và hiệu quả năng lượng là nguyên lý đầu tiên chứ không phải những thứ nghĩ sau.
Mạng nơ-ron Hopfield xuất hiện
Mạng Hopfield là một mạng nơ-ron hồi quy gồm một lớp nơ-ron duy nhất, trong đó mỗi nơ-ron được nối với mọi nơ-ron khác trừ chính nó. Mạng tạo thành một đồ thị vô hướng đầy đủ: mỗi cặp nơ-ron chia sẻ một trọng số kết nối đối xứng, nghĩa là cường độ từ nơ-ron i đến nơ-ron j đúng bằng cường độ từ jthành i. Không có kết nối tự thân (wᵢᵢ = 0). Không có cấu trúc phân tầng. Không có đường ống xử lý tuần tự. Thay vào đó, toàn bộ mạng vận hành như một hệ động lực duy nhất, liên kết chặt chẽ, tiến hóa theo thời gian về các trạng thái cân bằng ổn định.
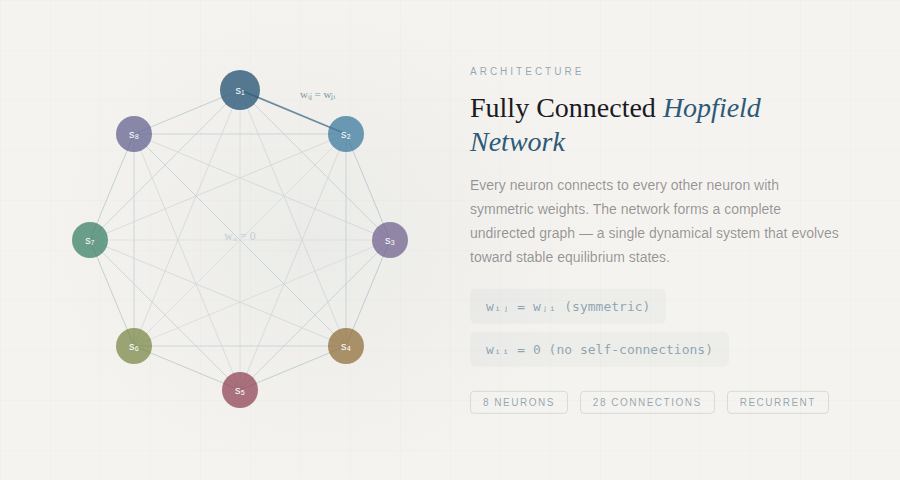
Mạng Hopfield với các nơ-ron kết nối đầy đủ. Mỗi nút nối với mọi nút khác bằng trọng số đối xứng (wᵢⱼ = wⱼᵢ), tạo thành một đồ thị vô hướng đầy đủ. Không tồn tại kết nối tự thân.
Vẻ đẹp của kiến trúc này nằm ở hàm năng lượng của nó. Hopfield đã chứng minh rằng mạng của ông có một hàm năng lượng Lyapunov đi kèm:
E = −½ Σᵢ Σⱼ wᵢⱼ sᵢ sⱼ − Σᵢ θᵢ sᵢ
Năng lượng này được đảm bảo giảm (hoặc giữ nguyên) sau mỗi lần cập nhật nơ-ron. Mạng luôn hội tụ: không bao giờ dao động mãi, không phân kỳ, không sa vào những vòng lặp tính toán vô tận. Nó lắng xuống. Năm 1990, Bruck chứng minh rằng hành vi lắng xuống này liên quan đến các lát cắt trong đồ thị tương ứng: về bản chất, ở mỗi bước cập nhật mạng thực hiện một thuật toán tham lam cho bài toán cực đại lát cắt (max-cut).
Và nơi mạng lắng xuống chính là nơi trí thông minh cư ngụ. Các mẫu được lưu trữ tương ứng với cực tiểu cục bộ của hàm năng lượng, tức những thung lũng trong cảnh quan năng lượng. Khi bạn đưa vào mạng một phiên bản bị hỏng, nhiễu hoặc không đầy đủ của một mẫu đã lưu, động lực học sẽ lăn trạng thái của mạng xuống dốc cho đến khi nó rơi vào thung lũng gần nhất: mẫu đã lưu khớp nhất với đầu vào.
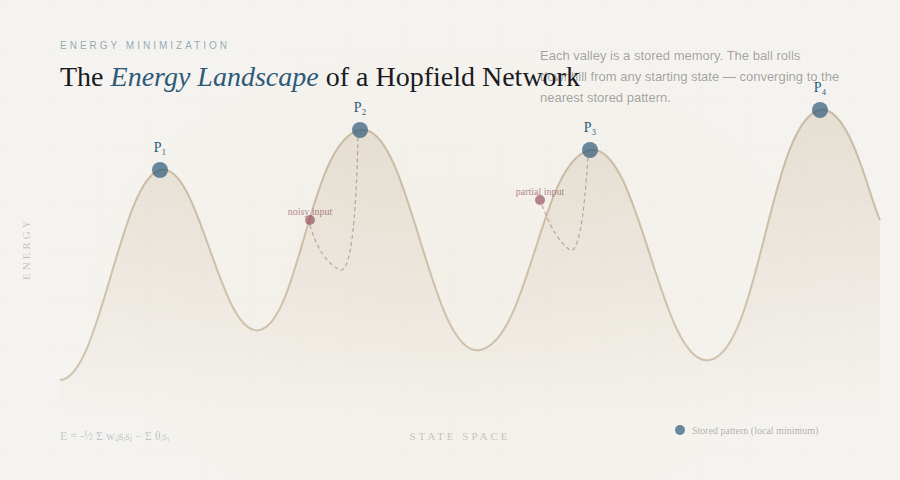
Cảnh quan năng lượng của một mạng Hopfield. Mỗi thung lũng (cực tiểu cục bộ) tương ứng với một mẫu ký ức đã lưu. Xuất phát từ bất kỳ trạng thái ban đầu nào, động lực học của mạng lăn "xuống dốc" cho đến khi lắng vào điểm hút gần nhất, khôi phục mẫu hoàn chỉnh từ đầu vào thiếu sót hoặc nhiễu.
Đây chính là bộ nhớ liên kết truy xuất theo nội dung khả năng gợi lại toàn bộ ký ức từ một vài manh mối, điều mà bộ não sinh học làm một cách dễ dàng còn transformer chỉ có thể xấp xỉ bằng những phép tính tốn kém.
Mối liên hệ với vật lý rất sâu sắc. Về mặt toán học, mạng Hopfield tương đương với mô hình Ising, cùng khuôn khổ dùng để mô tả từ tính trong cơ học thống kê. Mô hình thủy tinh spin Sherrington-Kirkpatrick, công bố năm 1975, về cơ bản là một mạng Hopfield với các trọng số ngẫu nhiên. Cái nhìn thấu suốt của Hopfield là khai thác có chủ đích tính chất này, thiết kế cảnh quan năng lượng sao cho mỗi cực tiểu ứng với một mẫu hữu ích được lưu trữ.
Học Hebb: Những nơ-ron cùng phát xung thì liên kết với nhau
Quy tắc học giúp mạng Hopfield vận hành có nguồn gốc còn xa hơn nữa, từ cuốn sách năm 1949 của Donald Hebb The Organization of Behavior, trong đó nêu lên điều ngày nay được xem là nguyên lý nền tảng của lý thuyết học thần kinh.
Ý tưởng của Hebb đơn giản một cách đánh lừa: khi một tế bào tiền synap liên tục và bền bỉ tham gia kích hoạt một tế bào hậu synap, kết nối synap giữa chúng sẽ mạnh lên. "Những nơ-ron cùng phát xung thì liên kết với nhau", dù chính Hebb nói chính xác hơn, nhấn mạnh rằng tế bào A phải góp phần gây ra việc tế bào B phát xung, chứ không chỉ phát xung cùng lúc. Tính nhân quả theo thời gian này đã báo trước điều ngày nay gọi là tính dẻo phụ thuộc thời điểm xung (STDP), được xác nhận bằng thực nghiệm nhiều thập kỷ sau, trong đó có nghiên cứu đột phá của Eric Kandel trên loài sên biển Aplysia californica.
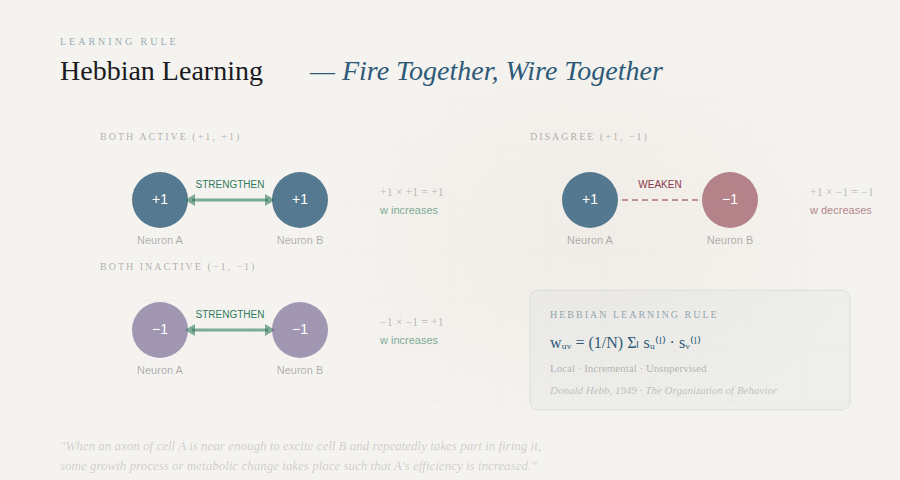
Học Hebbian: khi hai nơ-ron kết nối với nhau liên tục hoạt động cùng lúc, synapse giữa chúng sẽ mạnh lên. Nguyên lý "các nơ-ron cùng phát xung thì liên kết với nhau" này là nền tảng sinh học cho cách mạng Hopfield lưu trữ các mẫu.
Trong mạng Hopfield, học Hebbian được triển khai như sau:
wᵤᵥ = (1/N) Σₗ sᵤ(l) · sᵥ(l) với mọi mẫu đã lưu l, trong đó u ≠ v
Khi hai nơ-ron có cùng trạng thái trong một mẫu (cùng +1 hoặc cùng −1), tích của chúng dương, làm mạnh thêm kết nối kích thích. Khi chúng trái ngược nhau, tích âm, tạo ra một kết nối ức chế. Tác động tích lũy ấy tạo nên một cảnh quan năng lượng với một thung lũng tại mỗi mẫu được lưu.
Quy tắc Hebbian mang tính cục bộ (mỗi lần cập nhật trọng số chỉ dùng thông tin có sẵn ở hai nơ-ron được kết nối) và tăng dần (có thể lưu mẫu mới mà không cần xử lý lại các mẫu cũ). Đáng chú ý, về mặt toán học có thể chứng minh rằng học Hebbian thực hiện phân tích thành phần chính (PCA) không giám sát trên dữ liệu đầu vào: mạng tự nhiên trích xuất những đặc trưng có ý nghĩa thống kê nhất từ môi trường của nó.
Năm 1997, Amos Storkey giới thiệu một quy tắc học cải tiến có tính đến trường cục bộ tại mỗi nơ-ron, đạt dung lượng lưu trữ lớn hơn so với học Hebbian chuẩn. Điều này cho thấy ngay cả trong cùng một kiến trúc, việc chọn thuật toán học vẫn có ý nghĩa sâu sắc: một nguyên lý vang vọng với bài học rộng hơn của nghiên cứu mạng nơ-ron.
Bước đột phá: "Hopfield Networks is All You Need"
Năm 2020, một nhóm do Hubert Ramsauer tại Đại học Johannes Kepler Linz dẫn dắt đã công bố một bài báo với tiêu đề đầy tính khiêu khích, vang vọng câu chuyện khởi nguồn của transformer: "Hopfield Networks is All You Need." Đóng góp của họ là chứng minh toán học cho điều mà nhiều người đã ngờ ngợ: cơ chế self-attention trong transformer chính xác là quy tắc cập nhật của một mạng Hopfield liên tục hiện đại.
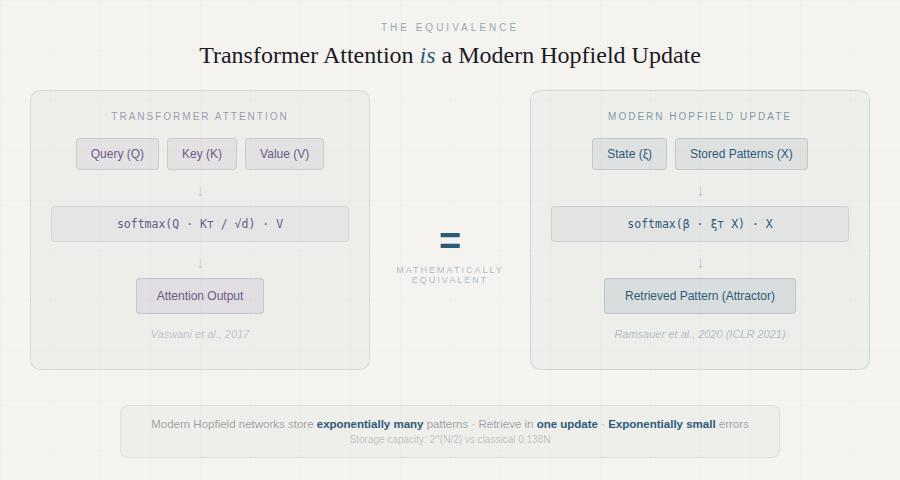
Mối liên hệ giữa mạng Hopfield hiện đại và cơ chế attention của transformer. Cơ chế attention dựa trên softmax trong transformer tương đương về mặt toán học với một bước cập nhật của mạng Hopfield liên tục có hàm năng lượng dạng mũ. Hình ảnh từ Ramsauer và cộng sự, "Hopfield Networks is All You Need."
Đây không chỉ là một phép so sánh. Nhóm nghiên cứu đã chỉ ra rằng, bằng cách khái quát hàm năng lượng Hopfield cổ điển sang các trạng thái liên tục và dùng một số hạng tương tác dạng mũ, quy tắc cập nhật thu được trở thành:
Z = softmax(β · R Wq Wk⊤ Y⊤) Y Wk Wv
đó chính xác là công thức attention của transformer. Mạng Hopfield hiện đại có thể lưu số lượng mẫu tăng theo hàm mũ (theo chiều của không gian liên tưởng), truy xuất chúng chỉ trong một lần cập nhật, và có sai số truy xuất nhỏ theo hàm mũ.
Bài báo xác định ba loại cực tiểu năng lượng trong khung lý thuyết hiện đại này: (1) một điểm cố định toàn cục lấy trung bình trên tất cả các mẫu đã lưu, (2) các trạng thái giả bền lấy trung bình trên các tập con của mẫu, và (3) các điểm cố định lưu từng mẫu riêng lẻ. Các đầu transformer ở các tầng thấp có xu hướng hoạt động theo chế độ lấy trung bình toàn cục, trong khi các đầu ở tầng cao hơn dùng trạng thái giả bền để thu thập và xử lý thông tin: một phát hiện mang lại cái nhìn sâu sắc về lý do transformer vận hành theo cách của chúng.
Hệ quả thực tiễn đến ngay lập tức: nhóm nghiên cứu đã phát hành các lớp Hopfield، dưới dạng các mô-đun PyTorch có thể thay thế trực tiếp các lớp pooling, lớp GRU/LSTM và các lớp attention chuẩn. Trong các bài benchmark, những lớp Hopfield này đạt kết quả hàng đầu hiện nay (state-of-the-art) ở bài toán phân loại kho miễn dịch (immune repertoire classification, với vài trăm nghìn mẫu cho mỗi tập), các bài toán học đa mẫu (multiple instance learning) và các bộ benchmark phân loại UCI, vốn là nơi các phương pháp học sâu truyền thống thường gặp khó khăn.
Đến tháng 12 năm 2025, một bài báo NeurIPS của Masumura và Taki đã đi xa hơn: họ chỉ ra rằng khi vượt ra ngoài "xấp xỉ đoạn nhiệt" (adiabatic approximation), ta sẽ thấy các trạng thái ẩn trong sự tương ứng giữa Hopfield và transformer. Những trạng thái này có thể giải quyết các vấn đề suy sụp hạng (rank collapse) và đồng nhất token đang làm khó các transformer sâu, giúp tăng độ chính xác mà không cần thêm bất kỳ tham số huấn luyện nào.
Sự đồng thuận ngày càng lớn: còn ai nói điều này nữa?
Lập luận rằng mạng Hopfield là mô hình kế tiếp sau transformer không phải là suy đoán. Các tổ chức nghiên cứu lớn đang tích cực theo đuổi hướng này, và bằng chứng đang tích lũy rất nhanh. Dưới đây là những tiếng nói và bài báo chính cùng hội tụ về một kết luận.
IBM Research và Dmitry Krotov
Tháng 1 năm 2025, IBM Research đã đăng một cuộc phỏng vấn dài với Dmitry Krotov, cộng sự lâu năm của Hopfield và là một trong những kiến trúc sư của Dense Associative Memory. Krotov nêu quan điểm rất thẳng: vì mạng Hopfield phản chiếu các vòng phản hồi hồi quy của bộ não, không như kiến trúc truyền thẳng (feedforward) của 90% mô hình AI hiện nay, nên chúng là "một lựa chọn đầy hứa hẹn thay cho các mạng truyền thẳng ngày nay". Ông chỉ ra rằng transformer chỉ xử lý thông tin theo một chiều, và khi cửa sổ ngữ cảnh dài ra, độ phức tạp tính toán tăng lên rất nhanh. Ngược lại, bộ não dùng các vòng phản hồi hồi quy để tóm tắt và lưu giữ thông tin quá khứ trong trí nhớ. Mạng Hopfield hoạt động theo cùng cách đó.
Krotov cũng đã nói về Energy Transformer (NeurIPS 2023), một dự án hợp tác giữa IBM Research và Georgia Tech. Nó không chỉ đưa các hiểu biết về Hopfield vào những transformer sẵn có, mà thay toàn bộ chuỗi các khối transformer truyền thẳng bằng một mô hình Associative Memory lớn duy nhất. Cơ chế attention trong Energy Transformer khác hẳn attention thông thường: nó được suy ra từ các nguyên lý đầu tiên của việc cực tiểu hóa năng lượng, chứ không phải được vá thêm vào một đường ống truyền thẳng.
🔗 IBM Research "Searching for brain-inspired AI algorithms" (tháng 1/2025)
🔗 Energy Transformer arXiv:2302.07253 (NeurIPS 2023)
Đại học Johannes Kepler - Nhóm của Hochreiter
Sepp Hochreiter, đồng phát minh ra LSTM, đã dẫn dắt nhóm công bố "Hopfield Networks is All You Need". Kho mã các lớp Hopfield của họ cung cấp các mô-đun PyTorch sẵn sàng cho môi trường production, có thể thay thế trực tiếp các lớp attention của transformer, các lớp pooling và các lớp hồi quy. Bài blog đi kèm trình bày chi tiết phép suy dẫn toán học cho thấy công thức softmax attention là một trường hợp đặc biệt của quy tắc cập nhật Hopfield hiện đại, và các lớp Hopfield còn mang lại những chức năng bổ sung mà attention chuẩn không có, trong đó có các nguyên mẫu tĩnh được học và các cấu hình bộ nhớ liên tưởng linh hoạt.
🔗 Hopfield Networks is All You Need - ICLR 2021
NeurIPS 2025: Hopfield Attention Improves GPT and Vision Transformers
Bằng chứng gần đây nhất đến từ bài báo NeurIPS tháng 12 năm 2025 của Masumura và Taki. Họ đã chỉ ra rằng Modern Hopfield Attention (MHA) bổ sung các trạng thái ẩn lấy từ động lực học Hopfield đầy đủ (không đoạn nhiệt), và cải thiện một cách có hệ thống cả mô hình ngôn ngữ GPT-2 và LLaMA lẫn Vision Transformer. Những cải tiến này không cần thêm bất kỳ tham số huấn luyện nào. Quan trọng hơn, người ta nhận thấy MHA giải quyết được vấn đề suy sụp hạng (rank collapse) (khi các ma trận attention trong transformer sâu bị suy biến, khiến mọi token hội tụ về những biểu diễn gần giống nhau), một bệnh lý cơ bản đã làm khó các nỗ lực mở rộng quy mô transformer. Các tác giả kết luận: "Chúng tôi hy vọng nghiên cứu này sẽ mở ra những khả năng mới cho việc thiết kế kiến trúc Transformer một cách có hệ thống bằng mạng Hopfield."
🔗 On the Role of Hidden States of Modern Hopfield Network in Transformer arXiv:2511.20698 (NeurIPS 2025)
Nature Communications: học trực tuyến phù hợp với sinh học
Tháng 5 năm 2024, Nature Communications đăng công trình về Sparse Quantized Hopfield Network một mô hình học bằng các quy tắc học cục bộ trong các tình huống học liên tục trực tuyến, đúng theo cách bộ não sinh học vẫn làm. Điều này giải quyết một hạn chế căn bản của transformer, vốn đòi hỏi lan truyền ngược không cục bộ và huấn luyện ngoại tuyến trên các tập dữ liệu đã được tuyển chọn. Bài báo xem các kiến trúc dựa trên Hopfield là cây cầu tự nhiên nối mạng nơ-ron nhân tạo với phần cứng điện toán neuromorphic.
🔗 A Sparse Quantized Hopfield Network for Online-Continual Memory Nature Communications (2024)
Outlier-Efficient Hopfield Layers for Large Foundation Models
Một bài báo năm 2024 xử lý một vấn đề thực tế trong các mô hình transformer lớn: xu hướng dồn attention vào những token không mang thông tin (dấu phân cách, dấu câu), tức vấn đề "no-op outlier". Giải pháp của họ là một hàm năng lượng Hopfield hiệu quả với giá trị ngoại lai (outlier-efficient) phân loại các token này và dẫn chúng về điểm năng lượng bằng không, để chúng không làm loãng phần attention hữu ích. Mô hình thu được bao hàm attention Softmax₁ như một trường hợp đặc biệt và đã được kiểm chứng trên BERT, OPT và Vision Transformer. Đây là lý thuyết Hopfield giải quyết những bài toán kỹ thuật transformer của thế giới thực.
🔗 Outlier-Efficient Hopfield Layers for Large Transformer-Based Models (2024)
Transformer như bộ cực tiểu hóa năng lượng (tháng 1 năm 2026)
Công trình lý thuyết mới nhất, công bố vào tháng 1 năm 2026, xem toàn bộ lượt lan truyền thuận của transformer như một quá trình cực tiểu hóa năng lượng nội tại, hoàn toàn chọn góc nhìn Hopfield làm khung giải thích vì sao transformer hoạt động được. Bài báo nối các mô hình Hopfield hiện đại thưa với cả họ các biến thể attention (softmax, sparsemax, α-entmax), cho thấy tất cả đều là các trường hợp đặc biệt của động lực truy hồi dựa trên năng lượng.
🔗 Transformers as Intrinsic Optimizers: Forward Inference through the Energy Principle (tháng 1 năm 2026)
Các bài tổng quan và tài nguyên cộng đồng
Cộng đồng nghiên cứu rộng hơn đang tập hợp quanh sự hội tụ này:
- "Energy-Based Learning and the Evolution of Hopfield Networks" (TechRxiv, tháng 4 năm 2025) Một bài tổng quan toàn diện lần theo cả chặng đường từ Hopfield (1982) qua Máy Boltzmann đến việc diễn giải lại attention của transformer như động lực học Hopfield hiện đại. → Đọc bài báo
- "An Energy-Based Perspective on Attention Mechanisms in Transformers" Một bài blog kỹ thuật chuyên sâu lập luận rằng hiểu transformer qua lăng kính năng lượng Hopfield "có thể dẫn đến những cải tiến khác biệt về chất, vượt xa những gì có thể đạt được nếu chỉ dựa vào việc mở rộng quy mô và giảm độ phức tạp tính toán." → Đọc bài viết trên blog
- Awesome Modern Hopfield Networks Một kho GitHub được tuyển chọn, theo dõi hơn 50 bài báo về mạng Hopfield hiện đại trong nhiều lĩnh vực: phân bổ tài sản, phát hiện thay đổi, tái dựng tư duy sáng tạo, phát hiện dữ liệu ngoài phân phối, phân loại repertoire miễn dịch, và nhiều hơn nữa. → Khám phá bộ sưu tập
- "Is Hopfield Networks All You Need?" (Analytics India Magazine, tháng 12/2024) Bài viết hướng đến người làm thực tế, trình bày cách nhóm của Hochreiter chứng minh rằng mạng Hopfield có thể "thay thế lẫn nhau với các mô hình transformer tiên tiến nhất." → Đọc bài báo
- "New Research in Hopfield Networks: A Short Intro" (Medium, tháng 7/2024) Bài tổng quan dễ tiếp cận, lưu ý rằng dung lượng lưu trữ đã tăng từ 0,138N lên 2^(N/2) nhờ các hàm kích hoạt dạng mũ. → Đọc trên Medium
Xu hướng đã rất rõ ràng. Đây không phải đề xuất của riêng một phòng thí nghiệm hay phỏng đoán của riêng một bài báo. IBM Research, Đại học Johannes Kepler, MIT, NeurIPS, Nature Communications và cả cộng đồng học máy đang cùng đi đến một kết luận từ nhiều hướng khác nhau: mô hình bộ nhớ liên kết dựa trên năng lượng mà Hopfield đặt nền móng không chỉ là nền tảng mà transformer đã vô tình được xây dựng trên đó, mà còn là khung nền sẽ đưa AI vượt xa những gì riêng transformer có thể đạt được.
Vì sao điều này quan trọng ngay lúc này: lý do nên chuyển đổi
Hội tụ được đảm bảo cho các hệ thống an toàn tối quan trọng
Transformer tạo ra kết quả đầu ra, nhưng không có bảo đảm toán học nào về tính ổn định. Mạng Hopfield hội tụ về các trạng thái ổn định bằng chứng minh toán học hàm năng lượng giảm đơn điệu. Với robot, xe tự hành, thiết bị y tế và mọi hệ thống mà độ tin cậy là điều không thể thỏa hiệp, đây là một yêu cầu mà transformer không thể đáp ứng.
Bộ nhớ liên kết là năng lực cốt lõi
Nếu bạn huấn luyện một mạng Hopfield sao cho trạng thái (1, −1, 1, −1, 1) là một cực tiểu năng lượng, rồi đưa vào đầu vào bị lỗi (1, −1, −1, −1, 1), mạng sẽ hội tụ về đúng mẫu đã lưu. Nó không đoán mò hay nội suy nó lăn xuống dốc trong bề mặt năng lượng để đến điểm hút gần nhất. Với robot có cảm biến bị che khuất, hệ thống nhúng có dữ liệu nhiễu, và mọi ứng dụng cần hoàn thiện mẫu từ đầu vào không đầy đủ, đây là một bước chuyển mang tính đột phá.
Một động cơ tối ưu hóa phổ quát
Năm 1985, Hopfield và David Tank đã chứng minh rằng mạng Hopfield có thể giải bài toán người bán hàng rong. Nếu một hàm chi phí có thể viết dưới dạng năng lượng Hopfield, thì các điểm cân bằng của mạng chính là lời giải. Kể từ đó, kiến trúc này đã được áp dụng cho lập lịch xưởng sản xuất, phân bổ kênh trong mạng không dây, phục hồi ảnh, chuyển đổi tương tự sang số, định tuyến di động và tối ưu hóa tổ hợp. Một bài báo năm 2024 trên Nature Communications đã giới thiệu Sparse Quantized Hopfield Network dùng cho học bộ nhớ liên tục trực tuyến với các quy tắc cục bộ, theo cách giống như bộ não sinh học, một khả năng mà về bản chất transformer không có.
Phần cứng biết suy nghĩ mà không cần phần mềm
Ràng buộc trọng số đối xứng (wᵢⱼ = wⱼᵢ) ánh xạ trực tiếp lên các mạch điện tử tương tự một kết nối điện trở vốn dĩ có tính đối xứng. Mạng Hopfield có thể được chế tạo thành ASIC hoặc FPGA với suy luận ở thang thời gian nano giây. Tuyển tập năm 2025 của Nature về điện toán neuromorphic khẳng định hướng đi này: phần cứng tương tự tiết kiệm năng lượng thực thi động lực học thần kinh ngay tại biên, với bộ nhớ định địa chỉ theo nội dung không cần GPU, không cần CPU và không cần ngăn xếp phần mềm.
Các chip AI neuromorphic và analog triển khai trực tiếp động lực học của mạng nơ-ron ngay trong phần cứng. Cấu trúc đối xứng, dựa trên năng lượng của mạng Hopfield ánh xạ tự nhiên lên các mạch điện trở, cho phép suy luận AI ở thang thời gian nano giây mà không cần các tầng phần mềm truyền thống.
Linh hoạt giữa nhị phân và liên tục
Mạng Hopfield cổ điển dùng nơ-ron nhị phân (+1 hoặc −1); các biến thể liên tục dùng hàm kích hoạt sigmoid và phương trình vi phân. Việc cập nhật có thể bất đồng bộ (mỗi lần một nơ-ron, đảm bảo hội tụ) hoặc đồng bộ (tất cả cùng lúc, cho phép xử lý song song). Cùng một kiến trúc này thích ứng được từ vi điều khiển chỉ có vài kilobyte RAM đến FPGA song song quy mô lớn, và giờ đây, nhờ các lớp Hopfield hiện đại, cả với các quy trình học sâu tăng tốc bằng GPU.
Dung lượng lưu trữ: Giới hạn thẳng thắn
Giới hạn của mạng cổ điển rất rõ ràng: một mạng gồm N nơ-ron có thể lưu trữ đáng tin cậy khoảng 0,138N mẫu trước khi các trạng thái giả làm suy giảm khả năng truy hồi. Đây là một ràng buộc có thật, nhưng là một ràng buộc thẳng thắn. Transformer không có một chặn trên toán học rõ ràng cho thời điểm chúng bắt đầu "ảo giác".
Hơn nữa, các mạng Hopfield hiện đại (Krotov & Hopfield, 2016; Demircigil và cộng sự, 2017) đạt được dung lượng lưu trữ theo hàm mũ nhờ các số hạng tương tác bậc cao. Nghiên cứu vẫn tiếp tục mở rộng những ranh giới này: mạng Hopfield thưa và có cấu trúc, bộ nhớ Hopfield cho chuỗi dài, và mạng Hopfield cho phân bổ tài sản đều là những mảng đang phát triển sôi nổi, với số lượng bài báo tăng nhanh.
Triển khai thực tế: Từ máy tính đến mạch điện
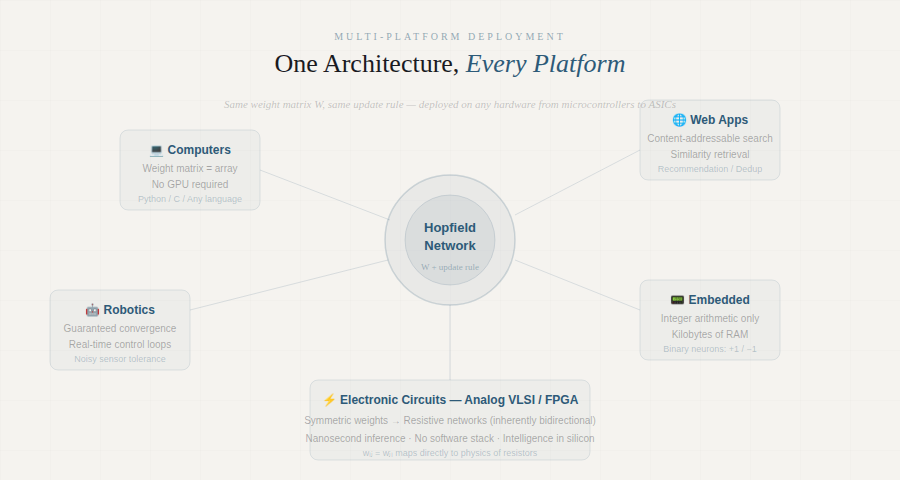
Tầm nhìn ban đầu của những nhà nghiên cứu mạng nơ-ron đầu tiên rất rõ ràng: một khuôn khổ chỉ cần mô tả một lần và triển khai ở mọi nơi. Kiến trúc của Hopfield hiện thực hóa điều đó:
Ứng dụng máy tính Một ma trận trọng số và một quy tắc cập nhật. Không cần GPU.
Ứng dụng internet Bộ nhớ định址 theo nội dung cho tìm kiếm tương tự, gợi ý và loại bỏ trùng lặp.
Robot Hội tụ được đảm bảo cho các vòng điều khiển thời gian thực. Các mẫu chuyển động của động cơ được lưu như các điểm hút, và được gợi lại ngay cả từ đầu vào cảm biến nhiễu.
Hệ thống nhúng Mạng Hopfield nhị phân chạy trên vi điều khiển chỉ bằng phép tính số nguyên.
Mạch điện tử Các trọng số đối xứng ánh xạ lên mạng điện trở. Trí tuệ được chế tạo thẳng trong silicon.
Con đường phía trước
Kỷ nguyên transformer đã trao cho chúng ta những cỗ máy ngôn ngữ phi thường. Nhưng biên giới đang mở rộng sang thế giới vật lý: robot, cảm biến, bộ truyền động và các quyết định thời gian thực. Biên giới ấy đòi hỏi những kiến trúc ổn định, hiệu quả, dễ diễn giải và triển khai được trên phần cứng thực sự tồn tại ở rìa mạng.
Chứng minh năm 2020 rằng cơ chế chú ý của transformer chính là một quy tắc cập nhật Hopfield hiện đại không chỉ là một tò mò toán học: nó cho thấy từ trước đến nay chúng ta vẫn luôn dùng mạng Hopfield, chỉ là được bọc trong một khuôn khổ che khuất bản chất thật của chúng. Công trình NeurIPS 2025 chỉ ra rằng các trạng thái ẩn Hopfield giải quyết những bệnh lý của transformer như suy sụp hạng (rank collapse) gợi ý bước tiếp theo: không phải vá transformer bằng các hiểu biết từ Hopfield, mà là xây dựng trực tiếp trên chính mô hình Hopfield.
John Hopfield đã chỉ ra con đường từ năm 1982. Donald Hebb đặt nền móng sinh học từ năm 1949. Giờ đây cộng đồng nghiên cứu đang hội tụ về hướng này.
Đã đến lúc chuyển đổi.
Tài liệu tham khảo
- Hopfield, J.J. (1982). "Neural networks and physical systems with emergent collective computational abilities." PNAS, 79(8), 2554–2558.
- Hebb, D.O. (1949). The Organization of BehaviorWiley.
- Ramsauer, H. et al. (2020). "Hopfield Networks is All You Need." ICLR 2021. arXiv:2008.02217
- Krotov, D. & Hopfield, J.J. (2016). "Dense Associative Memory for Pattern Recognition." NeurIPS.
- Storkey, A. (1997). "Increasing the capacity of a Hopfield network without sacrificing functionality." ICANN.
- Hoover, B., Krotov, D. et al. (2023). "Energy Transformer." NeurIPS 2023. arXiv:2302.07253
- Masumura, T. & Taki, M. (2025). "On the Role of Hidden States of Modern Hopfield Network in Transformer." NeurIPS 2025. arXiv:2511.20698
- Alonso, N. & Krichmar, J. (2024). "A sparse quantized Hopfield network for online-continual memory." Nature Communications, 15, 3722. nature.com
- Hu, J.Y. et al. (2024). "Outlier-Efficient Hopfield Layers for Large Transformer-Based Models." arXiv:2404.03828
- Hu, J.Y. et al. (2026). "Transformers as Intrinsic Optimizers: Forward Inference through the Energy Principle." arXiv:2511.00907
- Hopfield, J.J. & Tank, D.W. (1985). "'Neural' Computation of Decisions in Optimization Problems." Biological Cybernetics, 52, 141–152.
- Bruck, J. (1990). "On the convergence properties of the Hopfield model." Proceedings of the IEEE.
- Krotov, D. (2025). "Searching for brain-inspired AI algorithms." IBM Research Blog. research.ibm.com
- "Energy-Based Learning and the Evolution of Hopfield Networks." TechRxiv, tháng 4 năm 2025. techrxiv.org

